

НТО Юниоры 2026/27
Книга помогает школьнику самостоятельно подготовиться к отборочному этапу сферы «ИИтех» Национальной технологической олимпиады «НТО Юниоры»: теория с нуля, подробные разборы задач и задачи для самопроверки с ответами.
Большинство задач составлены автором по образовательной программе сферы, часть – по мотивам открытых заданий прошлых лет; источник указан у каждой задачи. Уровни сложности – шкала этой книги, а не баллы олимпиады. Правила, сроки и формат отбора – на сайте junior.ntcontest.ru.
Версия 1.0 от 02.10.2026, сборка 02.10.2026. © Артём Осиновский, 2026.
Как устроена эта книга
Эта книга – тренажёр для отборочного этапа сферы «ИИтех» олимпиады «НТО Юниоры». Здесь есть всё, чтобы готовиться самостоятельно: теория с нуля, подробные разборы задач и похожие задачи для самопроверки с ответами в конце книги. Мощный компьютер и знакомый программист не нужны: половина задач решается на бумаге, остальное – в браузере и в бесплатных программах сферы.
Для кого эта книга
- Для школьников 5–7 классов, которые выбрали (или думают выбрать) сферу «ИИтех».
- Для тех, кто ни разу не программировал и не знает, как устроена нейросеть. Каждая тема начинается с самого начала, а первый код мы разбираем построчно.
- Для наставников и родителей, которые хотят помочь. Для них есть отдельный раздел в конце введения.
Как устроен отбор
| Когда | Что происходит |
|---|---|
| до 9 ноября | регистрация на олимпиаду (наш совет – успеть до 20 октября, тогда будут обе попытки) |
| 20–30 октября | отбор, попытка 1 (3 часа) |
| 31 октября – 10 ноября | отбор, попытка 2 (засчитывают лучшую из двух) |
| 7–17 декабря | финалы в регионах |
- Отбор проходит дома, онлайн, с компьютера. Задания открываются в личном кабинете на my.ntcontest.ru и решаются на платформе «Орбита» (orbita.education). Каждый решает сам за себя.
- Задания – это задачи с ответом: ввести число, выбрать верные варианты, сопоставить, расставить шаги по порядку, прочитать график или таблицу и сделать вывод.
- Разработчик сферы на ознакомительном вебинаре 2026 года сказала: в образовательном курсе изложен весь материал, который ждёт на отборе и в финале, и ничего нового на отборе не будет. Поэтому книга построена по программе сферы «Основы искусственного интеллекта и анализа данных».
- На вебинаре для наставников в сентябре 2026 года разработчики описали путь, по которому идут и курс, и отбор, и финал: понять задачу, записать её на языке математики, получить данные, исследовать их, построить модель и оценить, насколько хорошо она работает. Главы книги идут в том же порядке.
- В курсе, на отборе и в финале сферы используются инструменты, где программу собирают из блоков, без набора кода. Писать на Python с нуля от тебя не потребуют. Но Python прямо назван на странице сферы в списке того, что пригодится, а в блочном инструменте курса за каждым блоком стоит строчка на Python. Поэтому в книге есть глава про Python.
- За тест бесплатного курса своей сферы дают +5 баллов. Курс – на academy.junior.online, вход через «Талант». Бонус нужно включить самому в личном кабинете («Мои привилегии») до конца отбора. Учти: после этого сферу уже не поменять.
- Финал – командный и очный: команда из двух-трёх человек около трёх часов решает задачи на компьютерах, на той же «Орбите». Команду можно собрать заранее, а можно прямо на месте.
Совет. Сроки и правила могут уточняться. Главный источник – сайт олимпиады junior.ntcontest.ru и памятка для Новосибирской области nto.kvantorium54.ru.
Что пригодится на отборе и где это в книге
На странице сферы перечислено, что пригодится на отборе. Вот где это в книге:
| Что пригодится на отборе | Глава |
|---|---|
| Базовые понятия ИИ на уровне определений | 1. Что такое искусственный интеллект |
| Математика: множества и логика | 2. Множества и логика |
| Математика: комбинаторика (и вероятность – из программы сферы) | 3. Комбинаторика и вероятность |
| Математика: уравнения, выражения с переменными; поиск закономерностей | 4. Закономерности, последовательности, уравнения |
| Информатика: информация и информационные процессы | 5. Данные: собираем и наводим порядок |
| Визуализация данных, графики по таблицам, умение читать графики и делать выводы | 6. Графики и анализ данных |
| Нейросети: классификация, регрессия, точность модели (из программы сферы) | 7. Нейросети своими руками |
| Основы программирования (Python); обработка текстовой информации | 8. Python, диалоги и промпты |
Главы 1–4 можно читать в любом порядке, для них хватит тетради и карандаша. Главы 5, 6 и 7 лучше читать подряд: в пятой мы собираем данные и наводим в них порядок, в шестой смотрим на них глазами, в седьмой учим на них нейросеть. Главу 8 можно начать когда угодно. Если ты ни разу не писал программ, загляни сначала в мини-шпаргалку Python в конце книги: код встречается уже в главах 5 и 6.
Как пользоваться книгой
В каждой главе теория и разборы идут вперемешку: за каждым разбором сразу следуют две похожие задачи «Реши сам» – чтобы закрепить приём, пока он свежий в голове, не долистывая до конца главы.
- Теория. Коротко и по делу, с рисунками. Каждая новая тема начинается с большой картинки «на пальцах», а самое важное собрано в рамках «Запомни». Все «Запомни» из всех глав повторяются в конце книги, в шпаргалке.
- Разбираем задачи. Задачи такие же, как на отборе, и к каждой – решение по шагам: что дано, что делаем и почему, где обычно ошибаются, какой ответ получился и похож ли он на правду.
- Реши сам. Сразу после разбора – две похожие задачи для самостоятельного решения, тем же приёмом, но с другими числами.
- Ответы – в конце книги, в разделе «Ответы и решения». Там только ответ, иногда – короткая подсказка, если задача с подвохом; полного решения нет специально: если подсказки не хватило, вернись к разбору перед задачей.
Не готов читать всю главу целиком? Есть отдельная короткая книжка «Быстрый старт» (около 50 страниц): из каждой главы главное, один разбор и несколько задач «Реши сам». Её удобно пройти за неделю, а эту книгу держать под рукой.
У каждой задачи есть уровень – как в обычном задачнике: у трудных задач звёздочка рядом с номером («задача 3*»), лёгкие подписаны словом «разминка». Отдельных значков и таблицы уровней в книге нет.
Звёздочка и «разминка» – это уровни нашей книги, а не баллы олимпиады. Сколько задач будет на отборе и сколько баллов стоит каждая, заранее не объявляют.
Совет. Разбор читай с листком бумаги. Закрой решение, попробуй решить сам, а потом сверяйся по шагам. Так ты запомнишь в три раза больше, чем если просто прочитаешь.
У каждой задачи внизу написано, откуда она взялась: «по мотивам задачи отборочного этапа» – значит, похожая задача была на отборе прошлых лет (мы пересказали её своими словами и поменяли числа), «своя задача по программе сферы» – значит, мы придумали её по теме из программы 2026/27 года. Программа сферы сама предлагает такой приём: решить знакомую задачу с другими входными данными. Если ты справился с задачей из разбора, а потом с обеими задачами «Реши сам», – тему ты понял.
Как вводить ответы на отборе
Так было на отборочных этапах прошлых лет. На «Орбите» перед каждой задачей читай инструкцию: там сказано, в каком виде нужен ответ.
- Только число, без единиц измерения и без знака процента, если не сказано иначе.
- Дробную часть на сайте обычно отделяют точкой:
0.85, а не0,85. В книге мы пишем по-русски, через запятую. - Доля или проценты? Точность модели 85 % можно записать как
85и как0.85. Смотри, что просит условие. - Округляй так, как сказано в условии. «До сотых» – два знака после точки. Промежуточные результаты не округляй – только ответ.
- «Сколько способов» – всегда целое число. Если получилось 12,5 варианта, ошибка где-то раньше.
- У каждого могут быть свои числа. В некоторых задачах условие или набор данных генерируется для каждого участника отдельно, так что списать ответ не выйдет.
- Попытки ограничены. Сначала реши на бумаге или проверь программу в онлайн-Python, и только потом вводи ответ.
Что понадобится
- Тетрадь в клетку, карандаш, линейка – для глав 1–4, кругов и таблиц.
- Калькулятор. Хватит обычного на телефоне: проценты, дроби, умножение.
- Компьютер с интернетом и браузером – для глав 5–8. Планшета мало: программы курса ставятся на компьютер (в программе сферы указан Windows 10 или новее). GraphNet и Датавиз-конструктор выпускают только для Windows.
- Python – любой онлайн-интерпретатор, ничего ставить не нужно. Для глав про данные и графики удобнее Google Colab (colab.research.google.com): там уже есть библиотеки для таблиц и графиков. Полистать готовые примеры можно и так, а чтобы запустить код, нужен аккаунт Google.
- Сервисы из программы сферы, по мере того как до них дойдёт курс:
- GraphNet – конструктор нейросетей из блоков;
- Датавиз-конструктор – графики, дашборды и «вычислительные эссе»;
- Teachable Machine и Machine Learning for Kids – модели, которые учатся на твоих картинках и звуках без программирования;
- CodeChef (codechef.ru) – блочная среда, в которой в курсе сферы собирают программу сбора данных: блоки HTTP, Pandas, списки, переменные; проект сохраняется файлом «.chef»;
- Scratch – дополнительный материал кружка, не часть курса: в нём можно встроить обученную модель в свою программу;
- ИИ-чаты GigaChat и Алиса – для главы про промпты (со взрослым, см. ниже).
Где скачать GraphNet и Датавиз-конструктор и как их поставить, рассказывают в курсе сферы – ссылки собраны в справочнике в конце книги.
CodeChef: программа из блоков
CodeChef (codechef.ru) – бесплатный конструктор программ: их не печатают, а собирают из цветных блоков, как из деталей. Справа тут же виден настоящий код на Python, который получился. В курсе сферы в CodeChef собирают программу сбора данных (модуль 5 «Данные», шаг 5 и задачи 4–5). Ниже – как начать и четыре задачи: от «привет» до сбора таблицы по страницам. Рамка с номером на картинке – куда смотреть и куда нажимать.
Шаг 1. Открыть. Зайди на codechef.ru: страница открывается сразу, входить и регистрироваться не нужно. Python работает прямо в твоём браузере (мы проверяли в Chromium – на нём построены Chrome, Яндекс Браузер и Edge). Он загружается при открытии страницы, это несколько секунд; во время запуска вверху справа горит «Выполняется».
Шаг 2. Окно программы.
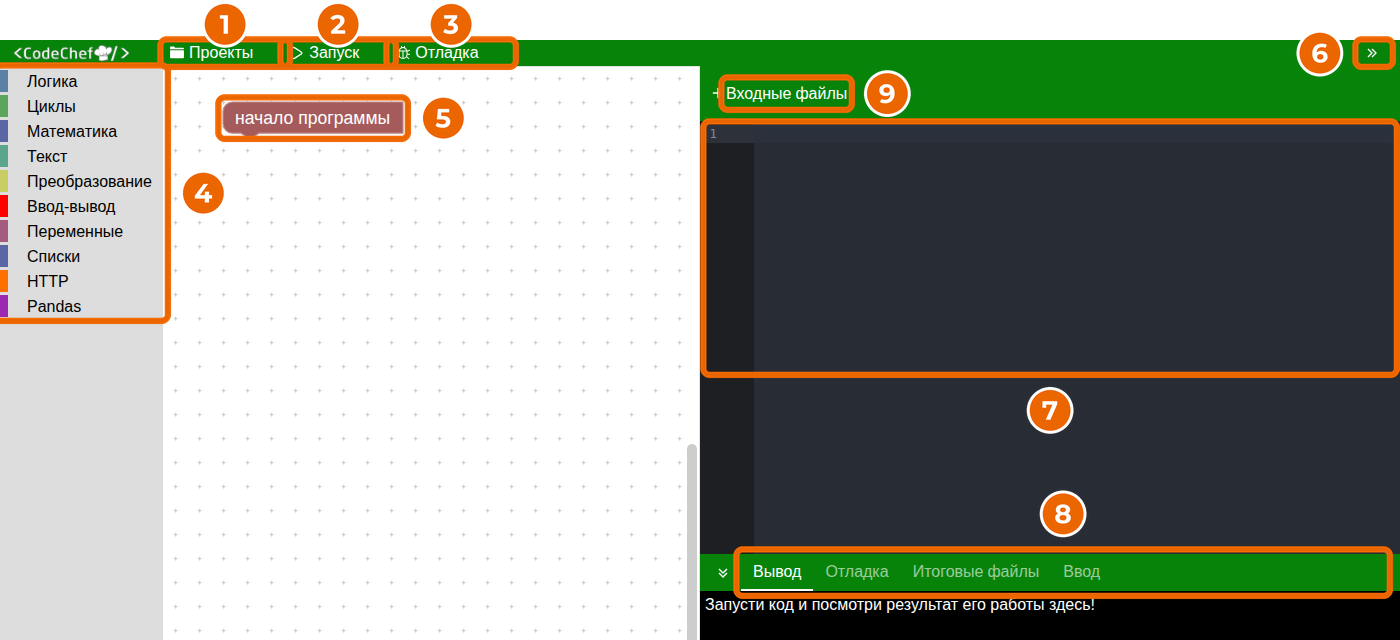
- «Проекты» – меню: «Открыть», «Создать проект», «Сохранить» (шаг 6).
- «Запуск» – запустить программу. Что она напечатала, видно на вкладке «Вывод» (8).
- «Отладка» – запуск по шагам: видно, как меняются переменные (задача П.3).
- Палитра блоков, десять групп: «Логика», «Циклы», «Математика», «Текст», «Преобразование», «Ввод-вывод», «Переменные», «Списки», «HTTP», «Pandas». Щёлкни по названию – рядом откроются блоки группы.
- Рабочее поле. На нём уже лежит блок «начало программы» – с него всё начинается. Блок, который ни к чему не прицеплен, в код не попадает.
- Двойная стрелка – спрятать правую часть окна (код и вывод) или показать её снова. Когда блоки не помещаются в ширину, спрячь её: поле станет во всё окно.
- Код на Python. Он сам меняется вместе с блоками; печатать в нём нельзя.
- Вкладки: «Вывод» – что напечатала программа; «Отладка» – переменные при пошаговом запуске; «Итоговые файлы» – файлы, которые создала программа; «Ввод» – ответы на вопросы программы.
- «Входные файлы» – добавить с компьютера файл
.txt,.jsonили.csvдля программы. В задачах ниже не нужен.
Шаг 3. Как ставить блоки. Открой группу, например «Ввод-вывод» (1 на левой половине), и перетащи блок мышью – берись за его левый край, а не за поле внутри. Блок-команду (с выемкой сверху и выступом снизу) подноси к нижнему краю предыдущего: он защёлкивается. Блок-значение (с выступом слева – число, текст, переменная, вычисление) вставляют в белое гнездо другого блока.
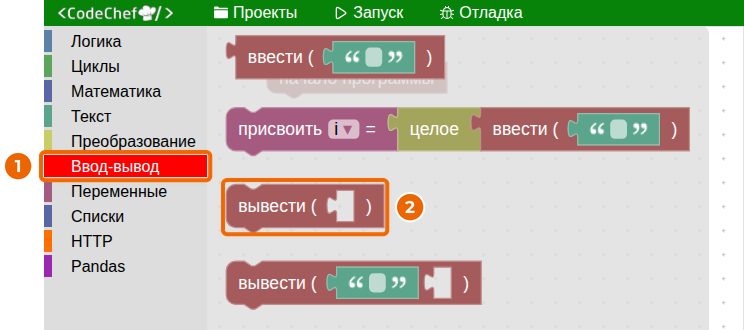
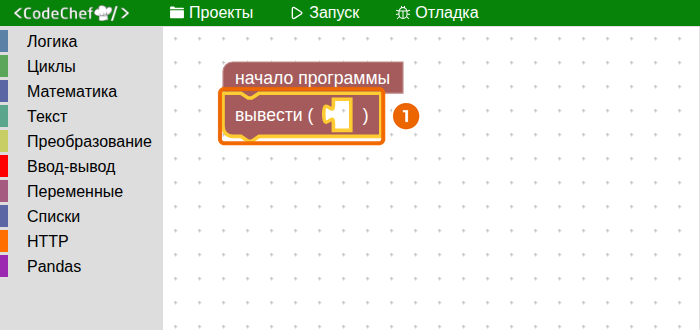
- Число или слово в блоке меняют щелчком по полю: щёлкни, впиши, нажми Enter. Стрелка ▾ открывает список – выбери нужное.
- Блок не защёлкнулся – он чуть отъезжает и висит сам по себе. Перетащи его ещё раз.
- Блок тянет за собой всё, что под ним. Лишний блок: щёлкни по нему и нажми Delete.
- Поле двигают мышью за пустое место. Если в углу всплыла английская подсказка «Use → to navigate inside of blocks» – закрой её крестиком, на программу она не влияет.
Шаг 4. Переменные. Переменная – это коробочка с именем, в которую программа кладёт число, слово или список. В группе «Переменные» нажми «Создать переменную…», впиши имя и нажми Enter.
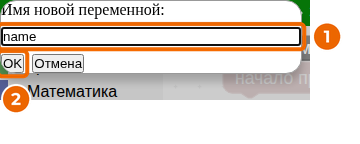
Имя пиши латиницей: name, total, marks. Русские буквы CodeChef превращает в код вида _D0_BE_D1_86…: программа работает, но читать её и смотреть переменные при отладке невозможно. В группе три блока: «присвоить … =» (положить значение), «увеличить … на» и блок с самим именем (взять значение).
Шаг 5. Ввод и запуск. Ответы на вопросы программа берёт не из окна, а с вкладки «Ввод»: впиши их заранее, по одному в строке (1 – вкладка, 2 – поле). Потом нажми «Запуск» вверху и смотри результат на вкладке «Вывод».
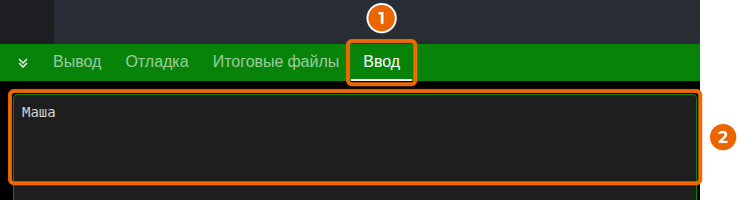
Если ответов меньше, чем вопросов, программа остановится с сообщением EOFError: EOF when reading a line – допиши строки. Если там, где нужно число, стоит слово, будет ValueError: invalid literal for int() – впиши цифры. Зависшую программу (например, бесконечный цикл) останавливает крестик вверху справа, рядом с надписью «Выполняется».
Шаг 6. Сохранить и открыть. Всё, что ты собрал, живёт только на этой странице: обновил её или закрыл вкладку – поле пустое. Поэтому сохраняйся.
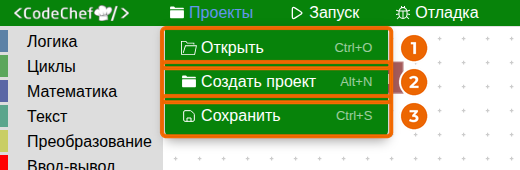
«Сохранить» (3) скачивает файл project.chef: переименуй его, чтобы не перепутать с другими. «Открыть» (1) просит выбрать такой файл – так открывают и проект, который дают в курсе. «Создать проект» (2) очищает поле и сначала переспрашивает: «Все несохранённые изменения будут потеряны».
Задача П.1. Привет. Программа спрашивает имя и здоровается. Создай переменную name. Из «Переменных» возьми «присвоить … =», поставь под «начало программы» и выбери в списке name. Из «Ввод-вывод» возьми верхний блок «ввести ( )» и вставь его в гнездо справа от «=»; в кавычках впиши вопрос Как тебя зовут? (пробел в конце оставь, чтобы ответ не слипся с вопросом). Под ним поставь блок «вывести» с текстом и пустым гнездом, впиши Привет,, а в пустое гнездо вставь блок name из «Переменных».
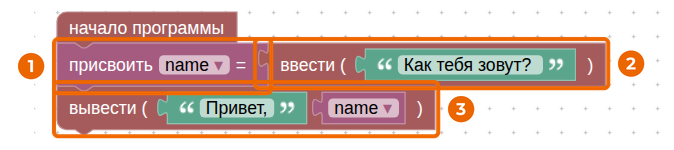
Открой вкладку «Ввод», впиши любое имя и нажми «Запуск».
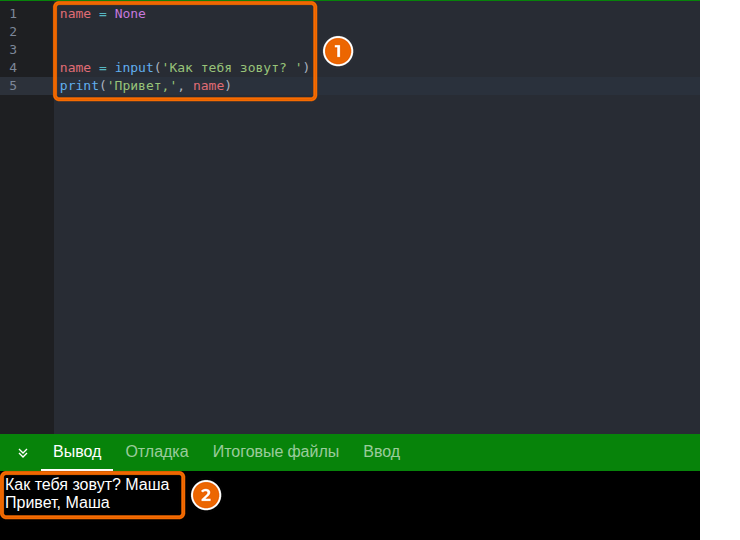
Что должно получиться: в «Вывод» две строки – Как тебя зовут? Маша (твоё имя после вопроса) и Привет, Маша. В коде справа – name = input('Как тебя зовут? ') и print('Привет,', name). Впиши другое имя и запусти ещё раз: вторая строка изменится.
Задача П.2. Оценки: сколько, сумма, среднее. Программа просит три оценки, складывает их в список и считает. Создай переменные marks (список), total (сумма) и x (очередная оценка). Собирай по кадру сверху вниз.
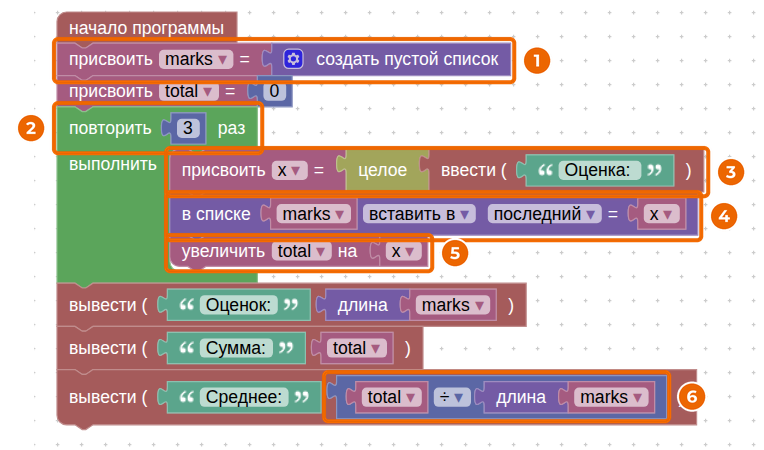
- «присвоить
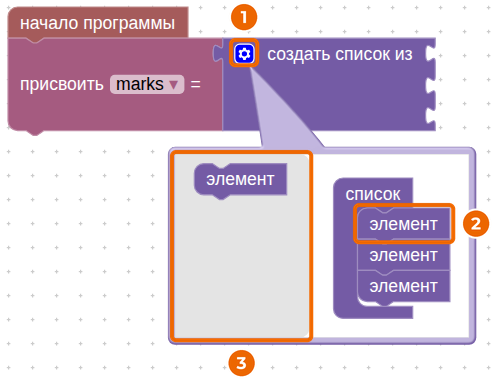
marks=» и блок «создать список из» из группы «Списки». Нужен пустой список, поэтому нажми на шестерёнку и потяни верхний «элемент» в правой части влево, в серое поле: вместе с ним уйдут и нижние, а надпись станет «создать пустой список».
Под ним – «присвоить total =» с числом 0 из «Математики». (2) Из «Циклов» – «повторить … раз» и число 3 (первый блок «Математики» – впиши в него 3). Внутрь, в «выполнить», ставь по очереди три блока. (3) Из «Ввод-вывод» – второй блок, «присвоить … = целое ввести ( )»: выбери в нём x и впиши вопрос Оценка:. Слово «целое» превращает ответ в число. (4) Из «Списков» – «в списке … присвоить № … =»: выбери «вставить в» и «последний», слева поставь marks, справа x – оценка ляжет в конец списка. (5) «увеличить total на»: выбери total, а число 1 замени блоком x.
После цикла – три блока «вывести». Первый: текст Оценок: и блок «длина» из «Списков» со списком marks. Второй: Сумма: и total. Третий (6): Среднее: и блок «+» из «Математики» – выбери в нём ÷, слева поставь total, справа «длину» списка marks.
На вкладке «Ввод» впиши три строки: 5, 4, 3 – и нажми «Запуск».
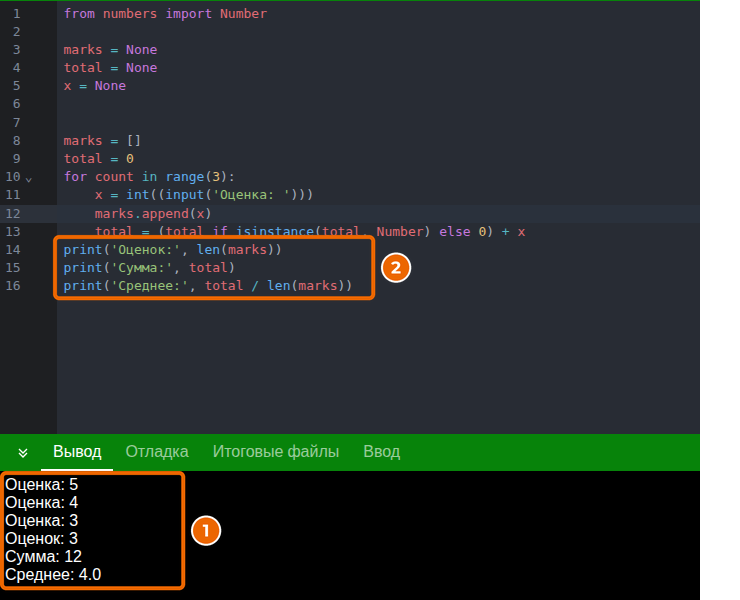
Что должно получиться: Оценок: 3, Сумма: 12, Среднее: 4.0. Попробуй 5, 5, 4: сумма 14, а среднее – 4.666666666666667. Длинный хвост – это нормально, округлять здесь нечем. Проверь себя: 5 + 4 + 3 = 12, 12 : 3 = 4.
Задача П.3. Копилка. В копилке 0 рублей, каждый день в неё кладут 15. Через сколько дней накопится хотя бы 100? Создай money и days, обеим дай значение 0 («присвоить … =», число 0). Из «Циклов» возьми «повторять, пока» и вставь в его гнездо блок сравнения из «Логики»: выбери в нём знак <, слева money, справа число 100. Внутрь цикла поставь два блока «увеличить»: money на 15 (число 1 замени на 15) и days на 1. После цикла выведи Дней: с days и В копилке: с money.
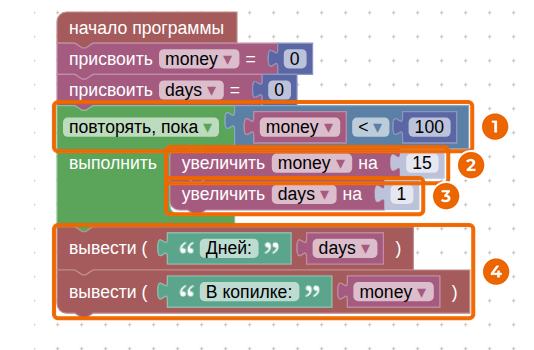
Что должно получиться: Дней: 7 и В копилке: 105. Проверь пальцем: за 6 дней накопится 90 – это ещё меньше 100, значит нужен седьмой. Если вместо 15 по ошибке оставить 0, копилка не растёт и цикл не кончится никогда – останови его крестиком вверху справа.
Теперь посмотри, как цикл крутится. В узкой колонке слева от кода, правее номеров строк, щёлкни напротив строки days = … – появится красная точка (1): здесь программа остановится. Нажми «Отладка» вверху и открой вкладку «Отладка»: в таблице будут money и days (2). «Продолжить» (3) пускает программу до следующей остановки, «Шаг вперед» – на одну строку, «Завершить» – конец. Строка Number в таблице служебная, её не читай. Крестик (4) тоже останавливает программу.
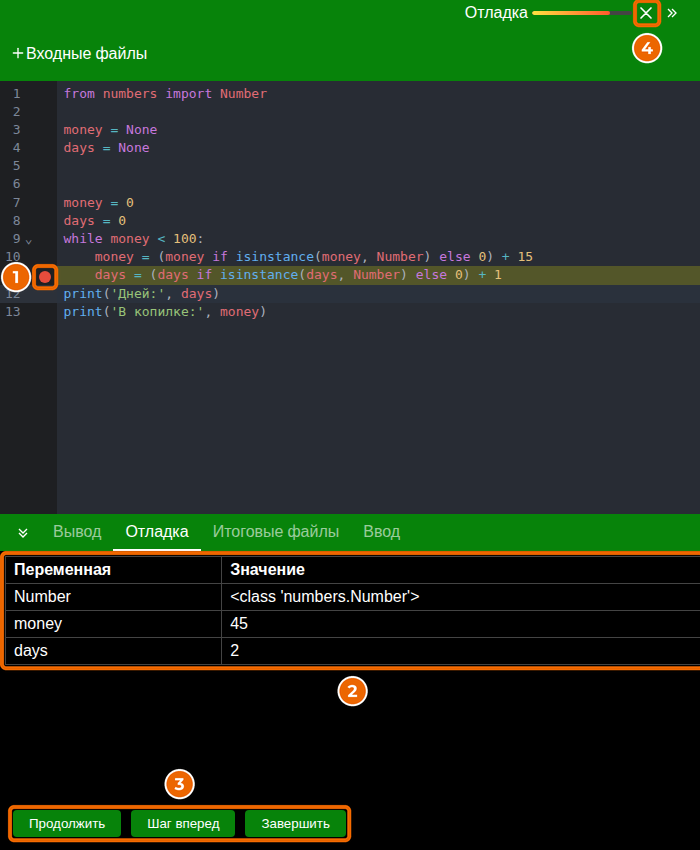
Что должно получиться: при первой остановке money равно 15, а days – 0 (до days программа ещё не дошла). После двух «Продолжить» – money 45 и days 2: деньги растут по 15 за круг, дни – по 1.
Задача П.4. Таблица по страницам. Сервер отдаёт 200 записей страницами по 50. Программа обойдёт все четыре страницы, склеит их в одну таблицу и сохранит файл. Так же устроена программа курса, только там страниц больше и другой адрес. Для тренировки возьмём открытый учебный сервер с адресом https://jsonplaceholder.typicode.com/todos: он отдаёт 200 дел, у каждого четыре поля – userId, id, title (заголовок) и completed («сделано»). Параметр _page – номер страницы, _limit – сколько записей на странице. Нужен интернет. Заранее создай переменные df_list, df, data и i.
Главный блок задачи – «HTTP GET» из группы «HTTP»: он ходит на сервер за данными.
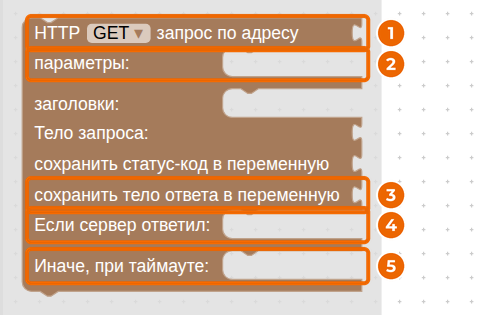
Начало. Из «HTTP» – «подключить библиотеку requests», из «Pandas» – «подключить библиотеку pandas как pd» (1 на кадре ниже). Первая ходит за данными в интернет, вторая умеет работать с таблицами. Потом «присвоить df_list =» и пустой список, как в П.2 (2).
Цикл. Из «Циклов» – «цикл по … от … до … шаг …»: выбери переменную i (в новом блоке стоит другая буква), впиши числа от 1, до 5, шаг 1 (3). Последнее число в перебор не входит, поэтому для четырёх страниц пишем 5.
Запрос. Внутрь цикла – «HTTP GET». В адрес (4) вставь текстовый блок с адресом. В «параметры» (5) поставь два блока «HTTP-параметр» друг под другом: ключ _limit со значением 50 (оба – пустые кавычки из группы «Текст») и ключ _page, а значение – переменная i. В «сохранить тело ответа в переменную» (6) вставь data. Остальные гнёзда оставь пустыми.
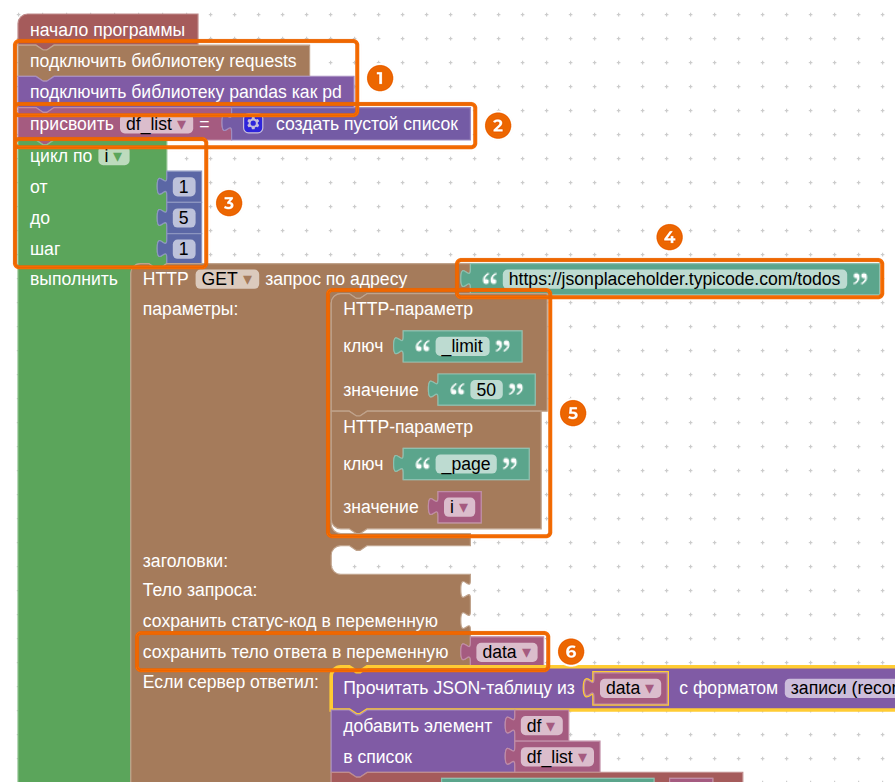
Ответ сервера. В ветке «Если сервер ответил»: «Прочитать JSON-таблицу из data с форматом записи (records) в переменную df» из «Pandas» (7), потом «добавить элемент df в список df_list» (8) из «Pandas» и «вывести» с текстом Готова страница и i (9). В ветке «Иначе, при таймауте» – «вывести» Ошибка (10). Ветки лежат близко: если блок прыгает не в ту, подними или опусти его чуть выше или ниже.
После цикла – не внутри него. «присвоить df =» «объединить список таблиц df_list в одну таблицу» (11); «вывести» с блоком «первые 3 строк таблицы df» из «Pandas» (12); «показать информацию о таблице df» (13); «сохранить таблицу df в CSV-файл с именем» todos.csv (14).
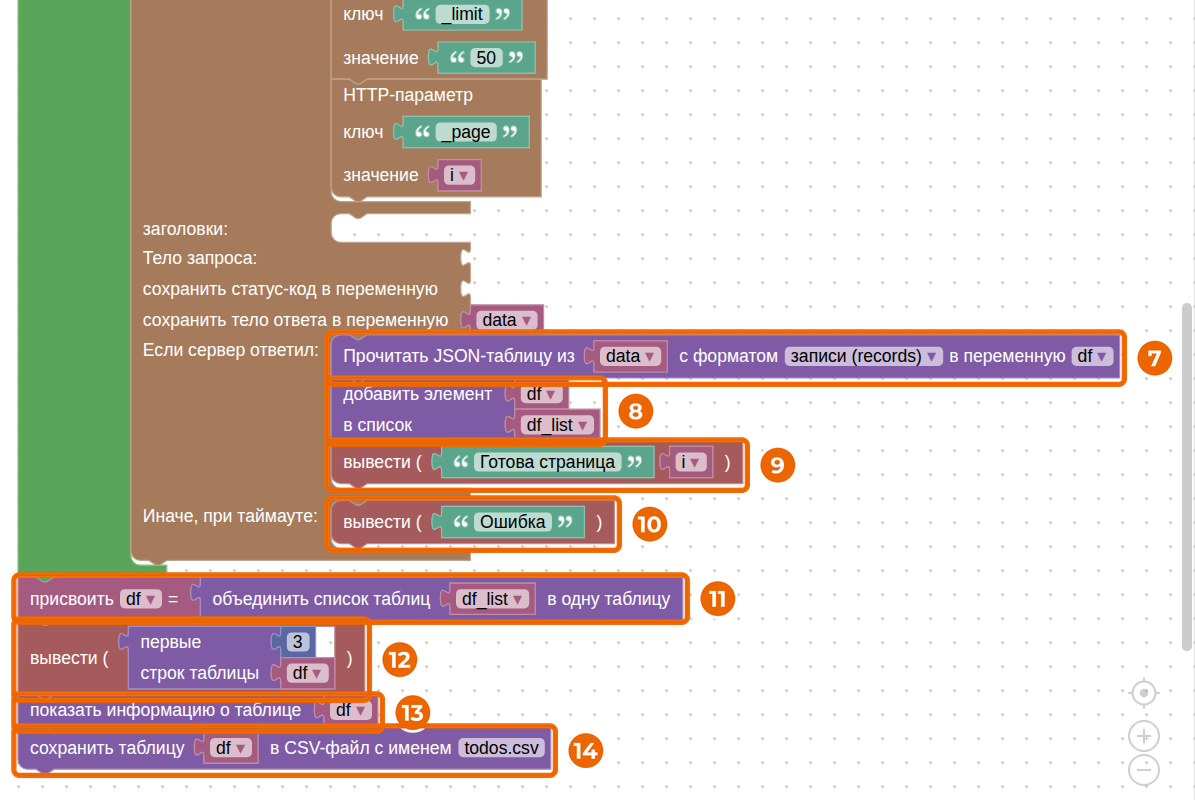
Нажми «Запуск». Несколько секунд программа ходит за страницами, потом печатает результат.
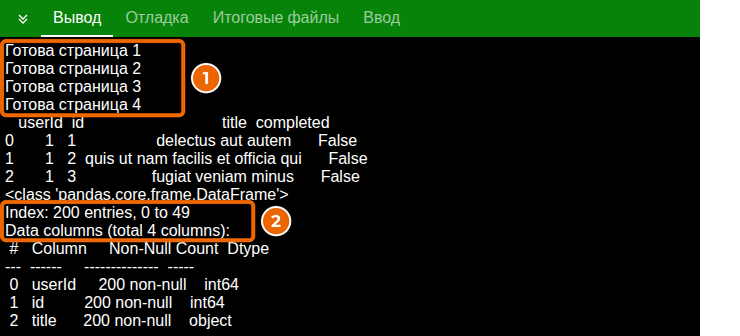
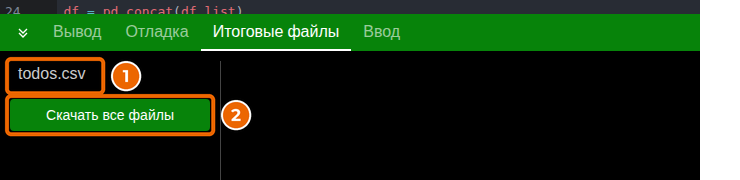
Что должно получиться: четыре строки Готова страница 1 … Готова страница 4 (1), таблица из колонок userId, id, title, completed с тремя первыми строками, под ней сводка: Index: 200 entries и total 4 columns (2) – 200 записей и 4 колонки. Это сходится: 4 страницы по 50. На вкладке «Итоговые файлы» – todos.csv, а кнопка «Скачать все файлы» скачает архив result_files.zip с ним. Если вместо страниц печатается «Ошибка» – сервер не ответил: проверь интернет и адрес, а если они в порядке, повтори позже. Если записей получилось 150, а не 200 – в цикле стоит «до 4», и последняя страница потерялась.
Датавиз-конструктор: таблица, статистика, диаграммы
Датавиз-конструктор – программа для исследования данных без кода: загружаешь таблицу, смотришь статистику, строишь диаграммы, собираешь дашборды и «вычислительные эссе» – диаграммы с пояснениями. В курсе сферы ИИтех в нём делают задания на наборе пассажиров космического лайнера Spaceship Titanic. Кадры сняты в версии 2.0.0 для Windows.
Шаг 1. Поставить. Инструкция разработчиков – teletype.in/@irk.digitalwave/dataviz-install, ссылка на неё есть и в курсе сферы (модуль «Исследовательский анализ данных»). Программа работает только под Windows и ставится без установщика: распаковал архив – запускаешь DatavizConstructor.exe.
Шаг 2. Окно программы.
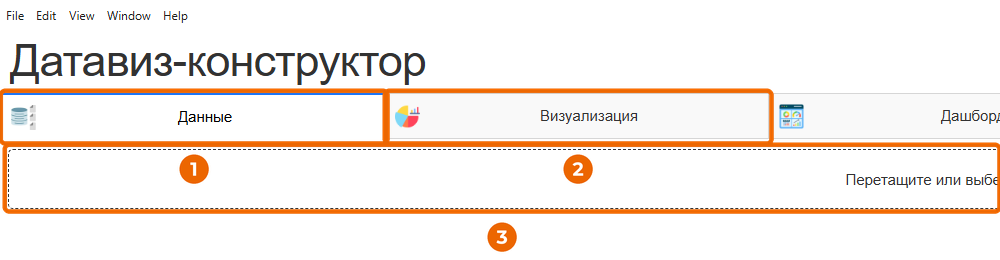
- Данные – загрузить таблицу, отфильтровать, посмотреть статистику, скачать.
- Визуализация – листы с диаграммами: «+» добавляет лист.
- Зона загрузки – перетащи сюда файл
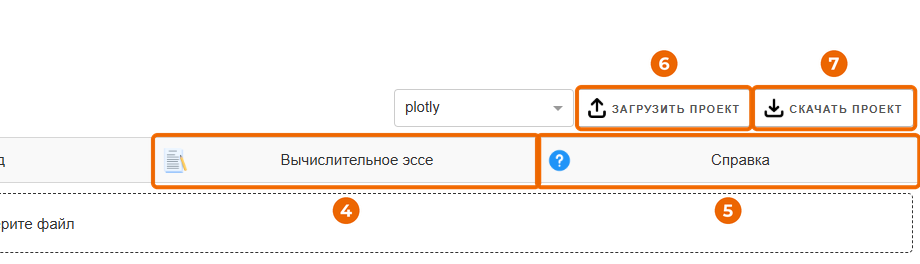
.csvили щёлкни и выбери его. - Вычислительное эссе – диаграммы и текст одной лентой, как отчёт.
- Справка – подсказки по программе.
- Загрузить проект – открыть сохранённую работу (файл
.dviz). - Скачать проект – сохранить всю работу в файл
.dviz. Сохраняй почаще.
Между вкладками «Визуализация» и «Вычислительное эссе» есть ещё «Дашборд» – несколько диаграмм на одном экране.
Задача П.1. Сколько пассажиров без возраста? Скачай в курсе файл train.csv и загрузи его во вкладке «Данные».
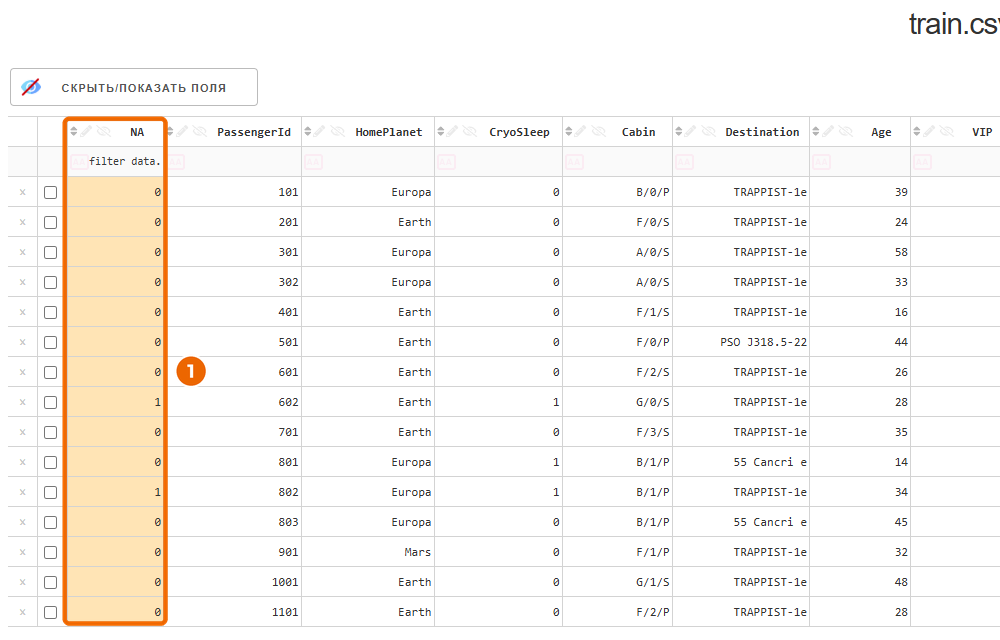
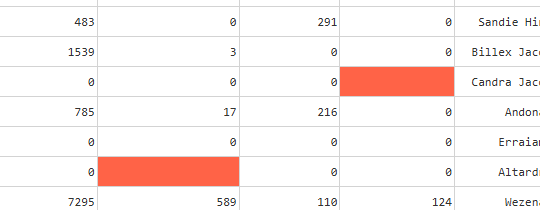
Программа сама добавила первым столбец NA (1): в нём 1, если в строке есть хоть один пропуск, и 0, если пропусков нет. Сами пустые ячейки подсвечены красным.
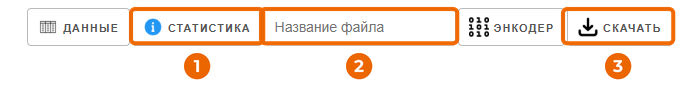
Над таблицей – кнопки: «Статистика» (1), поле «Название файла» (2) и «Скачать» (3). Нажми «Статистика».
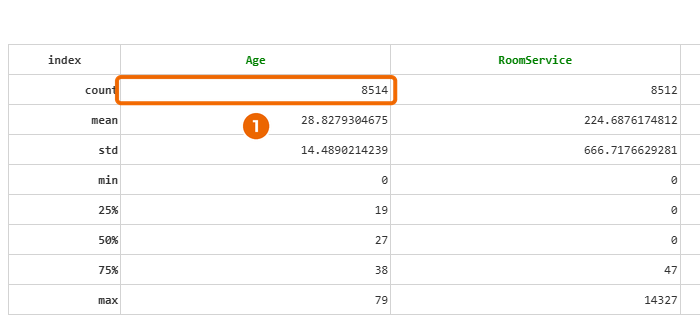
Что должно получиться: строк в таблице 8693, а у Age count (1) – 8514. count считает только непустые значения, поэтому возраст не указан у пассажиров. Посмотри count у других столбцов – пропуски есть почти везде.
Задача П.2. Чистая таблица. Вернись к таблице кнопкой «Данные». В строке фильтра под заголовком NA (1) впиши = 0 и нажми Enter – останутся строки без пропусков. Порядок строк и столбцы не трогай.
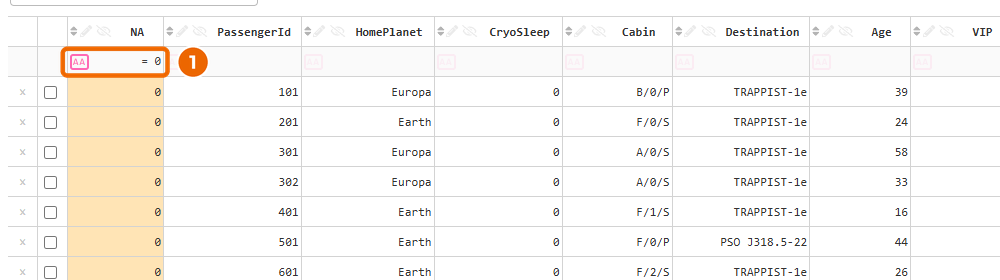
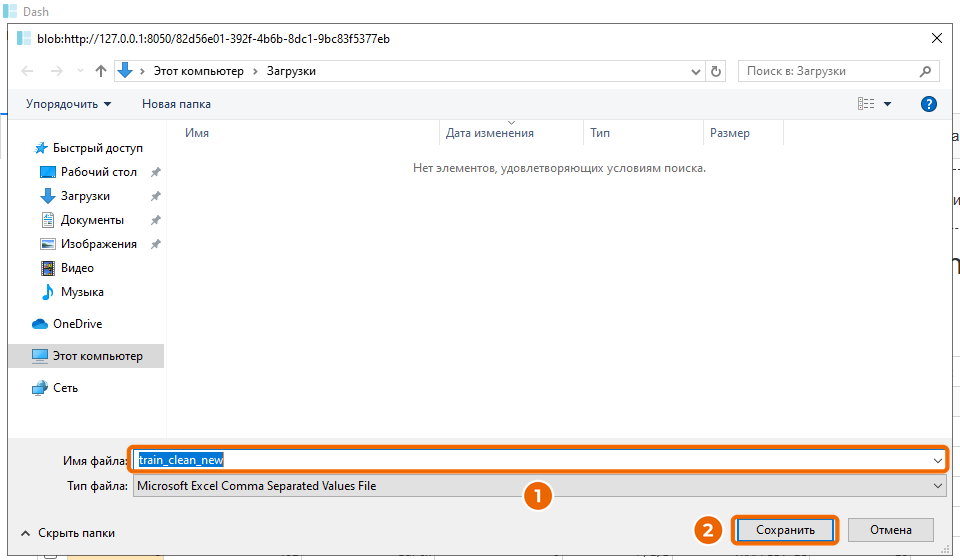
Впиши название файла (например, train_clean) и нажми «Скачать»: Windows спросит, куда сохранить, – имя (1) и «Сохранить» (2).
Загрузи сохранённый файл снова и открой «Статистику».
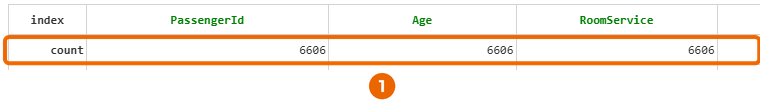
Что должно получиться: count у всех столбцов – 6606 (1). Ровно столько строк должно остаться, так проверяет себя и курс. Не совпало – в курсе есть готовый файл data_new.csv, работай с ним. Важно: фильтр таблицы не действует на диаграммы – поэтому чистый файл и загружают заново.
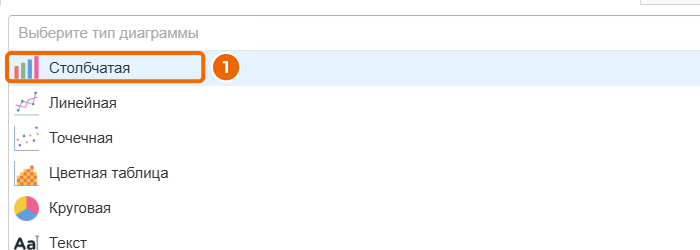
Задача П.3. Кого «унесло» чаще? В столбце Transported 1 – пассажира переместило, 0 – нет; в CryoSleep 1 – он был в криосне. Вкладка «Визуализация» → «Выберите тип диаграммы» → «Столбчатая» (1).
Ось X – CryoSleep (1), ось Y – Transported (2), агрегация (3) пока «Сумма».
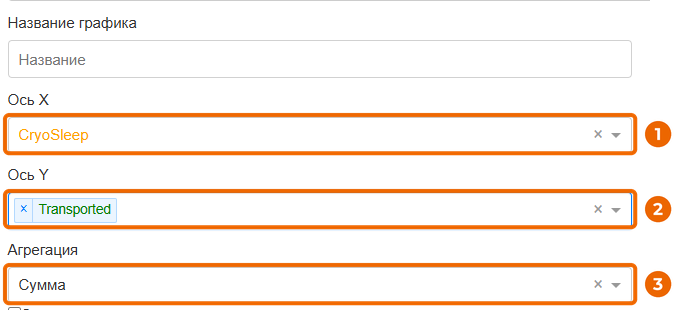
Теперь смени агрегацию на «Среднее» (1).
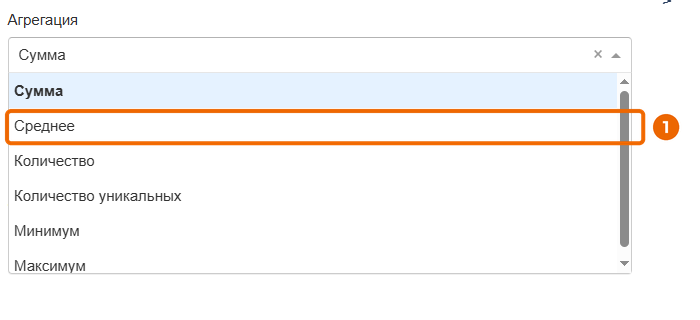
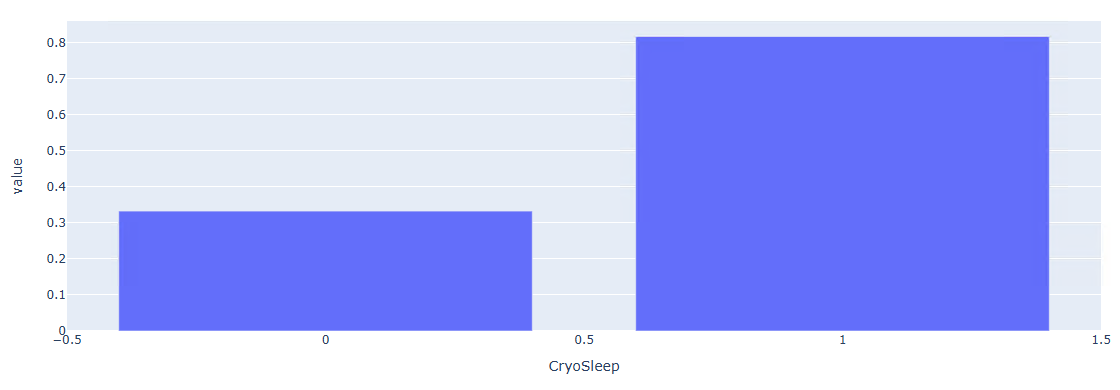
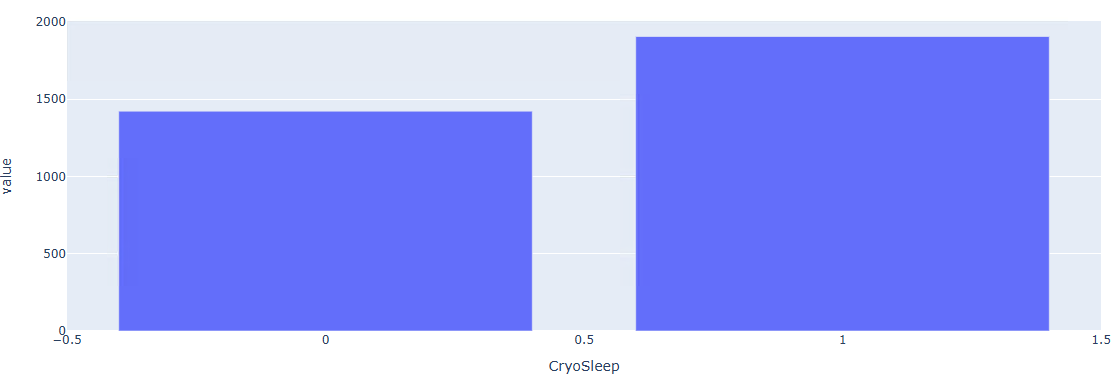
Что должно получиться: с «Суммой» столбцы показывают, сколько пассажиров переместило – около 1420 без криосна и около 1900 в криосне. Со «Средним» – какая доля: 0,33 и 0,82. Среднее столбца из нулей и единиц – это и есть доля единиц. Вывод: из спавших в криосне перемещены 82 % пассажиров, из бодрствовавших – только треть. Сравнивать группы разного размера честнее по доле, а не по сумме.
GraphNet: собираем нейросеть из блоков
GraphNet – конструктор нейросетей: сеть собирают из блоков и соединяют их линиями, а учит её библиотека Keras. На сфере ИИтех с него начинают модуль про нейросети. Кадры сняты в версии 0.1.0 для Windows. В курсе модуль GraphNet открывается позже (4 октября), поэтому здесь – первая сеть из раздела 7.3: линейная регрессия .
Шаг 1. Поставить. Инструкция автора – teletype.in/@yupest/graphnet: там ссылка на файл GraphNet_v010.exe (около 650 МБ). Установка не нужна – скачал и запустил. Windows может предупредить о неизвестном издателе: «Подробнее» → «Выполнить в любом случае» (вместе со взрослым). Первый запуск долгий – программа распаковывается 15–40 секунд. Процессор Pentium или Celeron не подойдёт.
Шаг 2. Окно. Слева – список блоков (1), на поле уже стоит блок Input (2) – вход сети. Внизу кнопка «Собрать модель»: она соединяет блоки, обучает сеть и выполняет всё, что нарисовано.
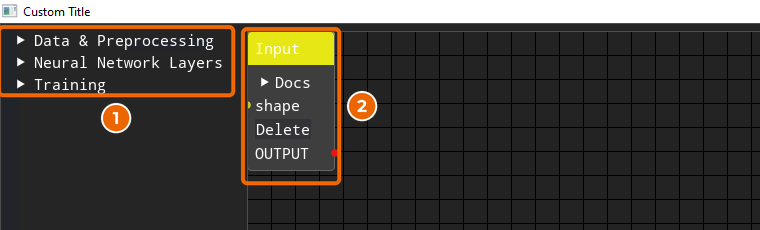
Разверни разделы списка треугольниками – увидишь все блоки. Блок ставят на поле, перетащив мышью (щелчок по названию ничего не добавляет). Удалить – кнопка Delete в самом блоке.
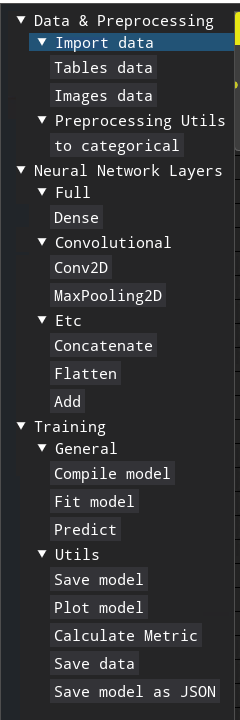
- Tables data – загрузить таблицу из файла; Images data – папку с картинками.
- Dense – полносвязный слой нейронов; Conv2D, MaxPooling2D – слои для картинок.
- Compile model – выбрать, как учить: оптимизатор и функцию ошибки.
- Fit model – обучить: что подавать на вход (x), какие правильные ответы (y), сколько эпох.
- Predict – прогноз обученной сети на новых данных; Calculate Metric – посчитать точность.
- Save model, Save data – сохранить модель и результаты в файл.
Важно. Схему блоков GraphNet пока не сохраняет: закрыл программу – схему придётся собирать заново. Сделай снимок экрана, а обученную модель сохрани блоком Save model.
Задача П.1. Сколько вёдер на грядки. Дачник поливает грядки: на каждую уходит 3 ведра и ещё 1 ведро на дорожку – . Пусть сеть сама найдёт эти числа. Создай в Блокноте три файла, по одному числу в строке, без заголовка: x.csv – числа от 1 до 10 (грядки); y.csv – 4, 7, 10 и так до 31 (вёдра); new.csv – 12 и 25 (новые грядки). Собери схему:
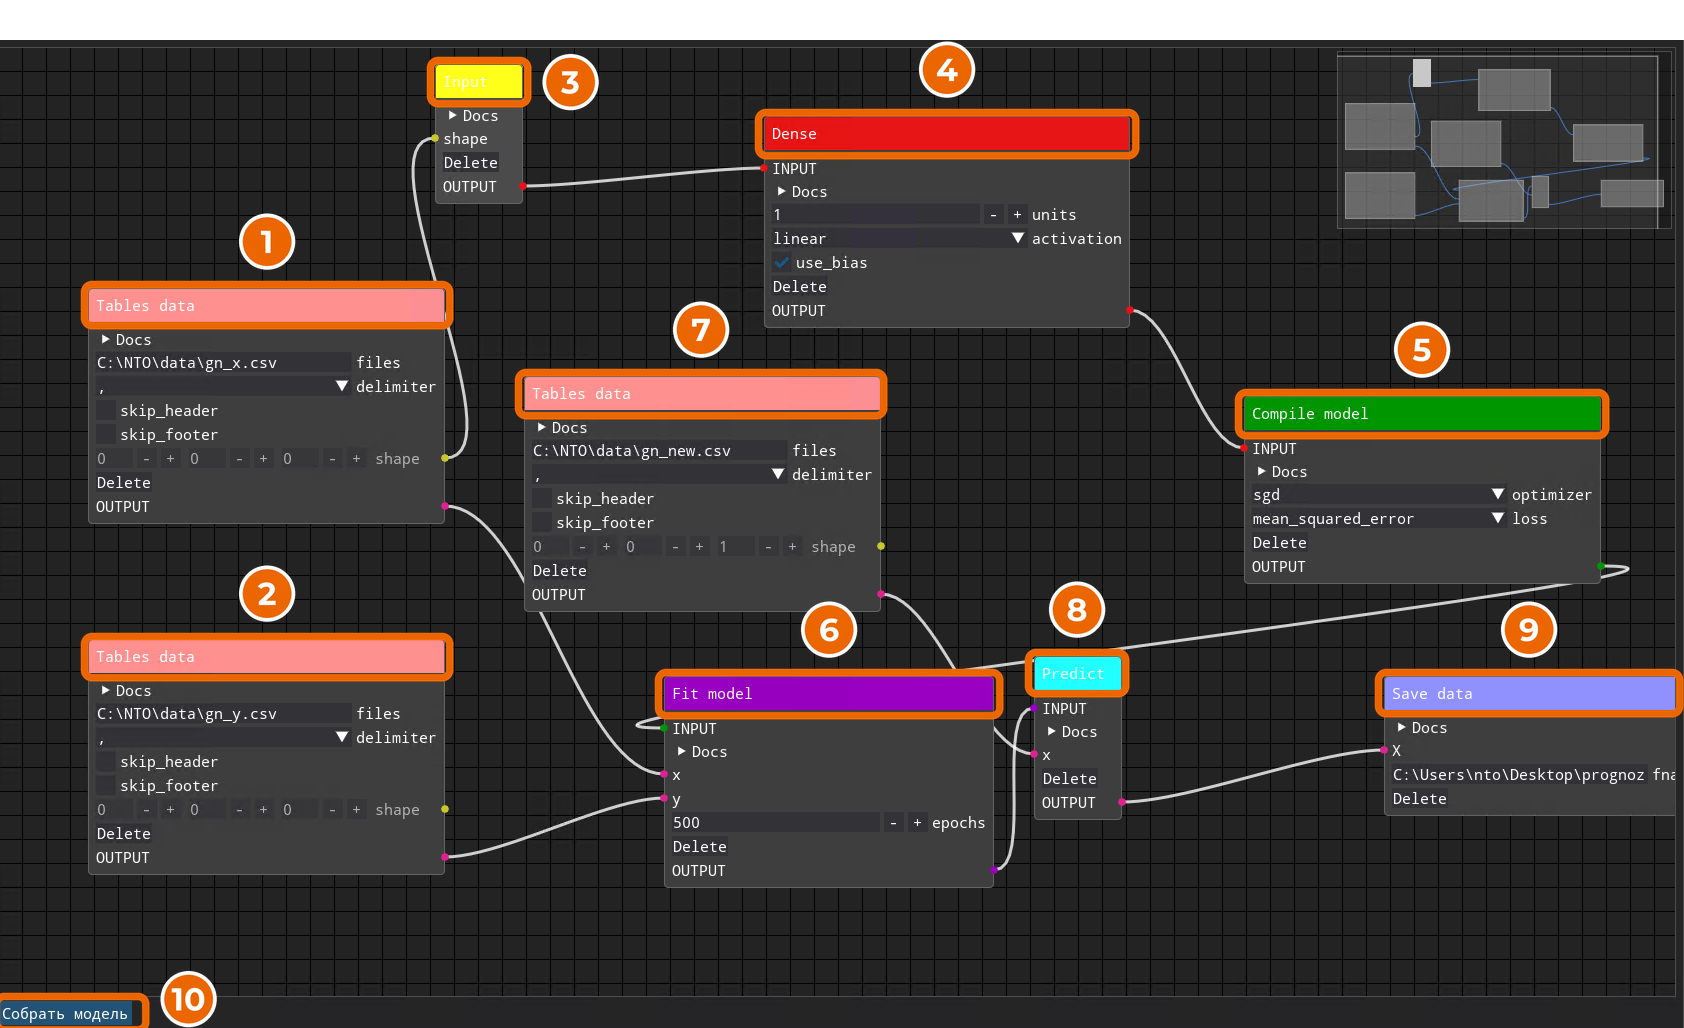
- Tables data с файлом
x.csv– в поле files впиши полный путь, напримерC:\Users\Ученик\Desktop\x.csv(1 на рисунке ниже). Её выход shape (2) соедини со входом shape блока Input (3) – так сеть узнает размер входа. - Tables data с файлом
y.csv– правильные ответы. - Input – уже стоит на поле.
- Dense: units – 1 (один нейрон), activation – linear, галочка use_bias – чтобы у нейрона было смещение . Соедини OUTPUT блока Input со входом INPUT блока Dense.
- Compile model: optimizer – sgd, loss – mean_squared_error (средний квадрат ошибки). Вход – от OUTPUT Dense.
- Fit model: вход INPUT – от Compile model, x – от таблицы
x.csv, y – от таблицыy.csv, epochs – 500. - Tables data с файлом
new.csv– новые грядки для прогноза. - Predict: INPUT – от Fit model, x – от таблицы
new.csv. - Save data: X – от Predict, в поле имени файла – полный путь, например
C:\Users\Ученик\Desktop\prognoz.txt. - Нажми «Собрать модель».
Линию тянут мышью от цветной точки-выхода одного блока к точке-входу другого.
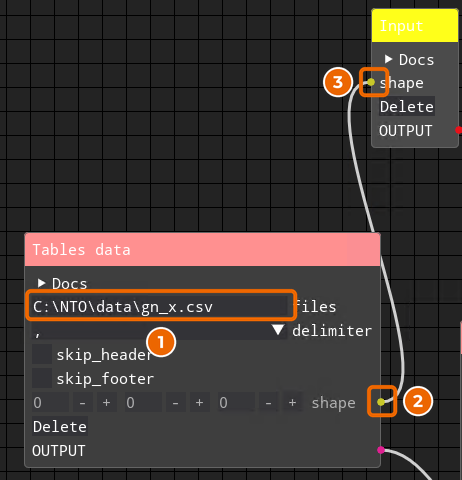
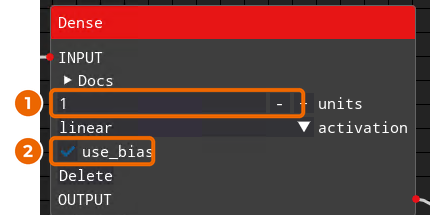
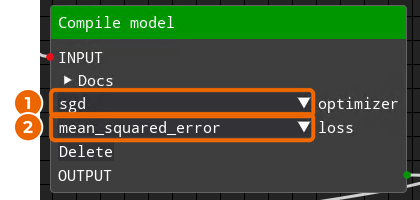
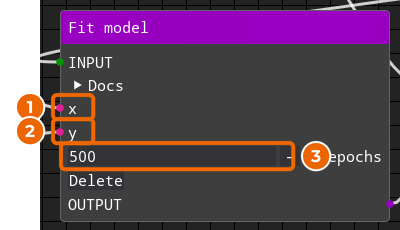
Что должно получиться: на несколько секунд появится окошко «Обучение», потом в файле prognoz.txt окажутся два числа – около 37 и около 76. У нас вышло 37,06 и 76,21: правильные ответы и . Значит, сеть нашла и сама, по десяти примерам. Числа в файле записаны так: 3.705e+01 – это .
Задача П.2. Оптимизатор решает. В Compile model смени sgd на adam (1), эпохи оставь 500, снова «Собери модель» и открой prognoz.txt.
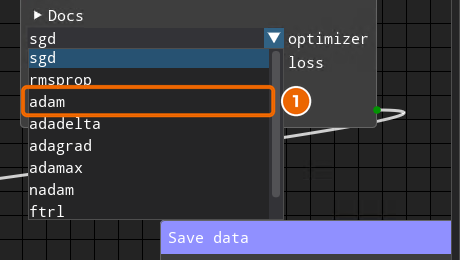
Что должно получиться: прогноз намного меньше правильного (у нас вышло 7,8 и 15,8 вместо 37 и 76; у тебя будут другие числа – веса сети в начале случайные). Adam с настройками по умолчанию делает слишком маленькие шаги и за 500 эпох не успевает дойти до . Поставь 5000 эпох – прогноз заметно приблизится (у нас 34,8 и 69,6), но учиться сеть будет несколько минут. Вывод для отбора: обученность сети зависит и от оптимизатора, и от числа эпох (раздел 7.3).
Teachable Machine: научи компьютер отличать круг от квадрата
Teachable Machine (teachablemachine.withgoogle.com) – бесплатный сервис Google: модель-классификатор в нём собирают мышкой, без единой строчки кода. Работает в браузере, регистрироваться не нужно. В курсе сферы 2026/27 Teachable Machine не используется – это инструмент кружка, чтобы руками понять, как работает классификация. Ниже весь путь по шагам и четыре задачи. Рамка с номером на картинке – куда нажимать.
Надписи в сервисе – на языке твоего браузера. Если они английские, внизу страницы есть выпадающий список языков – выбери «русский». Главные кнопки по-английски: «Get Started» – «Начать», «Image Project» – «Проект с изображениями», «Train Model» – «Обучить модель», «Advanced» – «Дополнительные», «Under the hood» – «Дополнительные сведения», «Preview» – «Посмотреть», «Input» – «Ввод», «Output» – «Выходные данные».
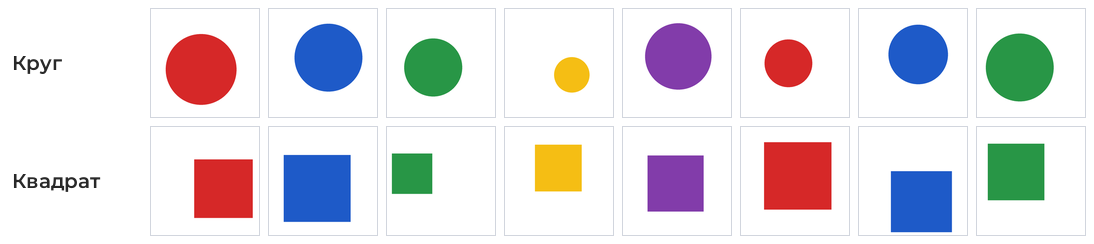
Шаг 0. Подготовь картинки. Веб-камера не нужна: примеры мы загрузим файлами. Нарисуй их сам в Paint или в любом редакторе, где можно сохранить PNG или JPG.
- Холст квадратный, например 400 × 400, фон белый: сервис всё равно обрежет картинку до квадрата.
- На холсте одна закрашенная фигура. Инструмент «Овал» с зажатой клавишей Shift рисует круг, «Прямоугольник» с Shift – квадрат. Овал без Shift тяни так, чтобы одна сторона была в полтора–два раза длиннее другой.
- У каждой картинки свои размер, место на холсте и цвет (красный, синий, зелёный, жёлтый, фиолетовый). Цвета и размеры у кругов и квадратов должны быть одинаково разными, чтобы по ним нельзя было угадать фигуру.
- Нужно четыре папки: «круг» – 30 картинок, «квадрат» – 30, «овал» – 30 и «проверка» – по 5 новых кругов, квадратов и овалов, которые в классы мы не положим (назови их «новый-круг-1», «новый-квадрат-1» и так далее).
Рисовать 105 картинок в одиночку долго, поэтому разделите работу в кружке. Если рисовать лень, можно фотографировать: крышки и монеты – круги, стикеры – квадраты, овалы вырежи из бумаги. Снимай на светлом ровном фоне.
Шаг 1. Открыть сайт. Зайди на teachablemachine.withgoogle.com и нажми «Начать» (1).
Шаг 2. Выбрать проект. На странице «Новый проект» нажми «Проект с изображениями» (1 на левой половине рисунка). В окне выбери «Стандартную модель изображения» (1 на правой половине): она работает с цветными картинками и нужна нам. «Встроенная модель» – для микроконтроллеров, её не трогай.
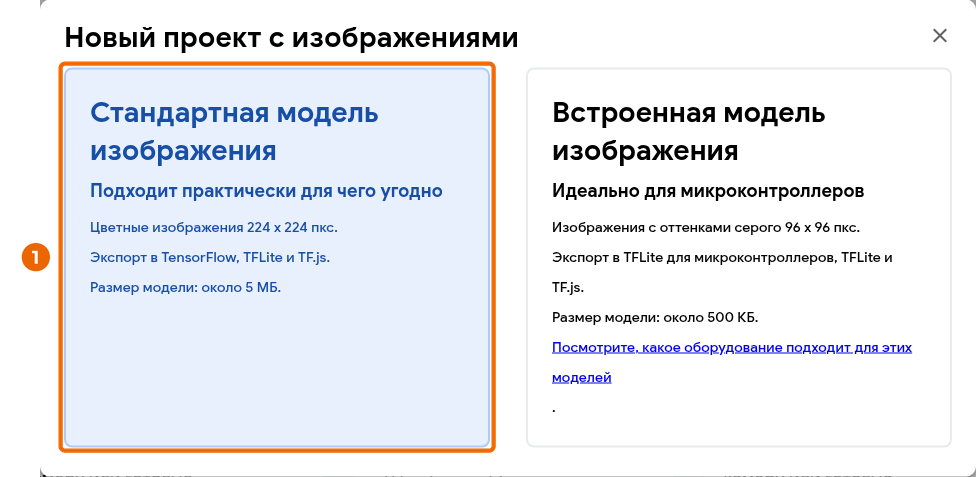
Шаг 3. Окно редактора. Что где лежит, видно на рисунке. Сверху слева может всплыть синяя подсказка с видео – закрой её крестиком.
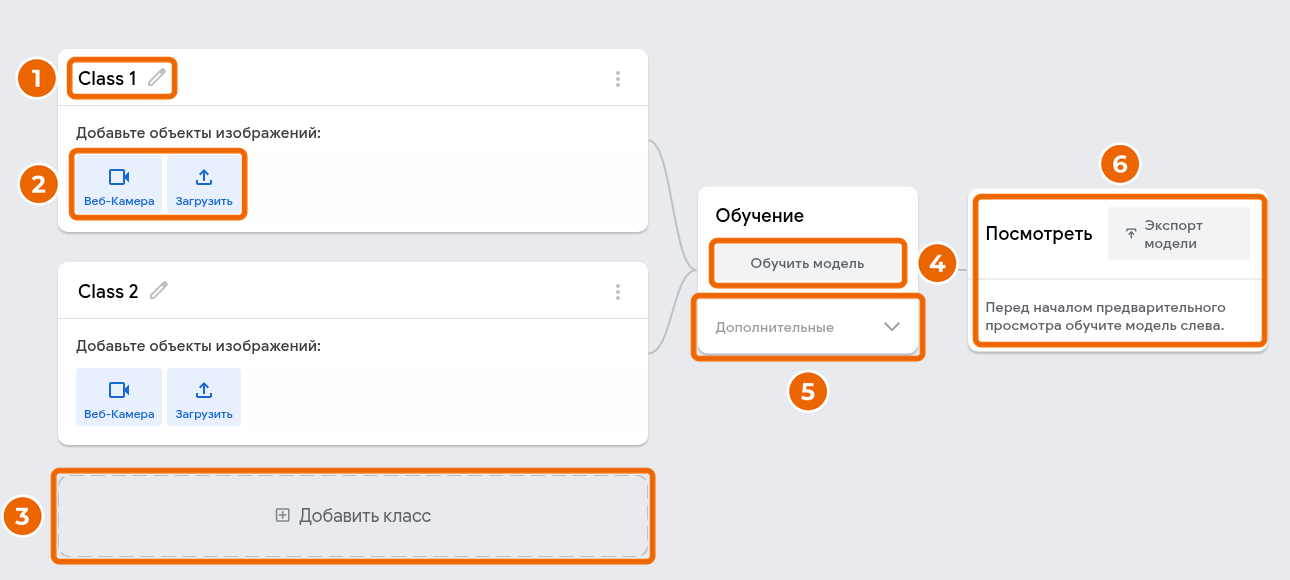
- Название класса. Класс – это коробка для картинок одного вида. Название меняется карандашом.
- «Веб-камера» и «Загрузить» – два способа положить в класс примеры. Нам нужен «Загрузить».
- «Добавить класс» – ещё одна коробка. Сразу есть два класса, «Class 1» и «Class 2».
- «Обучить модель» – запуск обучения.
- «Дополнительные» – настройки обучения (эпохи, размер пакета, скорость обучения; они знакомы тебе из главы 7) и кнопка «Дополнительные сведения» с графиками.
- «Посмотреть» – сюда после обучения показывают новые картинки и смотрят, что ответит модель.
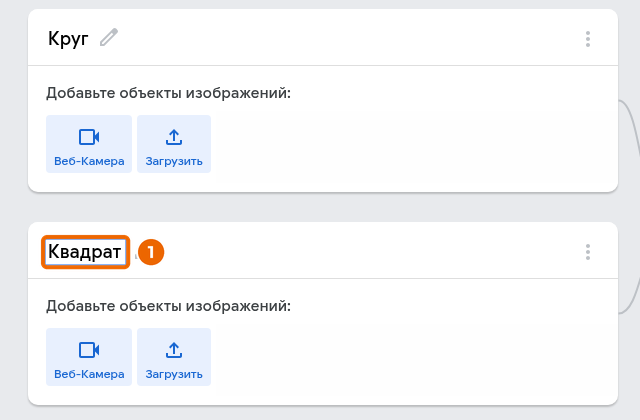
Шаг 4. Назвать классы. Нажми на карандаш рядом с названием класса, сотри «Class 1», впиши «Круг» и нажми Enter. Второй класс назови «Квадрат»: так выглядит поле для названия, пока ты печатаешь (1 на левой половине рисунка ниже). Названия на панели «Посмотреть» обрезаются многоточием («Квад…») – это только подпись, на модель она не влияет.
Шаг 5. Загрузить примеры. В классе «Круг» нажми «Загрузить». Слева откроется панель: нажми «Выберите изображения из файлов» (1 на правой половине рисунка) и в окне выбора файлов найди папку «круг». Нажми Ctrl+A, чтобы выделить все 30 картинок, потом «Открыть». Сервис предупреждает (2 на правой половине), что обрежет картинки до квадрата: наши и так квадратные.
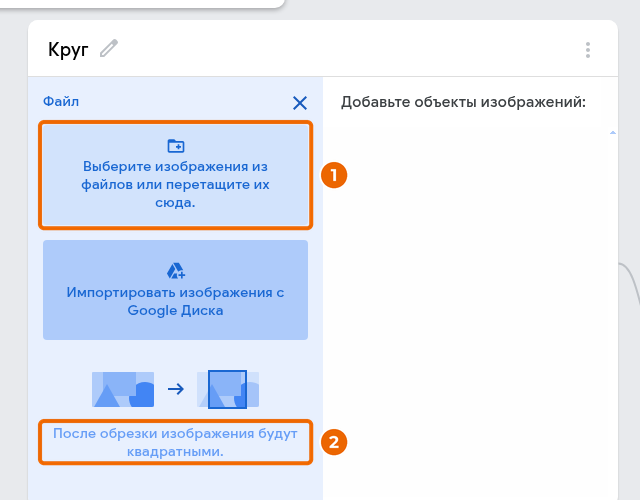
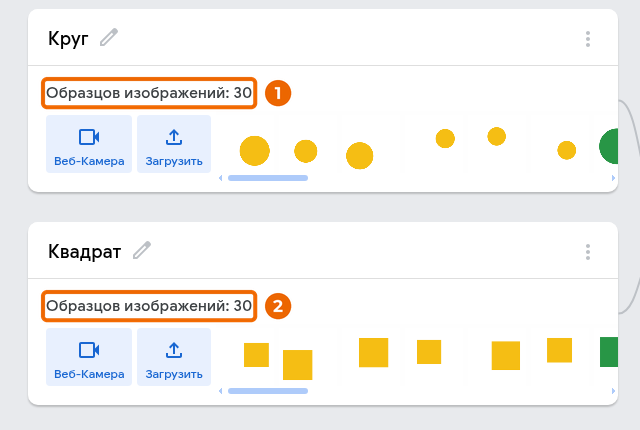
Закрой панель крестиком, то же самое сделай со вторым классом и папкой «квадрат». Проверь, что в каждом классе написано «Образцов изображений: 30» (1 и 2). Если число не такое, значит, в классе лишние или пропавшие картинки – добавь или найди их.
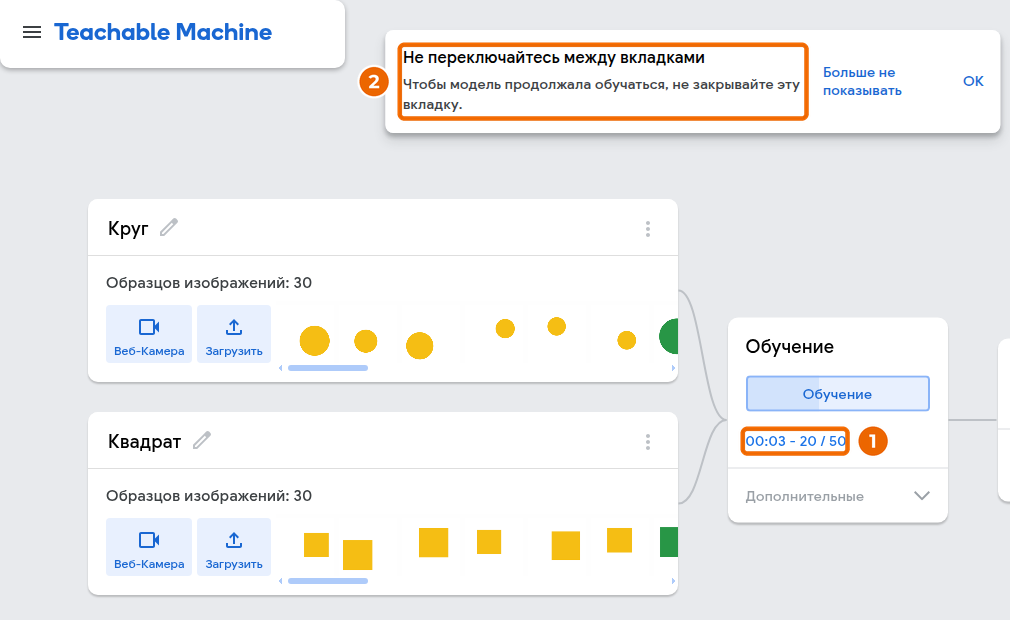
Шаг 6. Обучить. Нажми «Обучить модель» (на рисунке шага 3 – кнопка 4). Кнопка превратится в полоску «Обучение», а под ней побежит счётчик (1): время и номер эпохи из 50. Сверху всплывёт сообщение (2): не переключайся на другие вкладки и не закрывай эту, пока идёт обучение. Оно занимает от нескольких секунд до минуты. Когда на кнопке появится «Модель обучена», модель готова.
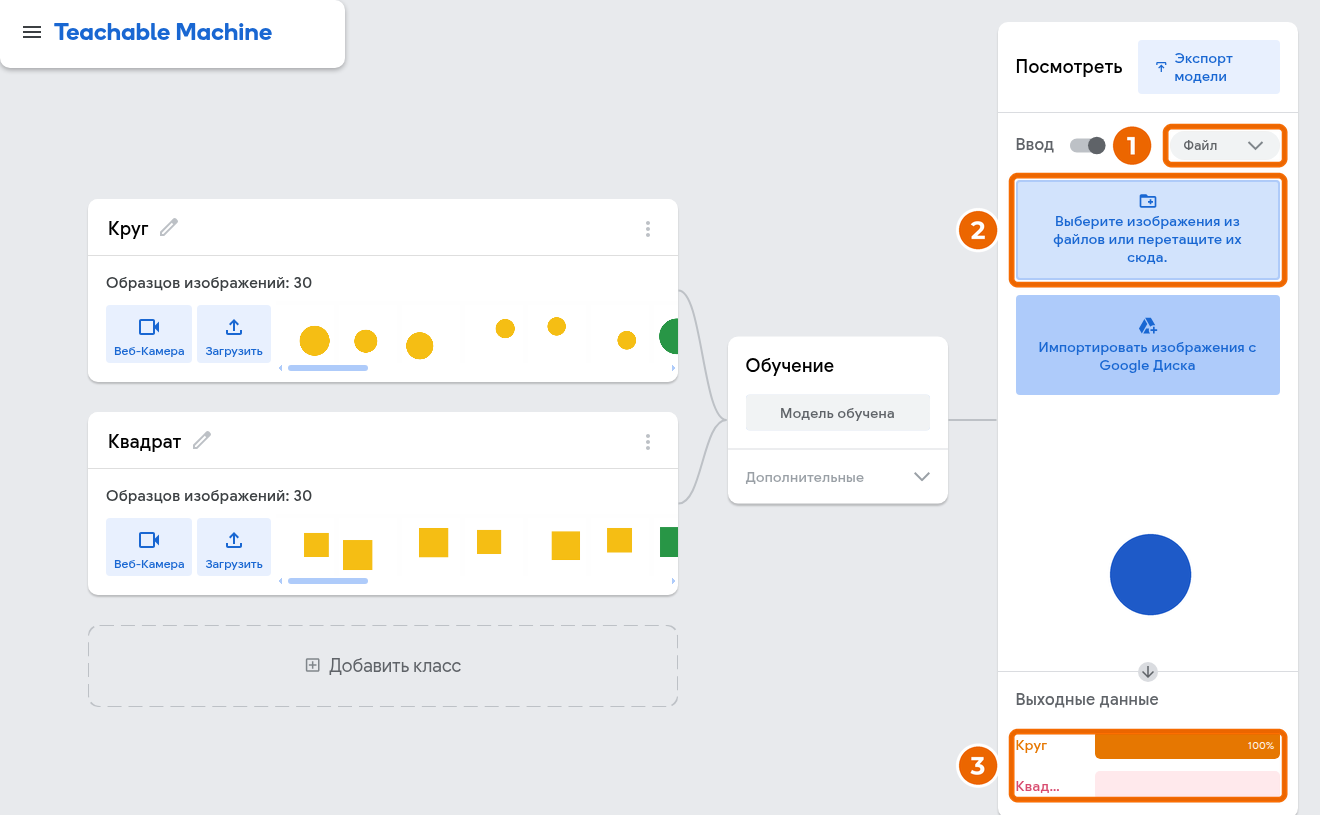
Шаг 7. Проверить на новой картинке. По умолчанию панель «Посмотреть» ждёт веб-камеру: браузер попросит к ней доступ или сервис напишет «Не удалось включить веб-камеру». Нам камера не нужна. Открой выпадающий список справа от слова «Ввод» (1) и выбери «Файл». Нажми «Выберите изображения из файлов» (2) и возьми любую картинку из папки «проверка». Под ней в «Выходных данных» (3) появятся полоски: для каждого класса – процент уверенности. Проценты всех классов в сумме дают 100, а ответ модели – класс с самой длинной полоской.
Не потерять работу. Закроешь вкладку – проект пропадёт. Чтобы сохранить, нажми три полоски слева вверху и выбери «Скачать проект как файл»: на компьютер придёт файл project.tm. Открывается он на странице выбора проекта кнопкой «Открыть существующий проект из файла». Входить в аккаунт Google для этого не нужно. Пункты про Google Диск пропусти.
Практика: четыре опыта.
Опыты идут по порядку: первые три – в одном проекте, для четвёртого начни новый. Числа в твоём проекте будут немного другими: при каждом обучении сеть стартует с других случайных весов. Важно, куда числа сдвигаются, а не какими они получились у нас.
Задача П.1. Круг или квадрат? Сделай по шагам 1–7 модель из двух классов «Круг» и «Квадрат» по 30 картинок. Проверь четыре картинки из папки «проверка»: два новых круга и два новых квадрата разных цветов. Для каждой запиши, какой класс выбрала модель и сколько процентов получил этот класс.
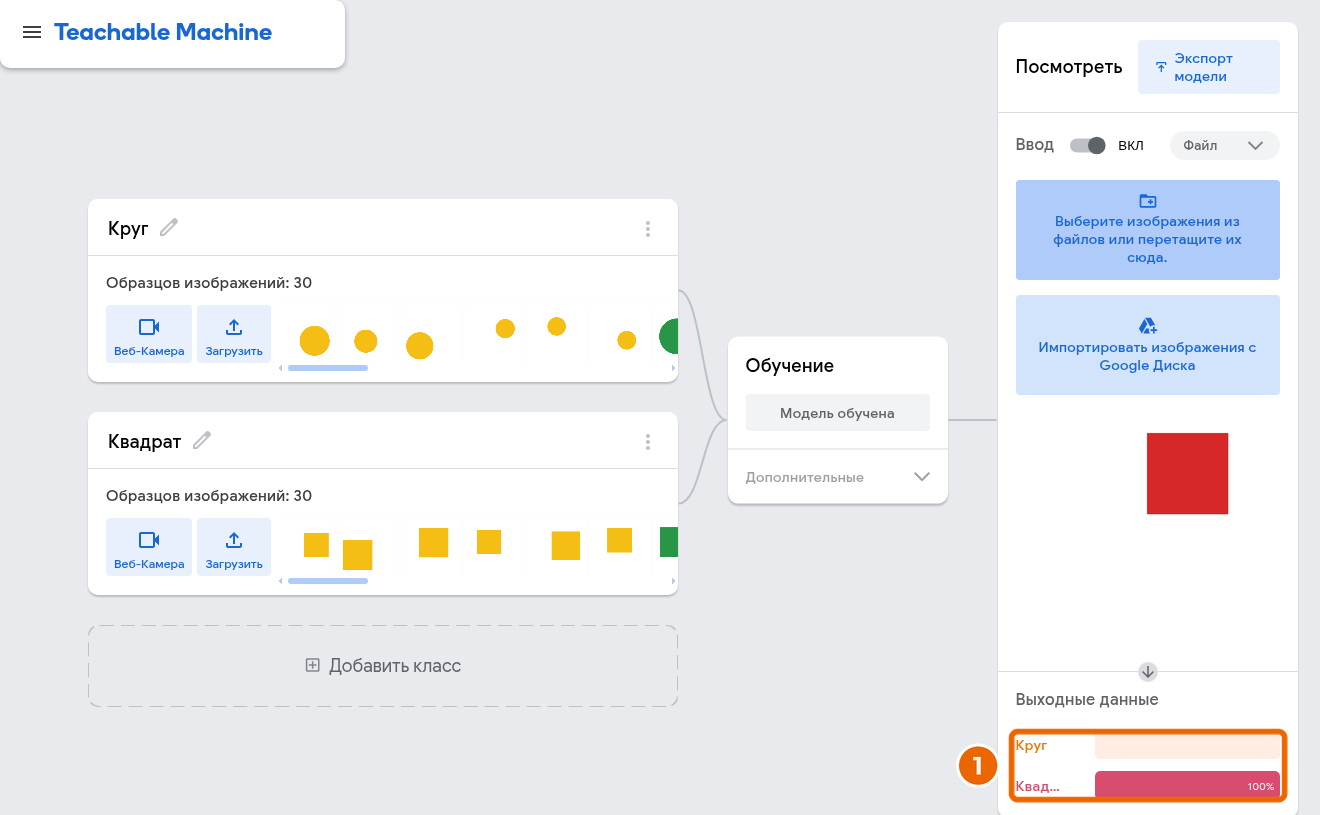
Что должно получиться: на всех четырёх картинках правильный класс набрал больше 90 %. У нас получилось 100 % и 0 %: фигуры такие разные, что модель не сомневалась. Связь с книгой: 60 картинок, которые ты положил в классы, – обучающая выборка, а картинки из «проверки» – проверка на новых данных: их модель до этого не видела (глава 1 и раздел 7.5).
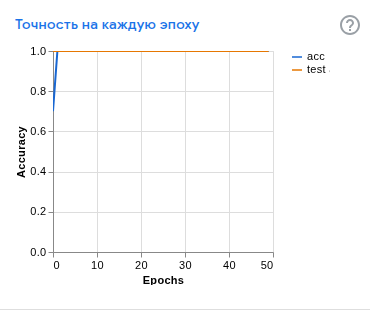
Задача П.2. Заглянуть под капот. Не закрывая проект, раскрой в блоке «Обучение» список «Дополнительные» и нажми «Дополнительные сведения» (1). Справа выедет панель. Нажми «Вычислить точность на каждый класс» (2) и «Вычислить матрицу ошибок» (3). Потом прокрути панель вниз к графикам «Точность на каждую эпоху» и «Потеря на каждую эпоху». Ответь: сколько картинок каждого класса сервис отложил для проверки? Какая получилась точность по классам? Что стоит в клетках матрицы вне главной диагонали?
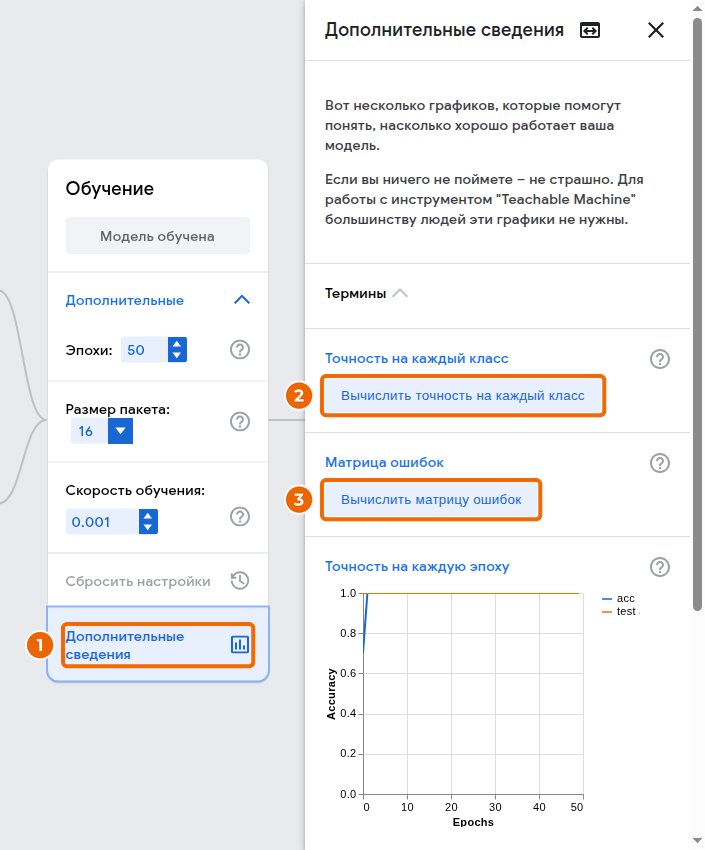
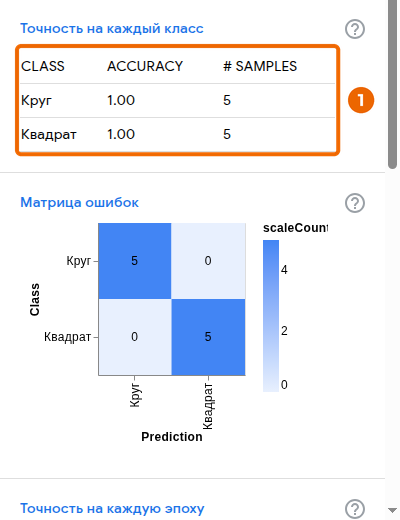
Что должно получиться:
- Сервис сам отложил 15 % картинок и не учил на них модель: по 5 из каждых 30 (столбец «# Samples»). В Teachable Machine они называются тестовыми, а в книге – проверочными.
- Точность у обоих классов 1.00: из 5 отложенных картинок верно названы все 5.
- В матрице ошибок строка – настоящий класс, столбец – ответ модели, число в клетке – сколько картинок. У нас по 5 на главной диагонали и нули вне её: модель не ошиблась ни разу.
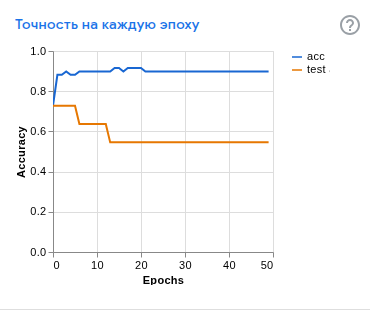
- На графике точности две линии: «acc» – точность на обучающих картинках, «test» – на отложенных. У хорошей модели обе почти сразу упираются в 1.0.
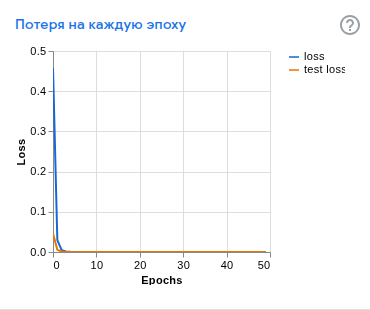
- График потерь показывает ошибку (функцию потерь): она падает почти до нуля за несколько эпох.
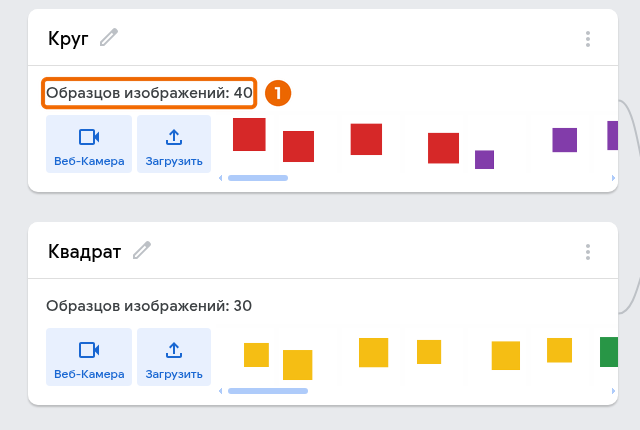
Задача П.3. Перепутанные подписи. В классе «Круг» нажми «Загрузить» и добавь ещё 10 картинок, но квадратов: любые десять из папки «квадрат». Теперь в «Круге» 40 образцов, и 10 из них подписаны неправильно – будто в кружке кто-то перепутал папки. Нажми «Обучить модель» ещё раз: после любого изменения в классах кнопка снова становится активной. Когда модель обучится, в списке «Ввод» может опять появиться сообщение о камере: переключи список на «Веб-камера» и обратно на «Файл». Потом: а) проверь на новых картинках те же четыре; б) открой «Дополнительные сведения», вычисли точность по классам и матрицу ошибок; в) посмотри оба графика и сравни их с графиками из П.2.
Что должно получиться:
- На четырёх новых картинках модель ещё часто права: у нас круги получили 100 %, квадраты от 81 до 100 %. По одной-двум картинкам порчи почти не видно.
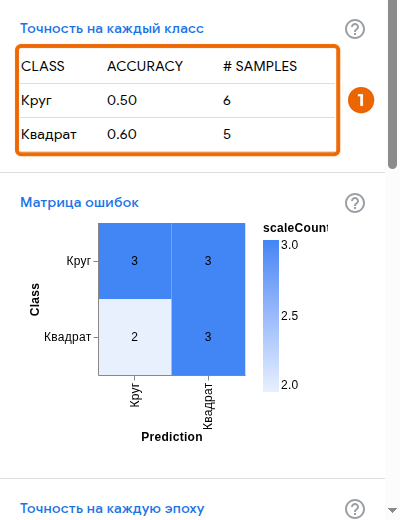
- В таблице точность по классам упала: у нас 0.50 для круга и 0.60 для квадрата, в других запусках выходило от 0.20 до 0.80. Одинаковых чисел не жди, но 1.00 уже не будет. В матрице вне главной диагонали больше нет одних нулей.
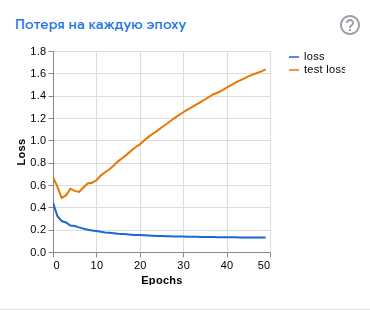
- На графике точности линии разошлись: «acc» держится около 0.9, «test» падает ниже, у нас примерно до 0.55.
- На графике потерь «loss» всё ещё снижается, а «test loss» растёт.
Модель подгоняется под обучающие картинки вместе с их ошибками и всё хуже справляется с отложенными. Это то самое переобучение из раздела 7.4. Значит, ошибки в подписях не видны на одной-двух проверочных картинках: их находят по точности по классам и по расхождению графиков.
Задача П.4. Мало примеров. Открой сайт заново в новой вкладке и начни новый проект (шаги 1 и 2). Назови классы «Круг» и «Овал». В «Круг» загрузи всего 3 любые картинки, в «Овал» – все 30. Обучи модель. Проверь пять новых кругов и один новый квадрат из папки «проверка», запиши ответы. Потом загрузи в «Круг» остальные 27 картинок, обучи модель ещё раз (список «Ввод» переключи так же, как в П.3) и проверь те же пять кругов. Сколько новых кругов модель назвала овалами до и после добора? Что она ответила про квадрат?
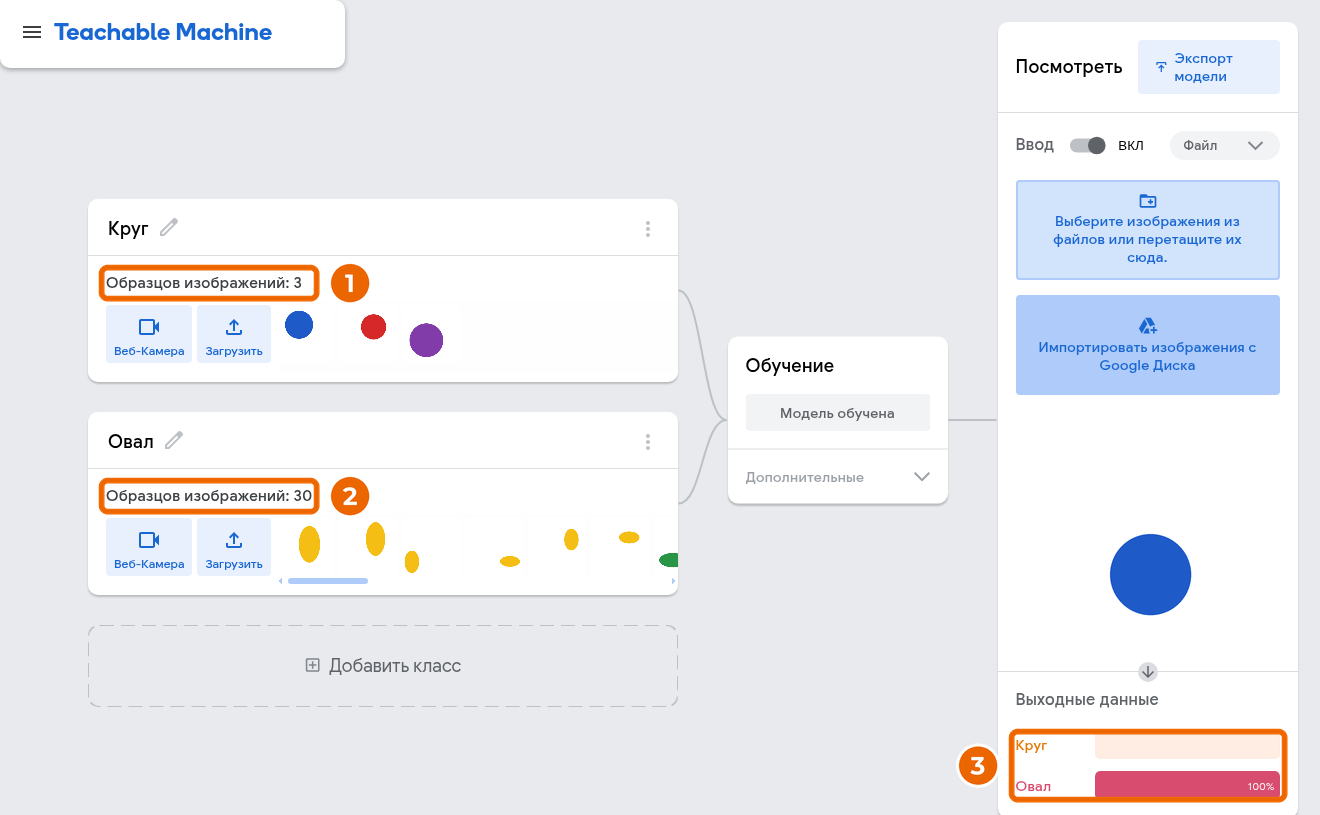
Что должно получиться:
- Пока кругов три, модель называет «Овалом» почти всё: из пяти новых кругов у нас «Кругом» назван один, остальные четыре – «Овал» с уверенностью 95–100 %.
- В таблице точности у круга всего одна отложенная картинка, и по ней ничего не скажешь: у нас вышло 0.00, в другой раз было 1.00. Проверка на новых картинках показала больше любой таблицы.
- Квадрат модель тоже назвала «Овалом» на 100 %, хотя таких картинок никогда не видела. «Не знаю» она сказать не умеет и выбирает из тех классов, что есть. Уверенность – это не правильность.
- После добора до 30 кругов все пять новых кругов стали «Кругом» (97–100 %), овалы остались овалами.
Так работает перекос классов из раздела 7.5: три картинки против тридцати – это даже не один порядок.
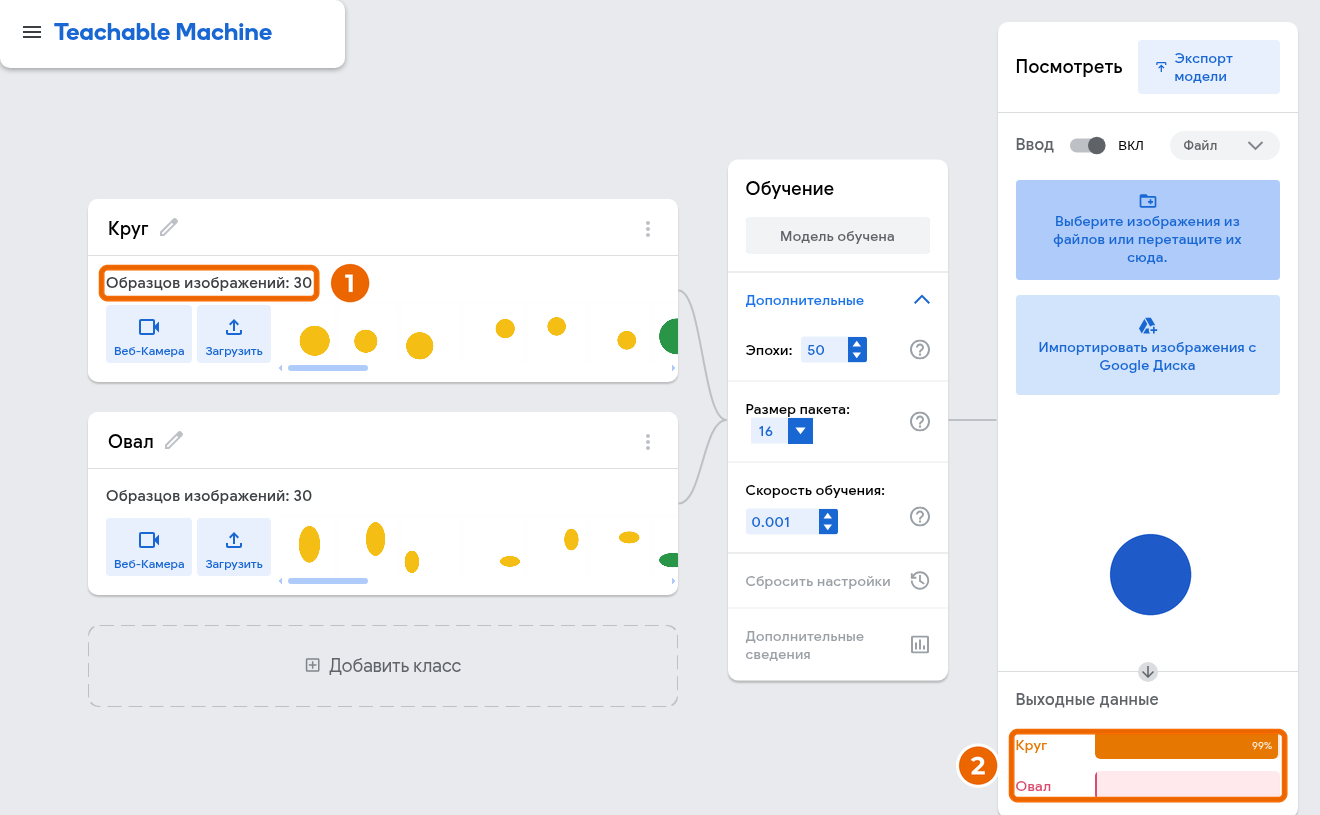
Если взять вместо овалов квадраты, перекос почти незаметен: у нас три круга и тридцать квадратов модель различила без единой ошибки, фигуры слишком разные. Перекос ломает модель там, где классы похожи: круг и овал, синица и снегирь у кормушки.
План на месяц до отбора
Если начинаешь в конце сентября, вот спокойный план: примерно по часу в день.
| Неделя | Что читаем | Что делаем |
|---|---|---|
| 1 | главы 1–3 | каждый день 3–4 разбора с задачами «Реши сам»; зарегистрироваться на курс сферы |
| 2 | главы 4–5 | открыть онлайн-Python или Colab, повторить код из разборов главы 5 |
| 3 | главы 6–7 | поставить GraphNet и Датавиз-конструктор по инструкциям курса, построить графики из разборов |
| 4 | глава 8 и шпаргалка | заново решить задачи, где были ошибки; пройти тест курса сферы (+5 баллов) |
Отбор длится до 10 ноября, и попыток две. Если первая попытка прошла неудачно, вернись к главам, где потерял баллы, и иди на вторую.
Родителям и наставникам
- Помогайте разбираться, но не решайте за ребёнка. И не давайте решать нейросети: на командном финале сразу видно, кто разобрался сам, а за кого решили. Лучше пусть ребёнок ошибётся на отборе и научится, чем попадёт в финал и растеряется там.
- Садитесь рядом на первых задачах. Детей чаще всего останавливает не сложность, а «программа не ставится», «что-то зависло» или «непонятно, куда нажать».
- ИИ-чаты – вместе со взрослым. Прочитайте правила сервиса: GigaChat, Алиса и DeepSeek рассчитаны на взрослых, а детям до 18 лет разрешают пользоваться ими с согласия родителей и под их присмотром. Договоритесь, что в чат не пишут имя, адрес, школу и фотографии. И проверяйте ответы вместе: нейросеть умеет уверенно ошибаться.
- Всё про регистрацию, бонусы и финал для Новосибирской области – на nto.kvantorium54.ru (вкладки «Я наставник» и «Я участник или родитель»).
- Региональный координатор НТО Юниоры в Новосибирской области – детский технопарк «Кванториум», info@kvantorium54.ru.
Честно об этой книге
Главное, что нужно знать про эту книгу: заданий отбора 2026/27 мы не видели – организаторы их заранее не показывают. Угадывать их бесполезно: наставники, которые следят за олимпиадой не первый год, говорят, что задания из года в год не повторяются. Поэтому книга учит темам из программы сферы и приёмам решения, а не готовит к конкретным задачам. Когда организаторы выложат пробные задания, мы сверим с ними книгу и выпустим новую версию.
Это не официальное издание НТО. Книгу составил методист «Кванториума» по открытым материалам олимпиады: программе сферы «Основы искусственного интеллекта и анализа данных» 2026/27, записям вебинаров сферы и разборам задач отборочных этапов прошлых лет (сфера тогда называлась «Технологии и виртуальные помощники», а потом «Технологии и искусственный интеллект»). Задачи прошлых лет пересказаны своими словами, с новыми числами и новыми ответами.
Разработчики предупредили, что GraphNet и Датавиз-конструктор к этому сезону обновились. Поэтому кнопки и окна этих программ мы описываем в общих чертах, а смысл – подробно: смысл от версии к версии не меняется. Точную инструкцию к новой версии смотри в курсе сферы.
Каждое число в ответах мы пересчитали на компьютере, а каждую программу запустили. Если ты всё-таки нашёл ошибку или что-то осталось непонятным, напиши автору: osinovsky.aa@kvantorium54.ru. Следующие версии книги станут лучше благодаря тебе.
Что такое искусственный интеллект
С этой главы начинается вся сфера. Формул здесь почти нет, зато есть слова, без которых дальше не прочитать ни одного условия: «признак», «обучающая выборка», «классификация», «вес нейрона», «точность». На отборе их проверяют так: сопоставь термины, определи тип задачи по описанию, посчитай точность модели по таблице ответов или выход нейрона по его весам. Задачи несложные, а баллы на них теряют из-за одного – путают похожие слова. Поэтому у каждого слова в главе есть свой пример.
1.1. Что такое ИИ и чем он не является
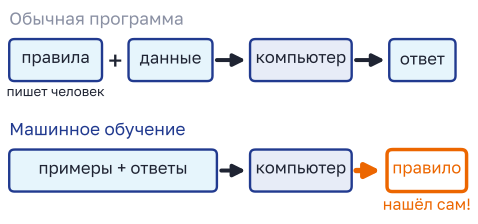
В обычной программе правило придумал человек. В машинном обучении компьютер находит правило сам – по примерам с ответами.
Сначала о слове «интеллект». Так называют умение решать новые задачи: узнавать, понимать, делать выводы. Ты узнаёшь друга в толпе, хотя он в новой шапке. Понимаешь фразу, которую никогда раньше не слышал. Это и есть интеллект.
Искусственный интеллект (ИИ) – это программы, которые решают задачи, для которых человеку нужен интеллект: узнать лицо на фото, понять речь, перевести текст, сыграть в шахматы, нарисовать картинку по описанию. Сами слова «искусственный интеллект» предложил американский учёный Джон Маккарти в 1955 году, когда готовил заявку на научный семинар. Сам семинар прошёл летом 1956 года.
Не путай ИИ с любой программой. Возьми школьный звонок: он звенит по расписанию, которое вбил завхоз. Это алгоритм – точная последовательность шагов, записанная человеком. Звонок ничего не узнаёт и ничему не учится. Так же устроены калькулятор, будильник, светофор, который переключается каждые 40 секунд. Всё это не ИИ.
Большинство нынешних ИИ-программ устроены по-другому. Им не пишут правило «кошка – это когда уши треугольником». Им показывают тысячи фотографий с подписями «кошка» и «не кошка», и программа сама находит, чем они отличаются. Такой способ называется машинное обучение (machine learning): компьютер учится на примерах. А самый мощный сегодня вид машинного обучения – нейросети, о них раздел 1.5.
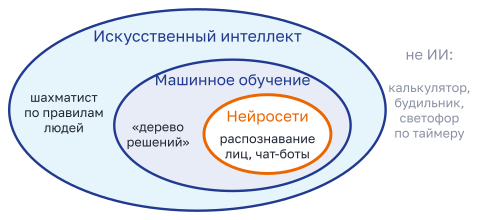
Получаются круги один в другом. Все нейросети – это машинное обучение, и всё машинное обучение – это ИИ. Но не наоборот: не весь ИИ – нейросети. Старые шахматные программы перебирали ходы по правилам, которые записали люди, – это ИИ, но без обучения. Бывают и модели, которые учатся на примерах, но обходятся без нейронов, например «дерево решений» – цепочка вопросов «да или нет», которую компьютер сам составил по таблице примеров.
Ещё два деления, которые любят спрашивать:
- Узкий и общий ИИ. Узкий умеет свои задачи: переводчик переводит, но не играет в шахматы. Общий ИИ умел бы всё, что умеет человек, и учился бы любому новому делу. Все системы, которые существуют сегодня, – узкие. Общий ИИ пока не создан, и учёные спорят, когда и как он появится.
- Генеративный и негенеративный ИИ. Генеративный создаёт новое: пишет текст, рисует картинку, сочиняет музыку. Так работают чат-боты GigaChat, Алиса и DeepSeek, когда пишут ответ на твой вопрос. Негенеративный распознаёт и предсказывает: узнаёт лицо, отличает спам от обычного письма, прогнозирует погоду. Он выбирает ответ, а не сочиняет его.
Где ИИ уже есть в твоей жизни:
- телефон разблокируется по твоему лицу;
- клавиатура подсказывает следующее слово;
- Алиса понимает, что ты сказал, и отвечает голосом;
- навигатор в машине родителей прикидывает, сколько минут ехать до школы с учётом пробок;
- почта сама убирает рекламу в папку «Спам»;
- лента видео подбирает ролики по тому, что ты досмотрел до конца;
- галерея телефона сама собирает фото в альбомы по лицам, хотя имён ты не вводил.
Чем ИИ не является. Он не думает, как человек, и ничего не «знает» о мире. Он находит закономерности в примерах, которые ему дали. Отсюда его слабости. Учили на плохих примерах – будет плохо работать. Попал в ситуацию, которой в примерах не было, – может ошибиться, причём очень уверенно. Чат-бот способен выдумать несуществующую книгу с автором и годом издания и выдать это спокойным тоном. Поэтому ответы ИИ всегда проверяют.
Запомни. ИИ – программы для задач, где человеку нужен интеллект. Машинное обучение – та часть ИИ, которая учится на примерах, а нейросети – часть машинного обучения. Если программа только выполняет правила, записанные человеком (звонок, калькулятор, светофор по таймеру), – это не ИИ.
1.2. Машинное обучение: учимся на примерах
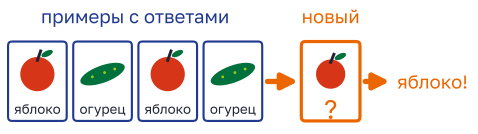
Никто не объяснял правило словами. Посмотрели на примеры с ответами – и новый предмет узнаётся сам.
Вспомни, как малыш учится отличать собаку от кошки. Ему не читают лекцию про форму ушей. Ему много раз показывают: «Это собака. А это кошка». Через месяц он уверенно тычет пальцем в незнакомую собаку во дворе. Машинное обучение устроено так же. Нужны примеры и правильные ответы к ним.
Примеры для машины записывают в таблицу. Одна строка – один объект: один день, один ученик, одна фотография, один астероид. Столбцы – то, что мы знаем про объект.
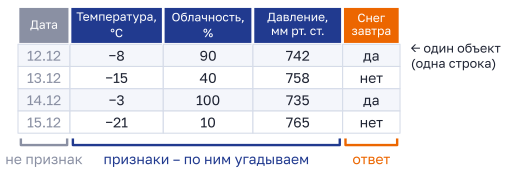
Столбцы бывают трёх видов:
- Признаки – то, по чему модель угадывает ответ. Здесь это температура, облачность и давление. Признак может быть числом (−8 °C) или словом (отсек «А», цвет «красный»).
- Ответ, или целевая переменная, – то, что модель должна научиться угадывать. Здесь – «снег завтра: да или нет». В обучающих примерах ответ известен, а для нового дня его как раз и предсказывают.
- Идентификаторы – номер, фамилия, код пропуска. Они нужны людям, чтобы отличать строки друг от друга, но ничего не говорят об ответе. Снег идёт не потому, что сегодня 12-е число. Перед обучением такие столбцы убирают: модель может «зацепиться» за номер строки и начать угадывать по нему, а это ерунда. Но если в коде зашиты свойства (в номере каюты – палуба и сторона борта), такой код может быть признаком: удаляют только то, что лишь называет строку.
Слово модель будет встречаться постоянно. Модель – это то, что получилось после обучения: правило, которое программа нашла в примерах и теперь применяет к новым объектам.
Учиться можно по-разному:
- Обучение с учителем – в примерах есть правильные ответы. Как в задачнике с ответами в конце: решил, сверился, исправился. Так решают классификацию и регрессию (раздел 1.3).
- Обучение без учителя – ответов нет совсем. Модели дают кучу объектов и просят найти в них порядок: разбить на похожие группы (кластеризация) или оставить меньше признаков, сохранив главное (снижение размерности: например, выбрать несколько главных цветов картины).
- Обучение с подкреплением – ответов нет, но есть награда и штраф. Так учат играть в игры: выиграл – молодец, упал в яму – минус очки. Играющий – агент, игра вокруг него – среда, очки – награда и штраф. Модель пробует снова и снова и выбирает действия, за которые хвалят.
Запомни. Строка таблицы – объект. Столбцы, по которым угадываем, – признаки, а столбец, который надо угадать, – ответ (целевая переменная). Номера и фамилии, которые лишь называют строку, – не признаки: перед обучением их удаляют вместе с ответом.
Совет. Спроси себя про каждый столбец: «Если я узнаю это значение, мне станет легче угадать ответ?» Температура – да, значит, признак. Номер строки – нет, значит, идентификатор.
1.3. Типы задач: классификация, регрессия, кластеризация
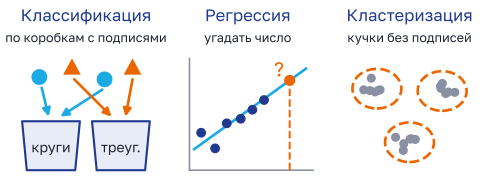
Классификация раскладывает по коробкам, на которых уже есть подписи. Регрессия угадывает число. Кластеризация сама находит кучки, и подписей у них нет.
Задачи машинного обучения делят на типы по тому, какой ответ нужно получить. На отборе тип часто спрашивают прямо: дано описание, выбери тип.
Классификация (classification) – отнести объект к одной из заранее известных групп (их называют классами). Письмо: спам или не спам. Снимок: кошка, собака или попугай. Астероид: опасен или нет. Классов может быть два (тогда ответ «да или нет») или больше, но список классов известен заранее.
Регрессия (regression) – предсказать число, которое можно измерить или посчитать: сколько сантиметров снега выпадет, сколько минут ехать до школы, сколько стоит квартира, какой будет температура. Такие числа можно сравнивать: 13 см больше 12 см, а прогноз 12 см при настоящих 13 см – почти попадание.
Кластеризация (clustering) – разбить объекты на группы похожих, когда правильных ответов нет. Никто заранее не говорил, какие будут группы и сколько их. Галерея телефона собирает фото одного и того же лица в альбом, хотя имени человека не знает, – это кластеризация. Магазин делит покупателей на группы по покупкам, чтобы понять, кто к ним ходит, – тоже она.
Как узнать тип по условию – два вопроса по порядку:
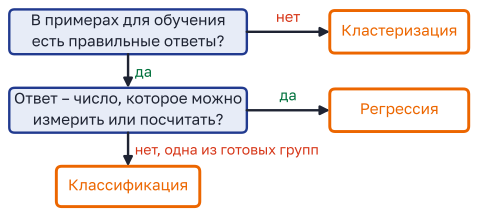
Смотри на ответ, а не на слова вокруг. Слово «прогноз» ничего не решает: «прогноз, пойдёт ли завтра снег» – классификация (да или нет), а «прогноз, сколько сантиметров снега выпадет» – регрессия.
Спотыкаются тут в двух местах. Бывает, что ответ записан цифрой, но это номер класса. «Отнести астероид к классу опасности 1, 2 или 3» – классификация: класс 2 не «вдвое больше» класса 1, а класса 2,5 не бывает. А бывает, что группы есть, но подписи неизвестны. «Разложи 500 снимков на кошек и собак» – классификация, если в обучающих снимках подписано, где кто. «Разложи 500 снимков на группы похожих» без подписей – кластеризация.
Запомни. Готовые группы и ответы в примерах – классификация. Число – регрессия. Ответов нет, ищем группы сами – кластеризация. Первым делом смотри, что должно получиться на выходе.
1.4. Обучающая и проверочная выборка
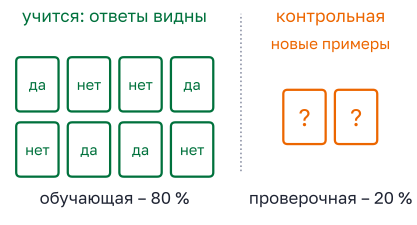
На одних примерах модель учится и видит ответы. На других – пишет контрольную. Задания контрольной заранее не показывают.
Допустим, у нас 1000 примеров с ответами. Если учить модель на всех 1000 и на них же проверять, мы ничего не узнаем. Модель могла просто запомнить ответы. Это как выучить наизусть ответы из конца задачника: на тех же задачах – пятёрка, а на контрольной с новыми числами – двойка.
Поэтому примеры заранее делят на две части. Каждую часть называют выборкой:
- Обучающая выборка (её ещё называют тренировочной) – на ней модель учится, ответы видны. Обычно это большая часть: 70–80 %.
- Проверочная выборка (тестовая) – её откладывают и во время обучения модели не показывают. Когда обучение закончено, модель отвечает на эти примеры, а мы сравниваем её ответы с настоящими.
Пример. Из 1000 примеров 80 % идут в обучающую выборку: . В проверочную – остальные: .
Когда модель отлично отвечает на обучающих примерах и плохо на новых, говорят, что она переобучилась: вызубрила примеры вместо того, чтобы понять закономерность. Заметить это можно только на новых примерах – вот почему точность модели считают на проверочной выборке, а не на обучающей.
Запомни. Обучающая выборка – учимся, проверочная – сдаём экзамен. Проверочные примеры модель при обучении не видит. Точность, которой можно верить, – только на проверочной выборке.
1.5. Нейрон – весы с порогом
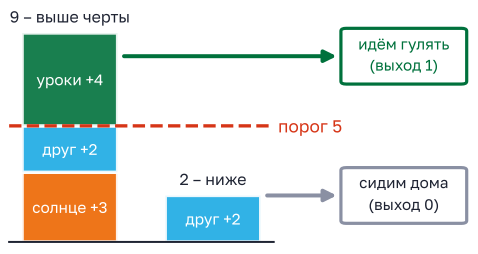
Каждая причина «за» – кубик своей высоты. Башня выросла выше черты – решение «да». Не доросла – «нет».
Как ты решаешь, пойти ли гулять? У каждой причины свой «вес». Солнце – приятно, +3. Друг свободен – +2. Уроки уже сделаны – сразу +4, это важнее всего. Складываешь то, что совпало, и сравниваешь с внутренней чертой – порогом. Набралось 9, а порог 5 – идёшь. Свободен только друг – всего 2, сидишь дома.
Так же устроен искусственный нейрон – маленький кирпичик нейросети:
- На вход приходят числа – это признаки объекта. Часто это 1 («да, есть») и 0 («нет»), но бывают и любые числа: температура, высота камня.
- У каждого входа есть вес – число, которое говорит, насколько этот вход важен. Большой вес – сильно влияет, маленький – слабо. Отрицательный вес тянет против: мороз −30 °C – повод не идти на улицу.
- Нейрон умножает каждый вход на его вес и всё складывает. Получается сумма .
- Сумму сравнивают с порогом . Если не меньше порога – на выходе 1, иначе 0.
Словами: сумма равна первому входу, умноженному на свой вес, плюс второму, умноженному на свой вес, и так далее. Буквами:
Если – на выходе 1. Если – на выходе 0. Здесь – входы, – веса, – порог, знак читается «больше или равно».
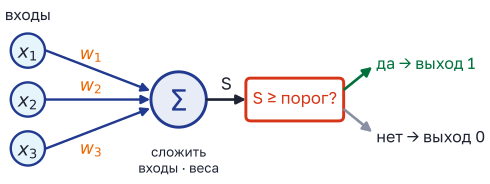
Пример. Нейрон решает, идти ли гулять: (солнце), (друг свободен), (уроки сделаны), порог . Сегодня солнца нет, друг свободен, уроки сделаны: . . – выход 1, идём гулять.
Тот же расчёт на Python. Если ты ещё не писал программ, читай по строчке:
w = [3, 2, 4]              # веса: солнце, друг, уроки
x = [0, 1, 1]              # входы: 1 – да, 0 – нет
T = 5                      # порог

S = 0                      # сумма пока равна нулю
for xi, wi in zip(x, w):   # берём пары «вход – вес» по очереди
    S = S + xi * wi        # добавляем к сумме вход, умноженный на вес
if S >= T:
    print(S, "выход 1")
else:
    print(S, "выход 0")
# 6 выход 1wиx– списки: несколько чисел в квадратных скобках через запятую.- Всё после знака
#– комментарий, пояснение для человека. Компьютер его пропускает. zip(x, w)складывает два списка в пары: (0 и 3), (1 и 2), (1 и 4).forпроходит по этим парам, и строка с отступом под ним повторяется для каждой пары. После трёх повторов вSлежит .if S >= T:– «если сумма больше или равна порогу»,else:– «иначе».printвыводит на экран.
Опытные программисты пишут сумму в одну строку: S = sum(xi * wi for xi, wi in zip(x, w)). Это то же самое, sum складывает все произведения. Такая запись встретится в проверках ниже.
Как нейрон учится. Сначала веса ставят наугад, и нейрон отвечает невпопад. На каждом обучающем примере его ответ сравнивают с правильным. Ошибся – веса чуть-чуть подкручивают так, чтобы ответ стал ближе к верному. Тысячи таких поправок – и веса становятся «правильными». Вот что значит «модель обучилась»: подобрались веса. Первый такой обучаемый нейрон – перцептрон – построил американский учёный Фрэнк Розенблатт в 1957 году.
Нейросеть – это много нейронов, соединённых слоями. Выход одних нейронов – вход для следующих.
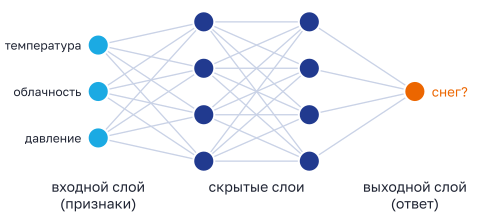
- Входной слой получает признаки объекта: сколько признаков, столько входов.
- Скрытые слои – нейроны внутри сети. Их не видно снаружи, отсюда название. Чем их больше, тем более сложные закономерности сеть может уловить.
- Выходной слой выдаёт ответ: «снег да или нет», номер класса, число.
Правило, по которому нейрон превращает сумму в свой выход, называется функцией активации. Наш порог «1 или 0» – самая простая функция активации, ступенька.
Для любопытных. В настоящих нейросетях ступенька встречается редко: она слишком резкая, и подкручивать веса по ней неудобно. Часто берут функцию ReLU: отрицательную сумму она заменяет нулём, а положительную пропускает как есть. Сумма −3 даст 0, сумма 2,5 даст 2,5. Вместо порога часто пишут смещение : выход 1, если . Это одно и то же: порог 5 – всё равно что смещение −5.
Запомни. Нейрон: умножь каждый вход на его вес, сложи, сравни сумму с порогом. – выход 1, иначе 0. Отрицательный вес работает «против». Обучение – это подбор весов.
Совет. Считай нейрон по строчке для каждого входа: «1 · 5 = 5, 0 · 2 = 0, 1 · (−3) = −3». Отрицательный вес пиши в скобках – так минус не потеряется. И проверь по условию, что делать при ровно равном порогу.
Если проверяешь кодом, а веса дробные, есть ловушка. Компьютер хранит десятичные дроби чуть-чуть неточно: 1.5 * 1.2 он считает как 1.7999999999999998. Обычно это незаметно. Но когда сумма ровно на пороге, ошибка решает ответ: 0.9999999999999998 >= 1 – это False, выход 0 вместо 1. Так что на границе досчитай вручную или округли сумму перед сравнением: S = round(S, 6) оставит 6 знаков после точки.
1.6. Точность и ошибка
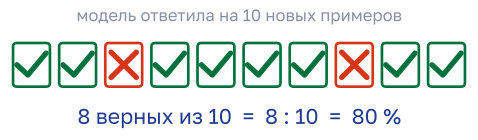
Точность – доля верных ответов. Восемь верных из десяти – это 80 %.
Обучили модель – как понять, хороша ли она? Даём ей проверочную выборку, записываем её ответы рядом с настоящими и отмечаем, где угадала, а где нет.
| № | На самом деле | Ответ модели | Угадала? |
|---|---|---|---|
| 1 | спам | спам | да |
| 2 | не спам | не спам | да |
| 3 | не спам | спам | нет |
| 4 | спам | спам | да |
| 5 | не спам | не спам | да |
Точность (accuracy) – доля верных ответов. Словами: точность равна числу верных ответов, делённому на число всех ответов. Обычно её переводят в проценты:
В таблице верных ответов 4 из 5: %. Доля ошибок – всё остальное: %, то есть одна ошибка из пяти.
Ту же точность можно посчитать программой – удобно, когда примеров сотня. Счётчик vernyh сначала равен 0. Запись vernyh += 1 – короткое vernyh = vernyh + 1: прибавить единицу. Двойное == значит «равно ли?». len – длина списка, то есть сколько в нём элементов:
nastoyashchie = ["спам", "не спам", "не спам", "спам", "не спам"]
otvety_modeli = ["спам", "не спам", "спам", "спам", "не спам"]

vernyh = 0
for a, b in zip(nastoyashchie, otvety_modeli):
    if a == b:              # ответ модели совпал с настоящим
        vernyh += 1
print(vernyh, "из", len(nastoyashchie))                   # 4 из 5
print("точность", vernyh / len(nastoyashchie) * 100, "%")  # точность 80.0 %
И ошибки не все одинаковые. Модель может пропустить – сказать «не спам» про настоящий спам. А может поднять ложную тревогу – назвать спамом письмо от бабушки. В таблице выше одна ошибка, и это ложная тревога (строка 3). Для почты ложная тревога хуже: письмо бабушки уйдёт в спам, и его никто не прочтёт.
Ловушка редких случаев. Представь: из 100 астероидов опасен один. «Ленивая» модель на всё отвечает «не опасен» – и угадывает 99 раз из 100, точность 99 %. Звучит отлично, а толку ноль: единственный опасный астероид она пропустила. Поэтому, когда один класс встречается редко, смотрят не только на точность, но и на то, сколько редких случаев модель нашла.
Ошибка в регрессии. Когда модель предсказывает число, «угадала или нет» не подходит: прогноз −12 °C при настоящих −11 °C почти верный. Здесь считают, на сколько модель ошиблась в каждом примере (разность без знака минус), и находят среднюю ошибку. Прогноз −10, −9, −13 при настоящих −12, −8, −13: ошибки 2, 1 и 0, средняя градус. Чем меньше средняя ошибка, тем лучше модель. Правило, по которому считают ошибку модели, называют функцией потерь (loss), а число, по которому модели сравнивают, – метрикой. Точность и средняя ошибка – две самые простые метрики.
Запомни. Точность = верных : всего · 100 %. Доля ошибок = 100 % − точность. Считаем на проверочной выборке. Для регрессии – средняя ошибка: насколько в среднем промахнулись, без учёта знака.
Совет. Сначала заполни столбец «угадала?» для каждой строки, потом считай галочки. Не пытайся найти ошибки, скользя взглядом по двум столбцам сразу, – одну обязательно пропустишь. Итог проверь: верных + неверных = всего.
1.7. Разбираем задачи
Задача 1.1 Какой это тип задачи
Сопоставь каждую задачу с её типом: 1 – классификация, 2 – регрессия, 3 – кластеризация.
А. По скорости и размеру астероида отнести его к одному из трёх классов опасности: 1, 2 или 3 (в обучающих примерах класс указан).
Б. Предсказать, сколько сантиметров снега выпадет завтра в Новосибирске.
В. Разбить 5000 снимков звёздного неба на группы похожих; какие будут группы, заранее неизвестно.
Г. По письму определить, спам это или нет.
Д. По температуре и заряду аккумулятора лунохода предсказать, сколько минут он проработает до разрядки.
Е. Разделить покупателей магазина на группы по их покупкам, ничего не зная о покупателях заранее.
Ответ запиши как шесть цифр подряд – по порядку для А, Б, В, Г, Д, Е.
Дано: шесть описаний задач.
Найти: тип каждой.
Шаг 1. Правило. Для каждой задачи задаём два вопроса из раздела 1.3. Есть ли в примерах правильные ответы? Если есть – что получается на выходе: число или одна из готовых групп?
Шаг 2. А. Ответ – класс 1, 2 или 3, список классов известен, в примерах он указан. Цифры здесь – имена классов, а не величины: класса 2,5 не бывает. Классификация – 1.
Шаг 3. Б. Ответ – число сантиметров, может быть и 12,5. Регрессия – 2.
Шаг 4. В. Правильных ответов нет, группы надо найти самим. Кластеризация – 3.
Шаг 5. Г. Два готовых класса: «спам» и «не спам». Классификация – 1.
Шаг 6. Д. Ответ – число минут. Регрессия – 2.
Шаг 7. Е. Ответов нет, группы неизвестны. Кластеризация – 3.
Перепроверь кластеризацию. Только в В и Е прямо сказано, что групп заранее никто не знает. В остальных четырёх ответы в примерах есть, значит, там классификация или регрессия.
Ошибка номер один – записать задачу А в регрессию, потому что ответ – цифра. Цифра – ещё не число-величина: номер класса, номер автобуса, номер отсека – это имена. А задачу В часто принимают за классификацию из-за слова «группы». Группы в классификации известны заранее и подписаны, а здесь их надо найти.
Ответ: 123123.
Своя задача по программе сферы, модуль 1
Реши сам
1.1. Определи тип задачи (1 – классификация, 2 – регрессия, 3 – кластеризация): а) по росту и весу собаки предсказать её возраст в годах; б) по записи голоса птицы определить, кто поёт: синица, воробей или снегирь (в обучающих записях это подписано); в) разложить 300 снимков комет на группы похожих, не зная заранее, какие будут группы; г) предсказать, сколько человек придёт на новогоднюю ёлку в Академгородке. Ответ – четыре цифры подряд.
ответ1.2. Какие из этих устройств и программ используют машинное обучение (учились на примерах)? 1) калькулятор в телефоне; 2) разблокировка телефона по лицу; 3) светофор, который переключается каждые 40 секунд; 4) голосовой помощник, который распознаёт твою речь; 5) электрочайник, который выключается при закипании; 6) лента видео, которая подбирает ролики по тому, что ты смотрел. Запиши номера в порядке возрастания.
ответЗадача 1.2 Какие столбцы убрать
Врач лунной базы хочет научить модель предсказывать, заболеет ли житель базы простудой в ближайший месяц. У него есть таблица:
| Номер пропуска | Имя | Возраст | Отсек | Спорт, ч в неделю | Сон, ч в сутки | Заболел за месяц |
|---|---|---|---|---|---|---|
| 1041 | Ирина | 34 | А | 5 | 7 | нет |
| 1057 | Олег | 41 | Б | 1 | 6 | да |
| 1063 | Самир | 28 | А | 3 | 8 | нет |
а) Какой столбец – целевая переменная? б) Какие столбцы нужно удалить, чтобы остались только признаки? в) Какой это тип задачи?
Дано: таблица из семи столбцов.
Найти: целевую переменную, лишние столбцы, тип задачи.
Шаг 1. Что угадываем. Врач хочет знать, заболеет ли человек. В таблице это столбец «Заболел за месяц» – наша целевая переменная (ответ).
Шаг 2. Идентификаторы. Проверяем каждый столбец вопросом «помогает ли это угадать ответ?». Номер пропуска – нет: 1057 не болеет чаще, чем 1041. Имя – тоже нет: простуда не выбирает людей по имени. Это идентификаторы.
Шаг 3. Признаки. Возраст, часы спорта, часы сна – могут влиять на здоровье, это признаки. Отсек записан буквой, но и он может влиять: вдруг в отсеке Б сквозняк. Буква – не повод удалять столбец. Признак.
Шаг 4. Что удалить. Чтобы остались только признаки, убираем ответ и два идентификатора: «Номер пропуска», «Имя», «Заболел за месяц». Остаются четыре признака.
Шаг 5. Тип. Ответ – «да» или «нет», два готовых класса, в примерах они указаны. Классификация.
Пересчитаем. признака: возраст, отсек, спорт, сон. И про каждый легко представить, как он связан с простудой.
Типичная ошибка. Удалить «Отсек», потому что там не число, и забыть удалить ответ. Если оставить «Заболел за месяц» среди признаков, модель будет «угадывать» ответ, подглядывая в сам ответ, – на обучении у неё будет 100 %, а на новом человеке (у которого этого столбца ещё нет) она работать не сможет.
Ответ: а) «Заболел за месяц»; б) «Номер пропуска», «Имя», «Заболел за месяц»; в) классификация.
Своя задача по программе сферы, модуль 3
Реши сам
1.3. Наставник кружка хочет по таблице предсказать, пройдёт ли ученик в финал олимпиады. Столбцы таблицы: «Фамилия», «Номер в журнале», «Класс», «Часов занятий в неделю», «Решено задач на пробном туре», «Прошёл в финал». Какие столбцы нужно удалить, чтобы остались только признаки? Какой это тип задачи?
ответ1.4. Сопоставь термины и определения. Термины: 1) обучающая выборка; 2) проверочная выборка; 3) признак; 4) целевая переменная; 5) идентификатор. Определения: А) столбец, значение которого модель должна угадать; Б) примеры, которые модели не показывают во время обучения, чтобы потом оценить её; В) столбец, по которому различают строки, но который ничего не говорит об ответе; Г) примеры с ответами, на которых модель учится; Д) свойство объекта, по которому модель угадывает ответ. Ответ запиши как пять букв по порядку для терминов 1–5.
ответЗадача 1.3 Модель ищет метеоры
Камера обсерватории снимает ночное небо, а модель решает, есть на снимке метеор (М) или нет (Н). Модель проверили на 12 снимках проверочной выборки:
| Снимок | На самом деле | Ответ модели |
|---|---|---|
| 1 | М | М |
| 2 | Н | Н |
| 3 | Н | М |
| 4 | М | М |
| 5 | М | Н |
| 6 | Н | Н |
| 7 | Н | Н |
| 8 | М | Н |
| 9 | Н | Н |
| 10 | Н | Н |
| 11 | М | М |
| 12 | Н | Н |
а) Найди точность модели в процентах. б) Сколько настоящих метеоров модель пропустила?
Дано: 12 снимков, настоящие ответы и ответы модели.
Найти: точность, %; число пропущенных метеоров.
Шаг 1. Отмечаем каждую строку. Идём по снимкам сверху вниз и сравниваем два столбца таблицы:
- совпали – снимки 1, 2, 4, 6, 7, 9, 10, 11, 12;
- не совпали – снимок 3 (на самом деле Н, модель – М), снимки 5 и 8 (на самом деле М, модель – Н).
Шаг 2. Считаем. Неверных ответов 3 (снимки 3, 5, 8), верных .
Шаг 3. Точность. %.
Шаг 4. Какие это ошибки. На снимке 3 метеора не было, а модель сказала «М» – ложная тревога. На снимках 5 и 8 метеор был, а модель сказала «Н» – это пропуски. Пропущено 2 метеора.
Сверим с другой стороны. Всего настоящих метеоров 5 (снимки 1, 4, 5, 8, 11). Модель нашла 3 из них и пропустила 2: – сходится. Ошибок 3 из 12 – четверть, и точность 75 % – как раз три четверти.
Где ошибаются. Считают только снимки с метеорами: «нашла 3 из 5 – точность 60 %». Точность – доля верных ответов среди всех снимков, и снимки без метеора, где модель правильно промолчала, тоже считаются верными. А в пункте б) все 3 ошибки записывают в пропуски, хотя снимок 3 – это ложная тревога.
Ответ: а) 75 %; б) 2 метеора.
Своя задача по программе сферы, модуль 1
Реши сам
1.5. Модель 10 дней предсказывала, пойдёт ли снег (С – снег, Н – нет):
| День | На самом деле | Прогноз модели |
|---|---|---|
| 1 | С | С |
| 2 | Н | С |
| 3 | Н | Н |
| 4 | С | С |
| 5 | С | Н |
| 6 | Н | Н |
| 7 | С | С |
| 8 | Н | С |
| 9 | Н | Н |
| 10 | С | С |
а) Найди точность модели в процентах. б) Сколько раз модель обещала снег, а его не было?
ответ1.6. В проверочной выборке 400 астероидов, из них опасных только 12. «Ленивая» модель про любой астероид отвечает «не опасен». а) Какова её точность в процентах? б) Сколько опасных астероидов она пропустит?
ответ1.7. Две модели 5 дней предсказывали температуру ночью. Настоящая температура: −12, −8, −15, −20, −5 °C. Модель А предсказала: −10, −9, −12, −21, −7. Модель Б: −12, −6, −15, −16, −5. Найди среднюю ошибку каждой модели (в градусах, без учёта знака) и назови лучшую модель.
ответЗадача 1.4 Открывать ли купол телескопа
Нейрон решает, открывать ли купол телескопа на ночь. Входы (1 – да, 0 – нет) и их веса:
- – небо ясное, вес ;
- – ветер слабый, вес ;
- – полная Луна (засвечивает небо), вес ;
- – в обсерватории есть дежурный, вес .
Порог . Если сумма не меньше порога, выход 1 – купол открывают, иначе 0. Что ответит нейрон в три ночи?
- Ночь 1: ясно, ветер сильный, полная Луна, дежурный есть.
- Ночь 2: ясно, ветер слабый, Луна не полная, дежурный есть.
- Ночь 3: облачно, ветер слабый, Луна не полная, дежурный есть.
Ответ запиши тремя цифрами подряд – выходы нейрона в ночи 1, 2, 3.
Дано: ; ; три набора условий.
Найти: выход нейрона для каждой ночи.
Шаг 1. Переводим слова во входы. Каждое условие – 1, если оно выполнено, и 0, если нет. Внимательно с : вход означает «ветер слабый», значит, сильный ветер – это 0.
- Ночь 1: .
- Ночь 2: .
- Ночь 3: .
Шаг 2. Ночь 1. . – выход 0. Полная Луна «отняла» 3, и ясного неба не хватило.
Шаг 3. Ночь 2. . – выход 1.
Шаг 4. Ночь 3. . – выход 0.
Проверка кодом.
w = [5, 2, -3, 3]
T = 6
for x in ([1, 0, 1, 1], [1, 1, 0, 1], [0, 1, 0, 1]):
    S = sum(xi * wi for xi, wi in zip(x, w))
    print(S, 1 if S >= T else 0)   # 1, если S ≥ T, иначе 0
# 5 0
# 10 1
# 5 0
А если без чисел? Купол открыли только в ясную безлунную ночь. Через облака смотреть нечего, так что ночь 3 – правильно «нет». Нейрон ведёт себя как разумный астроном.
Главная ловушка – потерять минус у веса −3 и получить в ночь 1 сумму – «открываем». Бывает и так: ставят в ночь 1, потому что «про ветер что-то сказано». Вход равен 1, только когда выполнено именно то, что написано в таблице.
Ответ: 010.
Своя задача по программе сферы, модуль 1
Реши сам
1.8. Нейрон решает, ехать ли в выходной кататься на лыжах. Входы (1 – да, 0 – нет) и веса: выпал свежий снег – 4; мороз сильнее −25 °C – (−6); сегодня выходной – 3; лыжи смазаны – 1. Порог 5, при сумме не меньше порога выход 1. Что ответит нейрон в три дня? День 1: свежий снег, мороз слабый, выходной, лыжи не смазаны. День 2: свежий снег, мороз −30 °C, выходной, лыжи смазаны. День 3: снега нового нет, мороз слабый, выходной, лыжи смазаны. Ответ – три цифры подряд.
ответ1.9. У нейрона три входа: , , . Веса: , , . Порог ; если сумма не меньше порога, выход 1, иначе 0. Найди сумму и выход нейрона.
ответЗадача 1.5 Облака на снимках
Метеостанция собрала 2400 снимков неба с подписями «будет дождь» или «не будет». 75 % снимков отдали в обучающую выборку, остальные – в проверочную. На проверочной выборке модель ошиблась на 42 снимках. Найди точность модели на проверочной выборке в процентах.
Дано: всего 2400 снимков; обучающая выборка – 75 %; ошибок на проверочной – 42.
Найти: точность, %.
Шаг 1. Где считаем точность. На проверочной выборке. Значит, сначала узнаём, сколько в ней снимков.
Шаг 2. Обучающая выборка. снимков.
Шаг 3. Проверочная выборка. снимков. (Или сразу: %, .)
Шаг 4. Верные ответы. .
Шаг 5. Точность. %.
Проверка разумности. 42 ошибки из 600 – ошибается примерно на каждом четырнадцатом снимке. % ошибок, и .
Типичная ошибка. Разделить на все 2400 снимков: %. На обучающих снимках модель не проверяли, ошибки на них никто не считал. Ещё обиднее – ответить «7 %»: это доля ошибок, а спрашивали точность.
Ответ: 93 %.
Своя задача по программе сферы, модуль 1
Реши сам
1.10. В наборе данных 1500 записей о погоде. 80 % из них – обучающая выборка, остальные – проверочная. Сколько записей в проверочной выборке?
ответ1.11. Точность модели на проверочной выборке из 240 примеров – 85 %. На скольких примерах модель ошиблась?
ответЗадача 1.6 Чат-бот школьной библиотеки
Чат-бот библиотеки должен понимать, чего хочет читатель. Разработчики задали ему три интента (намерения): «Посоветуй книгу» (П), «Часы работы» (Ч), «Продлить книгу» (Д). Для каждого интента написали по десятку тренировочных фраз, и бот на них обучился. Потом бота проверили на 10 новых фразах (после фразы – нужный интент и то, что решил бот):
- «Что бы почитать про космос?» – нужен П, бот решил П.
- «Во сколько вы открываетесь в субботу?» – нужен Ч, бот решил Ч.
- «Можно подержать «Незнайку» ещё неделю?» – нужен Д, бот решил П.
- «Библиотека работает в каникулы?» – нужен Ч, бот решил Ч.
- «Посоветуй фантастику» – нужен П, бот решил П.
- «Хочу сдать книгу позже» – нужен Д, бот решил Д.
- «До скольки сегодня можно прийти?» – нужен Ч, бот решил Ч.
- «Есть что-нибудь смешное для 6 класса?» – нужен П, бот решил П.
- «Продли мне, пожалуйста, книгу» – нужен Д, бот решил Д.
- «Когда можно прийти за книгой про динозавров?» – нужен Ч, бот решил П.
а) Какой тип задачи машинного обучения решает бот, когда выбирает интент? б) Найди точность бота на этих фразах в процентах. в) Разработчики добавили фразу № 3 в тренировочные фразы интента «Продлить книгу», снова обучили бота и проверили на тех же 10 фразах. Получилось 90 %. Можно ли считать, что бот стал понимать читателей лучше на 10 %? Ответь «да» или «нет».
Дано: 3 интента; 10 проверочных фраз с нужным интентом и ответом бота.
Найти: тип задачи; точность, %; можно ли верить 90 %.
Шаг 1. Тип задачи. Бот относит фразу к одной из трёх заранее известных групп, а в тренировочных фразах для каждой указан правильный интент. Это классификация (на три класса).
Шаг 2. Отмечаем ответы. Сравниваем нужный интент с ответом бота. Не совпали фразы 3 (нужно Д, бот – П) и 10 (нужно Ч, бот – П). Верных .
Шаг 3. Точность. %.
Шаг 4. Почему бот ошибся. В фразе 3 есть название книги, и бот зацепился за него: «про книгу – значит, советовать». В фразе 10 тоже есть «книга», хотя спрашивают о времени. Бот часто реагирует на отдельные слова, а не на смысл.
Шаг 5. Можно ли верить 90 %. Фраза 3 теперь стала тренировочной: бот видел её вместе с правильным ответом. Когда мы снова проверяем на ней, это уже не контрольная, а задача, ответ к которой бот подсмотрел. Выросла точность только за счёт подсмотренной фразы. Узнать, стал ли бот лучше понимать новых читателей, можно только на фразах, которых он не видел. Ответ – нет.
Много это или мало? 2 ошибки из 10 – каждая пятая фраза уходит не туда. Для чат-бота это заметно: из пяти читателей один получит странный ответ. Есть что улучшать.
Самая частая ошибка – в пункте в) ответить «да, ведь 90 больше 80». Проверочные примеры нельзя подкладывать в обучение: иначе точность выходит красивой, но ничего не говорит о новых фразах. В пункте а) – назвать задачу кластеризацией, потому что «бот раскладывает фразы по группам». Группы здесь заданы заранее и подписаны – значит, классификация.
Ответ: а) классификация; б) 80 %; в) нет.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Dialogflow. Книгомания»
Совет. В исходной задаче отбора бота-рекомендателя книг собирали в сервисе Dialogflow: создавали интенты, задавали тренировочные фразы и проверяли бота новыми вопросами в окне справа. Сервиса у тебя может и не быть, но идея та же, что в любой классификации: тренировочные фразы – обучающая выборка, новые вопросы – проверочная.
Реши сам
1.12. Модель, которая отличает снимки галактик от снимков звёзд, проверили на 50 снимках. Верно она ответила на 43. Найди её точность в процентах.
ответ1.13. Верно (В) или неверно (Н)? 1) Все нейросети относятся к искусственному интеллекту. 2) Любая программа с командой «если… то…» – это искусственный интеллект. 3) Для кластеризации в примерах нужны правильные ответы. 4) Проверочную выборку не показывают модели во время обучения. 5) Если модель ответила верно на все примеры обучающей выборки, она точно будет хорошо работать на новых данных. Ответ – пять букв подряд.
ответЗадача 1.7* Порог для лунохода
Луноход решает, объезжать камень или ехать прямо. Нейрон получает два числа: – высота камня в сантиметрах, – крутизна склона в градусах. Веса: , . Если сумма не меньше порога , выход 1 – «объезжать», иначе 0 – «ехать прямо». Порог – целое число, его надо подобрать по пяти примерам, где инженеры уже знают правильный ответ:
| № | Высота камня, см | Крутизна, ° | Ответ |
|---|---|---|---|
| 1 | 10 | 5 | ехать прямо |
| 2 | 15 | 12 | объезжать |
| 3 | 8 | 20 | объезжать |
| 4 | 12 | 6 | ехать прямо |
| 5 | 5 | 18 | ехать прямо |
Сколько существует целых значений порога, при которых нейрон отвечает верно на все пять примеров? Укажи также наименьшее и наибольшее из них.
Дано: , ; пять примеров с ответами; – целое.
Найти: сколько целых подходят, наименьшее и наибольшее .
Шаг 1. Что происходит. Порог – черта. Для «объезжать» сумма должна быть не ниже черты, для «ехать прямо» – ниже. Значит, сначала посчитаем сумму для каждого примера, а потом найдём, куда можно провести черту.
Шаг 2. Суммы. :
- № 1: (ехать прямо);
- № 2: (объезжать);
- № 3: (объезжать);
- № 4: (ехать прямо);
- № 5: (ехать прямо).
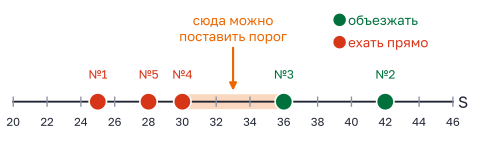
Шаг 3. Условие для «объезжать». Нужно для примеров 2 и 3. Самая маленькая из этих сумм – 36. Если , то и . Значит, .
Шаг 4. Условие для «ехать прямо». Нужно для примеров 1, 4, 5. Самая большая из этих сумм – 30. Если , то и 25, и 28 меньше . Значит, , то есть целое не меньше 31.
Шаг 5. Собираем. Подходят целые от 31 до 36: 31, 32, 33, 34, 35, 36. Их .
Шаг 6. Проверяем края. : пример 4 даёт – «прямо», верно; пример 3 даёт – «объезжать», верно. : пример 3 даёт – «объезжать», верно (равенство считается за «да»). уже не подходит: , и нейрон скажет про камень № 3 «прямо». тоже не подходит: , и про камень № 4 выйдет «объезжать».
Проверка кодом.
# (высота, крутизна, правильный ответ): 1 – объезжать, 0 – ехать прямо
primery = [(10, 5, 0), (15, 12, 1), (8, 20, 1), (12, 6, 0), (5, 18, 0)]
podhodyat = []                      # сюда соберём подходящие пороги
for T in range(0, 100):             # пробуем все пороги от 0 до 99
    vse_verno = True
    for h, k, otvet in primery:
        S = 2 * h + 1 * k
        vyhod = 1 if S >= T else 0
        if vyhod != otvet:          # != значит «не равно»: нейрон ошибся
            vse_verno = False
    if vse_verno:
        podhodyat.append(T)         # append добавляет число в конец списка
print(podhodyat, len(podhodyat))    # [31, 32, 33, 34, 35, 36] 6
Почему порогов целых шесть. Примеров всего пять, и на этих камнях все шесть порогов отвечают одинаково. Разница появится на новом камне: высота 11 см, склон 10° дают . При пороге 31 нейрон скажет «объезжать», при пороге 33 – «ехать прямо». Вот инженеры и собирают побольше примеров: каждый новый пример сужает промежуток.
Частый промах – записать и включить 30 в ответ – тогда пример 4 окажется «объезжать», потому что . Где стоит знак «не меньше», а где «меньше», решает условие задачи, – проверяй границы подстановкой. А на самом финише теряют балл так: считают количество как и забывают, что оба края входят.
Ответ: 6 значений, от 31 до 36.
Своя задача по программе сферы, модуль 1
Реши сам
1.14. Дрон доставки решает, лететь или переждать непогоду. Нейрон получает два числа: – скорость ветра в м/с, – сила дождя в баллах. Веса: , . Если сумма не меньше порога , выход 1 – «переждать», иначе 0 – «лететь». Порог – целое число. Примеры с правильными ответами: ветер 4, дождь 1 – лететь; ветер 6, дождь 3 – переждать; ветер 2, дождь 5 – лететь; ветер 7, дождь 1 – переждать; ветер 5, дождь 2 – лететь. Сколько существует целых значений порога, при которых нейрон отвечает верно на все пять примеров? Укажи наименьшее и наибольшее из них.
ответ1.15.* У нейрона два входа, вес первого , вес второго неизвестен, но это целое число. Порог , при сумме не меньше порога выход 1. Известны три примера: при входах выход 1; при входах выход 0; при входах выход 1. Найди . Что ответит нейрон на входы ?
ответМножества и логика
Когда ты выбираешь в интернет-магазине фильтры «синий» и «до 1000 рублей», сайт ищет пересечение двух множеств. Когда спам-фильтр решает, пустить письмо во «Входящие» или нет, он проверяет правило из связок И, ИЛИ, НЕ. В этой главе научимся считать элементы, когда группы пересекаются, рисовать круги Эйлера и читать логические правила. На отборе такие задачи обычно короткие: история про книги, кружки или поисковые запросы, а в ответ вводится одно число или выбирается вариант.
2.1. Множество и его элементы
Всё, что лежит внутри обруча, – элементы множества. Обруч поменьше внутри большого – подмножество.
Множество – это набор каких-то предметов, собранных вместе по одному признаку. Игрушки в коробке, ученики твоего класса, буквы в слове, книги в школьной библиотеке – всё это множества. Каждый предмет из набора называется элементом множества. Мяч – элемент множества «игрушки в коробке», а твой сосед по парте – элемент множества «ученики 6 «Б»».
Множество записывают в фигурных скобках: . Два правила отличают множество от обычного списка:
- порядок не важен: и – одно и то же множество;
- повторов нет: каждый элемент либо есть в множестве, либо его нет. В слове «КОЛОКОЛ» семь букв, но множество его букв – всего , три элемента.
Число элементов множества обозначают . Для игрушек , для букв слова «КОЛОКОЛ» – 3. Бывает и пустое множество – в нём нет ни одного элемента, . Например, множество учеников твоего класса ростом больше трёх метров.
Множество можно задать двумя способами. Можно перечислить элементы: . А можно описать правилом: «чётные числа от 1 до 9». Получится то же самое. Правилом удобнее, когда элементов много: «все книги библиотеки с отметкой 10+» перечислять долго, а описать можно одной строкой.
Подмножество – часть множества: каждый его элемент есть и в большом множестве. Игрушки с колёсами – подмножество игрушек в коробке. Девочки 6 «Б» – подмножество учеников 6 «Б». Два особых случая математики тоже считают подмножествами: всё множество целиком и пустое множество – в нём нет ни одного «чужого» элемента.
Зачем это ИИ? Нейросеть, которая учится узнавать котов на фото, получает набор данных – множество картинок. У части из них стоит метка «кот» – это подмножество. Когда говорят «модель ошиблась на 15 картинках из 200», считают элементы подмножества «ошибки». Слова «множество», «подмножество», «пересечение» будут встречаться во всей книге.
В Python для множеств есть готовый тип set. Он сам выбрасывает повторы:
bukvy = set("КОЛОКОЛ")     # множество букв слова
print(bukvy)               # {'К', 'О', 'Л'} – порядок при печати может быть любым
print(len(bukvy))          # 3 – число элементов, наше n(A)
print("Л" in bukvy)        # True – буква «Л» есть в множестве
print("М" in bukvy)        # False – буквы «М» нет
Построчно: set("КОЛОКОЛ") разбирает слово на буквы и оставляет каждую по одному разу; len считает элементы; in проверяет, есть ли элемент в множестве, и отвечает True («да, истина») или False («нет, ложь»).
Запомни. Множество – набор без повторов, порядок в нём не важен. – сколько в нём элементов. Подмножество – часть, все элементы которой есть в большом множестве.
2.2. Пересечение и объединение: круги Эйлера
Тот, кто и в шапке, и в шарфе, должен стоять сразу в двух обручах. Поэтому обручи кладут внахлёст, а он встаёт в середину.
Представь зимнюю перемену. Учитель кладёт на пол два обруча и просит: «Кто в шапке – в левый, кто в шарфе – в правый». Тем, у кого есть и то, и другое, придётся встать туда, где обручи перекрываются. А кто без шапки и без шарфа, останется снаружи. Вот и весь смысл кругов Эйлера: каждое множество рисуют кругом, и сразу видно, кто где.
Рисовать множества кругами придумал Леонард Эйлер – великий математик, который много лет работал в Петербургской академии наук. Поэтому их так и называют: круги Эйлера. В книгах встречается и название «диаграммы Эйлера – Венна».
Круги рисуют внутри прямоугольника. Прямоугольник – это всё, о чём речь в задаче: весь класс, все книги библиотеки, все страницы интернета. Без него непонятно, что значит «снаружи». Те, кто без шапки и без шарфа, стоят в прямоугольнике, но вне обоих кругов.
Два круга режут прямоугольник на четыре кусочка: «только », «только », общая серединка и всё, что снаружи. Из этих кусочков, как из деталей конструктора, собирают четыре главных понятия. Некоторые занимают один кусочек, а некоторые – сразу несколько.
- Пересечение – элементы, которые есть и в , и в . Это один кусочек – общая серединка. Дети и в шапке, и в шарфе.
- Объединение – элементы, которые есть хотя бы в одном из множеств: в , или в , или в обоих сразу. Это три кусочка вместе: оба круга целиком. Все, кто стоит хоть в каком-то обруче.
- Разность «, но не » – один кусочек, левый «полумесяц»: в шапке, но без шарфа.
- Дополнение «не » – всё, что внутри прямоугольника, но снаружи круга . Это два кусочка: «только » и «вне обоих». Все, кто без шапки: и те, кто в одном шарфе, и те, у кого нет ни шапки, ни шарфа.
Как не перепутать значки? похож на букву «П» – Пересечение. похож на чашку, в которую сливают всё вместе, – объединение.
Пример на числах. , . Общие элементы – 2 и 4, значит, . Всё вместе, без повторов: – семь элементов. Только в : .
В Python пересечение пишут значком &, объединение – значком |, разность – минусом:
A = {1, 2, 3, 4, 6}
B = {2, 4, 5, 8}
print(A & B)          # {2, 4} – пересечение
print(A | B)          # {1, 2, 3, 4, 5, 6, 8} – объединение
print(A - B)          # {1, 3, 6} – есть в A, но нет в B
print(len(A | B))     # 7
Запомни. – «и то, и другое», – «хотя бы одно», «, но не » – круг без общей части, «не » – всё за пределами круга . Одно понятие может занимать и один кусочек картинки, и несколько.
Совет. Как только в задаче появились две группы, которые могут пересекаться, рисуй два круга внахлёст. Даже если кажется, что и так всё понятно. Рисунок занимает полминуты и спасает от самой частой ошибки – о ней следующий раздел.
2.3. Считаем элементы: формула включений и исключений
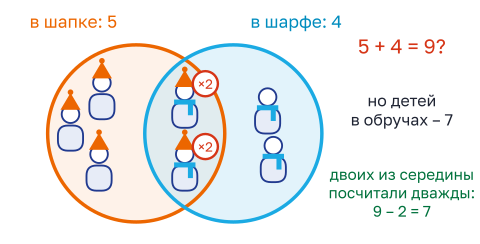
Двое из середины попали и в «шапки», и в «шарфы». Сложили – посчитали их дважды. Один лишний раз надо вычесть.
Главная ловушка задач на множества – двойной счёт. Если просто сложить, сколько детей в шапке и сколько в шарфе, тех, кто в середине, мы посчитаем два раза. Поэтому после сложения пересечение вычитают один раз:
Словами: хотя бы в одном = в первом + во втором – в обоих. Сначала всех «включили» (сложили), потом лишних «исключили» (вычли), отсюда и название – формула включений и исключений.
Пример. В 6 «А» 27 учеников. На плавание ходят 15 человек, на лыжи – 11, и туда, и туда – 6. Сколько человек ходят хотя бы в одну секцию и сколько – ни в одну?
- Хотя бы в одну: человек.
- Ни в одну: из всего класса вычитаем тех, кто хотя бы в одной: человек.
- Только на плавание: . Только на лыжи: . Проверка: – сходится.
Эту формулу можно «вертеть» как угодно: из четырёх чисел , , и по любым трём находится четвёртое. Чаще всего на отборе спрашивают пересечение:
Если про плавание знаем 15, про лыжи 11 и что хотя бы в одну секцию ходят 20 – в обе ходят .
Три множества. Это место многие перечитывают дважды, и это нормально. Три круга внахлёст режут картинку на семь кусочков внутри и один снаружи. Складывать и вычитать наугад тут легко запутаться, поэтому круги заполняют числами от центра наружу.
Опросили 30 учеников 6 «Б», у кого какие питомцы. Кошка есть у 12, собака у 10, рыбки у 6. Кошка и собака – у 4, кошка и рыбки – у 3, собака и рыбки – у 2, все три – у одного.
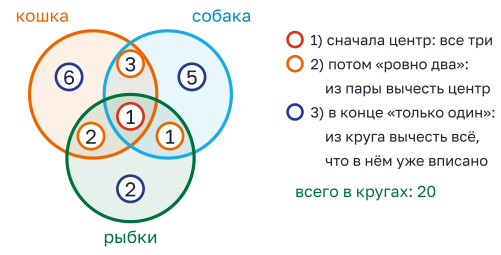
- Центр – все три питомца: 1.
- Ровно два питомца. Кошка и собака есть у 4, но один из них – в центре, у него ещё и рыбки. Значит, только кошка и собака, без рыбок: . Так же кошка и рыбки: , собака и рыбки: .
- Только один питомец. Из всего круга вычитаем то, что в нём уже вписано. Только кошка: . Только собака: . Только рыбки: .
- Сумма всех кусочков – сколько учеников хотя бы с одним питомцем: .
- Снаружи – без питомцев: учеников.
Когда все кусочки вписаны, можно ответить на любой вопрос. «Сколько учеников держат ровно одного питомца?» – . «Ровно двух?» – .
Проверка формулой. Для трёх кругов тоже есть формула включений и исключений, только длиннее:
Словами: сложи три круга, вычти три пары и прибавь центр. Для питомцев: – столько же, сколько при заполнении.
Откуда в конце плюс? Посмотри на единственного ученика в центре – у него все три питомца. Когда сложили три круга, его посчитали три раза. Потом вычли три пары, а он есть в каждой – вычли его тоже три раза. Вышло : ученик пропал из подсчёта совсем. Возвращаем его, прибавив один раз.
Запомни. Хотя бы в одном = . Ни в одном = все минус хотя бы в одном. Для трёх кругов заполняй кусочки от центра наружу, а в конце проверь сумму формулой.
Совет. Кусочек круга не может быть отрицательным. Если при заполнении вышло «только собака: –2», ты где-то вычел лишнее или перепутал числа в условии.
2.4. Логика: И, ИЛИ, НЕ
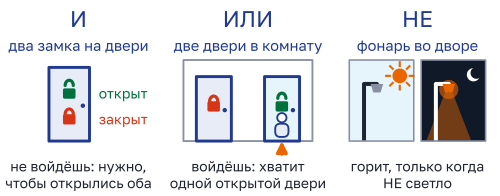
И – как два замка на одной двери: войдёшь, только если открыты оба. ИЛИ – как две двери в комнату: хватит одной открытой. НЕ – как фонарь во дворе: он делает всё наоборот и горит, когда НЕ светло.
Высказывание – фраза, про которую можно сказать «верно» или «неверно». «Новосибирск стоит на Оби» – верно. «В неделе 8 дней» – неверно. «Который час?» – не высказывание: это вопрос, он не бывает верным или неверным. В логике вместо «верно» говорят истина, вместо «неверно» – ложь. Коротко истину пишут 1, ложь – 0.
Из простых высказываний собирают сложные с помощью связок:
- И – истинно, только когда оба высказывания истинны. «Идёт снег И дует ветер» – верно, только если есть и снег, и ветер.
- ИЛИ – истинно, когда хотя бы одно истинно (или оба). «Возьму на дачу книгу ИЛИ планшет» – обещание выполнено, если взял книгу, планшет или и то, и другое. Ложно, только если не взял ничего.
- НЕ – переворачивает: истину делает ложью, ложь – истиной. «НЕ идёт снег» верно ровно тогда, когда снега нет.
Осторожно с ИЛИ. В обычной речи «чай или компот?» значит «что-то одно». В логике ИЛИ разрешает и оба сразу. В задачах всегда логическое ИЛИ, если не сказано иначе.
Таблица истинности – таблица, где перебраны все возможные сочетания «истина/ложь» и для каждого написан результат. У двух высказываний и сочетаний четыре: оба ложны, ложно только одно (два случая), оба истинны.
| И | ИЛИ | НЕ | ||
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
Столбец «И» – одна единица, только в последней строке. Столбец «ИЛИ» – один ноль, только в первой. Больше тут запоминать нечего.
Посмотри на круги Эйлера из раздела 2.2 – это та же логика. Элемент попадает в пересечение, если он в И в . В объединение – если он в ИЛИ в . В дополнение – если он НЕ в . Поэтому задачи про множества и задачи про логику решаются одними и теми же картинками.
Сложные выражения. Связки можно соединять: «(дома есть хлеб ИЛИ есть деньги) И магазин НЕ закрыт». Порядок такой же строгий, как у действий в арифметике: сначала то, что в скобках, потом НЕ, потом И и в конце ИЛИ.
Это как в арифметике, где умножение делают раньше сложения. Связка И и правда похожа на умножение: , и «ложь И истина» – тоже ложь. Сомневаешься в порядке – ставь скобки, лишними они не бывают.
Пример. , , . Чему равно ИЛИ И НЕ ? По порядку: НЕ = 1. Потом И: И 1 = 0 И 1 = 0. В конце ИЛИ: ИЛИ 0 = 1 ИЛИ 0 = 1. Ответ: 1, истина.
Если высказываний три, строк в таблице истинности будет : каждое из трёх может быть 0 или 1 (это правило умножения из главы 3). Для четырёх – 16 строк. Перебирать руками долго, а компьютер делает это мгновенно. В Python связки пишут по-английски: И – and, ИЛИ – or, НЕ – not:
# печатаем таблицу истинности для выражения A и не B
for A in [0, 1]:
    for B in [0, 1]:
        rez = A and not B
        print(A, B, int(rez))
Как это читать: for A in [0, 1]: – «по очереди подставь в сначала 0, потом 1». Второй for внутри первого перебирает для каждого – так получаются все четыре строки. rez = A and not B считает выражение, а int(rez) печатает результат цифрой 0 или 1. Программа выведет четыре строки: 0 0 0, 0 1 0, 1 0 1, 1 1 0. Истина только в одной строке: , .
Для любопытных. В учебниках информатики связки часто пишут значками: И – , ИЛИ – , НЕ – . Правила с ними те же. Науку о вычислениях с истиной и ложью в XIX веке придумал английский математик Джордж Буль, поэтому её называют булевой алгеброй. Внутри процессора твоего телефона – миллиарды крошечных переключателей, собранных в элементы И, ИЛИ, НЕ.
Запомни. И – истина, только если истинны оба. ИЛИ – ложь, только если ложны оба. НЕ – наоборот. Порядок: скобки, НЕ, И, ИЛИ. Для высказываний в таблице истинности строк: 4, 8, 16…
2.5. Запросы к поисковику
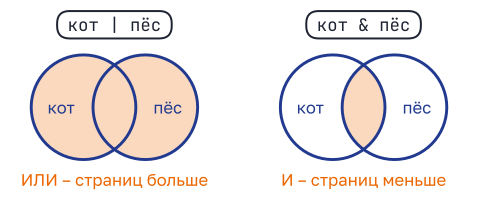
ИЛИ собирает оба круга – находится больше. И оставляет только общую часть – находится меньше.
Поисковик – это огромная машина для работы с множествами. На каждое слово у него есть множество страниц, где это слово встречается. Запрос из нескольких слов – это пересечение или объединение таких множеств. В задачах (и в школьных учебниках) обычно пишут так:
кот | пёс– ИЛИ: страницы, где есть хотя бы одно из слов, – объединение;кот & пёс– И: страницы, где есть оба слова, – пересечение.
В настоящих поисковиках значки могут быть другими, да и работают они сложнее. Но в задаче всегда сказано, что значит каждый значок, – решай по условию.
Нарисуй круги Эйлера – и сразу увидишь два правила:
- И сужает. Каждое новое слово через
&может только убрать страницы.кот & пёснайдёт не больше, чемкот, акот & пёс & попугай– не больше, чемкот & пёс. - ИЛИ расширяет. Каждое новое слово через
|может только добавить.кот | пёснайдёт не меньше, чемкот.
Поэтому запросы легко выстроить по числу найденных страниц: меньше всего – у запроса с самым длинным «И», больше всего – у запроса с самым длинным «ИЛИ». А если даны числа, работает формула из раздела 2.3. Нашлось «кот» – 800 страниц, «пёс» – 600, «кот | пёс» – 1100. Тогда «кот & пёс»: страниц.
Так же устроены фильтры в каталогах, интернет-магазинах и базах данных. В одной из задач отбора прошлых лет участникам давали книжный сервис: можно было выбрать сразу несколько жанров, и сервис показывал книги хотя бы одного из них – то есть объединение. А нужно было найти книги обоих жанров. Пересечения сервис не давал – его надо было досчитать самому по формуле. Такую задачу мы разберём ниже (задача 2.3).
Запомни. & – И – пересечение: найдётся меньше. | – ИЛИ – объединение: найдётся больше. Пересечение по трём числам: .
Совет. Прежде чем считать, прочитай, что делает фильтр или значок. Выбрал в каталоге два жанра – это «ИЛИ» или «И»? От ответа зависит, какую формулу брать.
2.6. Разбираем задачи
Задача 2.1 Кружки после уроков
В 6 «В» 28 учеников. На робототехнику ходят 16 человек, на программирование – 11, на оба кружка – 5. а) Сколько учеников ходят хотя бы в один кружок? б) Сколько не ходят ни в один?
Дано: всего 28; ; ; .
Найти: – ?; ни в один – ?
Шаг 1. Что происходит. Два множества: «ходят на робототехнику» и «ходят на программирование». Они пересекаются: 5 человек ходят туда и туда. Рисуем два круга внахлёст внутри прямоугольника «весь класс».
Шаг 2. Хотя бы в один. По формуле включений и исключений: ученика.
Шаг 3. Ни в один. Из всего класса вычитаем тех, кто хотя бы в одном: учеников.
Проверка. Только робототехника: , только программирование: , оба: 5, ни одного: 6. Всего – как раз весь класс.
И прикинь на глаз: тех, кто ходит хотя бы в один кружок, не может быть меньше, чем в самом большом кружке (16), и больше, чем во всём классе (28). 22 – между ними.
Самая частая ошибка. Сложить и ответить «27 ходят хотя бы в один, 1 не ходит никуда». Пятерых, кто ходит в оба кружка, посчитали два раза.
Ответ: а) 22 ученика; б) 6 учеников.
Своя задача по программе сферы, модуль 2
Реши сам
2.1. В классе 25 учеников. Математику любят 14, информатику – 12, а 4 ученика не любят ни то, ни другое. Сколько учеников любят оба предмета?
ответ2.2.* В классе 30 учеников. 20 ходят на плавание, 17 – на футбол. Какое наименьшее и какое наибольшее число учеников может ходить и туда, и туда? Запиши два числа через точку с запятой: сначала наименьшее.
ответЗадача 2.2 Буквы в словах
– множество букв слова «НЕЙРОСЕТЬ», – множество букв слова «РОБОТ». Найди , , и . В ответ запиши .
Дано: – буквы слова «НЕЙРОСЕТЬ»; – буквы слова «РОБОТ».
Найти: – ?
Шаг 1. Выписываем множества без повторов. В слове «НЕЙРОСЕТЬ» девять букв, но «Е» встречается дважды: , . В слове «РОБОТ» пять букв, «О» – дважды: , .
Шаг 2. Пересечение. Идём по буквам и ищем каждую в : Р – есть, О – есть, Б – нет, Т – есть. , .
Шаг 3. Объединение. По формуле: . Проверим перечислением – к буквам добавляем те буквы , которых там нет (только Б): – 9 букв.
Проверка кодом.
A = set("НЕЙРОСЕТЬ")
B = set("РОБОТ")
print(len(A), len(B), len(A & B), len(A | B))   # 8 4 3 9
Ловушка с повторами. Посчитать буквы вместе с повторами: , – и получить . В множестве каждая буква – один раз, сколько бы раз она ни встречалась в слове.
Ответ: , , , . В ответ – 9.
Своя задача по программе сферы, модуль 2
Реши сам
2.3. – множество букв слова «МАТЕМАТИКА», – множество букв слова «ИНФОРМАТИКА». Сколько элементов в ?
ответ2.4. – чётные числа от 1 до 20, – числа от 1 до 20, которые делятся на 3. Найди и .
ответЗадача 2.3 Каталог школьной библиотеки
У школьной библиотеки есть сайт-каталог. У каждой книги указан один или несколько жанров и одна возрастная отметка (6+, 10+, 12+ и так далее). В фильтре можно выбрать сразу несколько жанров – тогда сайт показывает книги, у которых есть хотя бы один из выбранных жанров. Катя попробовала разные фильтры и записала, сколько книг нашлось:
| Фильтр | Отметка 10+ | Любой возраст |
|---|---|---|
| фантастика | 9 | 24 |
| приключения | 7 | 15 |
| оба жанра | 14 | 33 |
В строке «оба жанра» в фильтре выбраны сразу фантастика и приключения.
Сколько в библиотеке книг, у которых есть оба жанра – и фантастика, и приключения, – а возрастная отметка не 10+?
Дано: отметка 10+: , , ; все книги: , , .
Найти: книги с обоими жанрами и отметкой не 10+ – ?
Шаг 1. Что происходит. Когда выбраны оба жанра, сайт показывает книги хотя бы одного жанра – это объединение . А нам нужны книги обоих жанров – пересечение . Сайт его не показывает, досчитаем сами. Сделаем это два раза: для отметки 10+ и для всех книг.
Шаг 2. Оба жанра с отметкой 10+. книги.
Шаг 3. Оба жанра, все возрасты. книг.
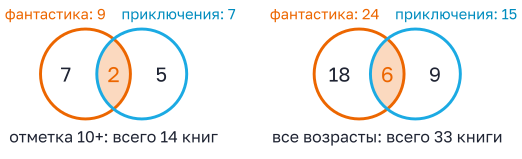
Шаг 4. Оба жанра, но не 10+. У каждой книги ровно одна возрастная отметка. Значит, 6 книг обоих жанров делятся на две группы: 2 с отметкой 10+ и все остальные. Остальных: книги.
На чём ловит эта задача. Кажется, что фильтр с двумя жанрами показывает книги обоих жанров, – и тянет сразу ответить . Но 33 и 14 – объединения, «хотя бы один жанр». Читай в условии, что делает фильтр: здесь выбор двух жанров – это ИЛИ, а не И.
Ответ: 4 книги.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Круги Эйлера»
Реши сам
2.5. В детском онлайн-кинотеатре фильтр жанров работает как в задаче 2.3: выбрал несколько жанров – показывает мультфильмы хотя бы одного из них. У каждого мультфильма одна возрастная отметка. С отметкой 6+: «комедия» – 12, «сказка» – 9, «комедия» и «сказка» (выбраны оба) – 17. Без фильтра возраста: «комедия» – 30, «сказка» – 22, оба жанра в фильтре – 45. Сколько мультфильмов одновременно и комедия, и сказка, но с отметкой не 6+?
ответ2.6.* Хотя бы в одном из множеств и – 30 элементов. В – 20 элементов, в – 18. Сколько элементов есть только в ?
ответЗадача 2.4 Реки Сибири в поисковике
В языке запросов поисковика значок | означает ИЛИ, значок & – И. Вот сколько страниц нашлось по трём запросам:
Байкал | Обь– 780 тыс. страниц;Байкал– 500 тыс. страниц;Обь– 420 тыс. страниц.
а) Сколько тысяч страниц найдётся по запросу Байкал & Обь? б) Расположи запросы в порядке возрастания числа найденных страниц: А) Обь & Байкал & Енисей; Б) Обь | Байкал; В) Обь; Г) Обь & Байкал. Ответ запиши буквами.
Дано: ; ; (тыс. страниц).
Найти: – ?; порядок запросов А–Г.
Шаг 1. Что происходит. Каждое слово – множество страниц. | – объединение, & – пересечение. Три числа из формулы включений и исключений известны, четвёртое найдём.
Шаг 2. Пересечение. тыс. страниц.
Шаг 3. Порядок. Для Б число есть: Обь | Байкал – то же, что Байкал | Обь, 780 тыс. Для В оно тоже дано (420 тыс.), для Г мы его только что нашли (140 тыс.). А для А числа нет – и не нужно: хватит понять, кто в ком помещается.
- Г)
Обь & Байкал– страницы, где есть оба слова. Каждая такая страница есть и среди страниц со словом «Обь», поэтому Г не больше В. - А)
Обь & Байкал & Енисей– из страниц Г остаются только те, где есть ещё и «Енисей». А не больше Г. - Б)
Обь | Байкал– все страницы со словом «Обь» плюс ещё страницы про Байкал. Б не меньше В.
Выходит цепочка: А внутри Г, Г внутри В, В внутри Б. По возрастанию: А, Г, В, Б.
Сверим с числами. Пересечение не может быть больше ни одного из множеств – и правда, 140 меньше и 500, и 420. А известные числа идут в том же порядке, что и в ответе: (Г, В, Б).
Частая путаница. Многие думают, что чем длиннее запрос, тем больше он найдёт: «в А три слова – значит, страниц больше всего». Для & всё наоборот: каждое новое слово – ещё одно условие, и страниц становится меньше или столько же.
Ответ: а) 140 тыс. страниц; б) АГВБ.
Своя задача по программе сферы, модуль 2
Реши сам
2.7. По запросу Обское море | Академгородок нашлось 5200 страниц, по запросу Обское море & Академгородок – 900, по запросу Академгородок – 3400. Сколько страниц найдётся по запросу Обское море?
2.8. Расположи запросы в порядке возрастания числа найденных страниц: А) дрон; Б) дрон & Луна; В) дрон | Луна | ракета; Г) дрон | Луна. Ответ запиши буквами.
Задача 2.5 Умный почтовый фильтр
Почтовая программа кладёт письмо во «Входящие» по правилу:
(отправитель есть в контактах ИЛИ в теме есть слово «кружок») И НЕ (в письме есть ссылка на незнакомый сайт).
Остальные письма уходят в «Спам». Пришло шесть писем:
| № | Отправитель | Тема | Ссылка на незнакомый сайт |
|---|---|---|---|
| 1 | одноклассник (в контактах) | «Что задали по математике?» | нет |
| 2 | незнакомый адрес | «Кружок робототехники переносится» | нет |
| 3 | незнакомый адрес | «Вы выиграли телефон!» | есть |
| 4 | мама (в контактах) | «Фото с дачи» | есть |
| 5 | незнакомый адрес | «Запись в кружок – по ссылке» | есть |
| 6 | учитель (в контактах) | «Кружок завтра в 15:00» | нет |
Какие письма попадут во «Входящие»? Запиши номера по возрастанию, без пробелов.
Дано: – «отправитель в контактах»; – «в теме есть слово «кружок»»; – «есть ссылка на незнакомый сайт». Правило: ( ИЛИ ) И НЕ .
Найти: номера писем, для которых правило истинно.
Шаг 1. Переводим письма в нули и единицы. Слово «кружок» в любой форме («кружок», «кружка», «Кружок») считаем. Для каждого письма выписываем , , .
Шаг 2. Считаем по порядку: сначала скобки, потом НЕ, потом И.
| № | , , | ИЛИ | НЕ | итог |
|---|---|---|---|---|
| 1 | 1, 0, 0 | 1 | 1 | 1 |
| 2 | 0, 1, 0 | 1 | 1 | 1 |
| 3 | 0, 0, 1 | 0 | 0 | 0 |
| 4 | 1, 0, 1 | 1 | 0 | 0 |
| 5 | 0, 1, 1 | 1 | 0 | 0 |
| 6 | 1, 1, 0 | 1 | 1 | 1 |
Шаг 3. Читаем столбец «итог». Единицы – у писем 1, 2 и 6.
А как же мама? Письмо от мамы со ссылкой на незнакомый сайт ушло в «Спам». Обидно, но правило честное: ссылки на незнакомые сайты фильтр не пропускает ни от кого. Если мамину почту взломают, мошенники будут рассылать такие ссылки как раз от её имени.
Осторожно со скобками. Если их потерять и прочитать правило как « ИЛИ ( И НЕ )», письмо 4 от мамы пройдёт, ведь , а ИЛИ с единицей всегда даёт 1, – и получится 1246. Скобки меняют ответ, поэтому считай сначала то, что в них.
Ответ: 126.
Своя задача по программе сферы, модуль 2
Реши сам
2.9. В лабораторию пускают по правилу: (есть пропуск И пройден инструктаж) ИЛИ рядом наставник. Пришли пятеро: 1) пропуск есть, инструктаж пройден, наставника нет; 2) пропуск есть, инструктажа нет, наставника нет; 3) пропуска нет, инструктажа нет, наставник рядом; 4) пропуска нет, инструктаж пройден, наставник рядом; 5) всё есть. Кого пустят? Запиши номера по возрастанию, без пробелов.
ответ2.10. , . Чему равно (НЕ ) ИЛИ ? Ответ – 0 или 1.
ответЗадача 2.6* Разметка фотографий для нейросети
Чтобы научить нейросеть находить на фото кошек, собак и людей, ребята из кружка разметили 200 фотографий: поставили метки «кошка», «собака», «человек». На одном фото может быть несколько меток, а может не быть ни одной (например, пейзаж). Итог разметки:
- метка «кошка» – на 70 фото, «собака» – на 60, «человек» – на 90;
- «кошка» и «собака» вместе – на 20 фото, «кошка» и «человек» – на 30, «собака» и «человек» – на 25 (на части этих фото может стоять и третья метка);
- все три метки – на 10 фото.
а) Сколько фото остались без единой метки? б) Сколько фото получили ровно одну метку?
Дано: всего 200; ; ; ; ; ; ; .
Найти: без меток – ?; ровно одна метка – ?
Шаг 1. Что происходит. Три множества, которые пересекаются. Рисуем три круга и заполняем кусочки от центра наружу – так ответим на оба вопроса сразу.
Шаг 2. Центр – все три метки: 10.
Шаг 3. Ровно две метки. Из каждой пары вычитаем центр: только кошка и собака ; только кошка и человек ; только собака и человек .
Шаг 4. Ровно одна метка. Из каждого круга вычитаем всё, что в нём уже вписано:
- только кошка: ;
- только собака: ;
- только человек: .
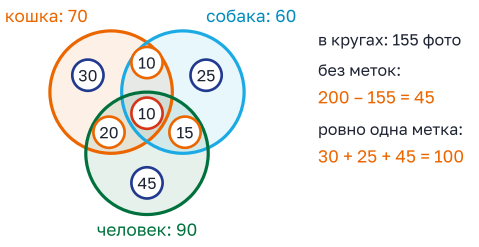
Шаг 5. Хотя бы одна метка – сумма всех семи кусочков: фото. Проверим формулой: – то же число.
Шаг 6. Ответы. а) Без меток: фото. б) Ровно одна метка: фото.
Все ли фото на месте? 100 фото с одной меткой, – с двумя, 10 – с тремя, 45 – без меток. – ни одно не потерялось. И ни один кусочек не вышел отрицательным.
Типичная ошибка. Забыть в конце прибавить центр: , и тогда без меток «55». А в пункте б) рука тянется сразу написать «фото с одной меткой»: так каждое фото с двумя метками посчитано дважды, а с тремя – трижды. Да и 220 больше, чем всех фото, – верный знак, что что-то не так.
Ответ: а) 45 фото; б) 100 фото.
Своя задача по программе сферы, модуль 2
Реши сам
2.11. В детском технопарке 40 школьников. На робототехнику записаны 20, на программирование – 18, на 3D-моделирование – 15. Робототехника и программирование – у 7, робототехника и 3D – у 6, программирование и 3D – у 5, все три кружка – у 3. Сколько школьников не записаны ни в один из этих кружков?
ответ2.12.* Для нейросети, которая узнаёт звуки, разметили 120 записей: метка «речь» – на 60, «музыка» – на 45, «шум» – на 40. «Речь» и «музыка» вместе – на 15 записях, «речь» и «шум» – на 12, «музыка» и «шум» – на 10, все три метки – на 5. Сколько записей получили ровно две метки?
ответЗадача 2.7* Умная лампа
Умная лампа в прихожей включается по правилу: ( И ) ИЛИ НЕ , где – «на улице темно», – «в прихожей кто-то есть», – «включён режим «Экономия»». Каждое из трёх высказываний может быть истинным или ложным. При скольких сочетаниях , , из всех возможных лампа будет гореть?
Дано: правило ( И ) ИЛИ НЕ ; , , – каждое 0 или 1.
Найти: число сочетаний, при которых правило истинно.
Шаг 1. Сколько всего сочетаний. У каждого из трёх высказываний два значения: сочетаний. Их удобно перебирать как числа от 000 до 111: меняется чаще всех, – реже.
Шаг 2. Таблица. Сначала скобка И , потом НЕ , в конце ИЛИ.
| И | НЕ | итог | |||
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 1 | 1 |
| 0 | 0 | 1 | 0 | 0 | 0 |
| 0 | 1 | 0 | 0 | 1 | 1 |
| 0 | 1 | 1 | 0 | 0 | 0 |
| 1 | 0 | 0 | 0 | 1 | 1 |
| 1 | 0 | 1 | 0 | 0 | 0 |
| 1 | 1 | 0 | 1 | 1 | 1 |
| 1 | 1 | 1 | 1 | 0 | 1 |
Шаг 3. Считаем единицы в итоге: 5.
Короткий путь без таблицы. ИЛИ истинно, если истинна хотя бы одна часть. НЕ истинно, когда , – это 4 сочетания из 8 ( и любые, ). Остались 4 сочетания с . Там лампу может включить только И , а это одно сочетание: , . Всего .
Проверка кодом.
schet = 0
for A in [0, 1]:
    for B in [0, 1]:
        for C in [0, 1]:
            if (A and B) or not C:
                schet = schet + 1
print(schet)   # 5
Три вложенных for перебирают все 8 сочетаний. Если правило истинно, счётчик schet увеличивается на 1.
Как это выглядит в прихожей. В режиме «Экономия» лампа горит только в одном случае – темно и кто-то пришёл. Без экономии – всегда.
Так теряют баллы. Читают правило в другом порядке: И ( ИЛИ НЕ ). Тогда при лампа не горит никогда, и выходит 3 вместо 5. Или перебирают не все сочетания: выписывают «на глаз» 4–5 строк и теряют часть. Пиши строки строго по порядку, от 000 до 111.
Ответ: 5.
Своя задача по программе сферы, модуль 2
Реши сам
2.13.* При скольких сочетаниях , , (каждое – 0 или 1) истинно выражение ( ИЛИ ) И (НЕ ИЛИ )?
ответ2.14. Сколько целых чисел от 1 до 10 делают истинным высказывание: И НЕ ( чётное)?
ответКомбинаторика и вероятность
Сколько разных разговоров может получиться у чат-бота, если на каждом шаге человек выбирает одну из нескольких кнопок? Какова вероятность выбросить на двух кубиках 7? И что имеет в виду программа, когда пишет «кошка – 80 %»? Все три вопроса решаются одним приёмом: аккуратно пересчитать варианты и не потерять ни одного. На отборе прошлых лет была как раз такая задача – «дерево возможностей» чат-бота, ответ вводился одним числом. Арифметика здесь на уровне таблицы умножения. Баллы теряют на другом: пропускают ветку или считают одну и ту же дважды.
3.1. Дерево возможностей и правило умножения
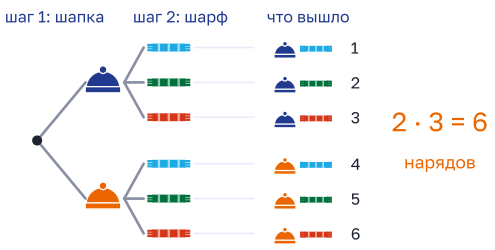
Каждая шапка ветвится на три шарфа. Веток две, в каждой по три – всего 2 · 3 = 6 нарядов.
Утром в прихожей висят две шапки – синяя и оранжевая – и три шарфа. Сколько разных нарядов можно собрать? Перебирать наугад рискованно: что-нибудь пропустишь или посчитаешь дважды. Надёжнее нарисовать дерево возможностей – схему, где каждый выбор разветвляется на все свои варианты. Из начальной точки выходят ветки «синяя шапка» и «оранжевая шапка», из каждой – по три ветки-шарфа. Концы веток называют листьями. Каждый лист – один готовый вариант. Листьев шесть, значит, и нарядов шесть.
Чат-боты устроены так же. Бот «Что почитать?» сначала спрашивает жанр: фантастика, детектив или приключения. Потом уточняет, какую книгу хочется – короткую или длинную. Каждый путь от начала до листа – один сценарий разговора.
Рисовать дерево каждый раз не обязательно – достаточно посмотреть на его форму. Из начала выходят 3 ветки, и каждая делится ещё на 2. Получается 3 раза по 2, то есть . Это правило умножения: если выбор идёт по шагам, на первом шаге вариантов, а на втором – вариантов при любом первом выборе, то всего вариантов . Шагов больше – множителей больше. Добавим боту третий вопрос «бумажная или электронная?» – каждый из шести листьев раздвоится, и получится сценариев.
Умножать можно, только если на втором шаге всегда одно и то же число вариантов, что бы ни выбрали на первом. Если после «фантастики» бот предлагает два объёма, а после «детектива» – один, правило ломается. Тогда листья считают по веткам и складывают. Об этом – следующий раздел.
Пересчитать листья может и программа. Два цикла for, один внутри другого, – это и есть дерево: внешний цикл идёт по веткам первого шага, внутренний – по веткам второго.
zhanry = ["фантастика", "детектив", "приключения"]
obyomy = ["короткая", "длинная"]

n = 0
for zh in zhanry:          # первый шаг дерева: жанр
    for ob in obyomy:      # второй шаг: для каждого жанра – оба объёма
        n += 1
        print(n, zh, ob)
print("всего:", n)         # всего: 6
Цикл for zh in zhanry по очереди берёт каждый жанр из списка. Для каждого жанра вложенный цикл перебирает оба объёма. Строка n += 1 прибавляет к счётчику единицу на каждом листе, а print выводит номер листа и сам сценарий.
Запомни. Выбор по шагам – перемножаем, сколько вариантов на каждом шаге: . Так можно, только если число вариантов на шаге не зависит от того, что выбрали раньше.
Совет. Сомневаешься – нарисуй начало дерева: первую ветку целиком, остальные – одной чертой с подписью «так же». Ошибку «сложил вместо того, чтобы умножить» такой набросок ловит сразу.
3.2. Правило сложения: «или» против «и»
Кашу и напиток берут вместе – каждая каша с каждым напитком, 2 · 3 = 6 пар. Книгу или фильм выбирают одно – все варианты встают в одну очередь, 5 + 3 = 8.
Прислушивайся к союзам в условии. На завтрак берут кашу и напиток – обе вещи сразу, и каждая каша сочетается с каждым напитком. Это правило умножения. А вечером читают книгу или смотрят фильм – что-то одно. Тогда варианты просто выстраиваются в один ряд: 5 книг да 3 фильма – способов провести вечер. Это правило сложения: если выбираем один вариант из нескольких групп, которые не пересекаются, числа вариантов складываем.
Часто в одной задаче есть и то, и другое. Бот кинотеатра спрашивает: «Мультфильм или кино?» Мультфильмов в афише 4, фильмов 2. Потом предлагает к сеансу напиток – один из трёх. Первый шаг – «или»: сеансов. Второй шаг – «и»: к любому сеансу подходит любой напиток. Итого . Скобки тут обязательны: сначала собираем все варианты одного шага, потом перемножаем шаги.
Ловушка – группы с общими элементами. На полке 5 книг про космос и 4 фантастических, но одна из них – фантастика про космос. Сколько есть книг «про космос или фантастика»? Не 9, а : общую книгу посчитали в обеих группах, и одну лишнюю надо вычесть. Это те же круги Эйлера из главы 2.
Запомни. «И» – берём по варианту на каждом шаге – умножаем. «Или» – берём одно из нескольких групп – складываем. Если у групп есть общие элементы, общее вычитаем один раз.
3.3. Перестановки: кто за кем
На первое место – любой из трёх, на второе – любой из двух оставшихся, на третье – последний. 3 · 2 · 1 = 6 очередей.
Три робота – А, Б и В – встают в очередь на зарядку. Сколькими способами это можно сделать? Выпишем все очереди: АБВ, АВБ, БАВ, БВА, ВАБ, ВБА – шесть. Выписывай по порядку, иначе запутаешься: сначала все очереди, где первым стоит А, потом где первым Б, потом В.
А можно посчитать по местам – тем же правилом умножения. На первое место встаёт любой из 3 роботов. Когда первый встал, на второе место остаются 2. На третье – 1, последний. Всего . Отличие от шапок и шарфов в том, что здесь каждый следующий шаг беднее предыдущего: робот, который уже стоит в очереди, второй раз в неё не встанет.
Такие расстановки всех предметов в ряд называют перестановками. Для четырёх роботов: . Для пяти: . Число растёт очень быстро. Десять школьников можно выстроить в очередь в столовой 3 628 800 способами. Если пробовать каждую минуту новый порядок без сна и выходных, уйдёт почти семь лет.
Произведение встречается так часто, что у него есть имя – факториал – и значок (читается «эн факториал»): , , , . Это просто короткая запись. Считать всё равно удобнее по местам.
Не все места. Из 10 команд надо выбрать призёров: золото, серебро и бронзу. Считаем по местам, но останавливаемся на третьем: . Порядок здесь важен: «Альфа – золото, Бета – серебро» и «Бета – золото, Альфа – серебро» – разные итоги турнира.
Когда порядок не важен. Пятеро друзей при встрече пожали руки – каждый каждому. Каждый жмёт руку четверым, и кажется, что рукопожатий . Но рукопожатие Ани с Борей и Бори с Аней – одно и то же, а мы посчитали его дважды. Делим на 2: . Так же считают партии в турнире «каждый с каждым» и пары дежурных.
Перестановки умеет перебирать и Python. В модуле itertools – наборе готовых инструментов, который есть в любом Python, – есть функция permutations («перестановки»). Она выдаёт все расстановки сразу.
from itertools import permutations

ocheredi = list(permutations(["А", "Б", "В"]))
for o in ocheredi:
    print(*o)
print("всего:", len(ocheredi))           # всего: 6
print(len(list(permutations("АБВГД"))))  # 120 – очередей из пяти
len считает, сколько элементов в списке, а print(*o) печатает буквы одной очереди через пробел.
Запомни. Расставляем по местам: на каждое следующее место вариантов на один меньше. Все предметов в ряд – . Пары, где порядок не важен, – .
Совет. Перед подсчётом спроси себя: «Если поменять двоих местами – это новый вариант?» Да – порядок важен (очередь, призовые места, код замка). Нет – дели на 2 (рукопожатия, пара дежурных).
3.4. Вероятность – доля подходящих исходов
Шариков 10, оранжевых среди них 3. Вероятность вытащить оранжевый – 3 из 10, то есть 30 %.
В мешке 10 одинаковых на ощупь шариков: 3 оранжевых и 7 голубых. Тянешь один не глядя. Может попасться любой из десяти, и ни у одного нет преимущества. Оранжевых – три из десяти. Поэтому говорят: вероятность вытащить оранжевый шарик равна .
Несколько слов, без которых дальше не обойтись:
- опыт (эксперимент) – то, что мы делаем: бросаем монету, тянем шарик, включаем песню наугад;
- исход – чем опыт может закончиться: выпал орёл, попался шарик номер 7;
- равновозможные исходы – такие, что ни один не выпадает чаще других: монета ровная, кубик не кривой, шарики одинаковые на ощупь;
- подходящие (благоприятные) исходы – те, при которых случается нужное нам событие.
Вероятность – это доля подходящих исходов среди всех. Словами: вероятность равна числу подходящих исходов, делённому на число всех исходов. Буквами:
где – вероятность, – сколько исходов подходит, – сколько всего равновозможных исходов. Дробь переводим в проценты умножением на 100: %.
- Монета. Исходов 2, орёл – один из них: %.
- Кубик. Исходов 6. Чётное число (2, 4 или 6) – 3 исхода: %. Шестёрка – один исход: %.
- Выбор из списка. Кого вызвать к доске, выбирает программа-жребий, и у всех 24 учеников класса шансы равные. Вероятность, что выпадет именно тебе, – %.
У вероятности две границы. Меньше 0 она не бывает: 0 – у события, которое никогда не случится (на кубике выпало 7). Больше 1 тоже не бывает: 1 – у события, которое случится всегда (на кубике выпало меньше 10). Вышло 1,3 или 130 % – ищи ошибку в решении.
Противоположное событие. «Вытащу оранжевый» и «не вытащу оранжевый» вместе покрывают все исходы. Поэтому . Не оранжевый: , то есть 70 %. Иногда так считать заметно быстрее.
Две монеты. Сколько исходов, если бросить две монеты? Хочется сказать «три: два орла, две решки, орёл с решкой». Это главная ловушка темы, в неё попадали даже взрослые учёные. Покрась монеты мысленно: одна синяя, другая красная. Тогда исходы такие: ОО, ОР, РО, РР – четыре, и все равновозможные (дерево: ). «Орёл с решкой» получается двумя способами – ОР и РО. Поэтому вероятность ровно одного орла – %, а не .
Вероятность двух орлов – . Её можно найти и по-другому. В половине бросков синяя монета – орёл, и среди этих бросков в половине красная тоже орёл. Половина от половины: %. Это правило пригодится ещё не раз: вероятности двух независимых событий (одно никак не влияет на другое) перемножаются.
Два кубика. Исходов . Их удобно разложить в таблицу: строки – первый кубик, столбцы – второй, в клетке – сумма очков.
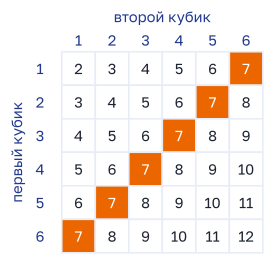
Сумма 7 стоит в 6 клетках: %. А сумма 2 – только в одной (1 и 1): %. Суммы от 2 до 12 не равновозможные, поэтому рассуждать «сумм всего 11, значит, каждая – одна одиннадцатая» нельзя.
Программа проверит подсчёт перебором всех 36 клеток:
vse = 0
podhodyat = 0
for a in range(1, 7):          # первый кубик: 1, 2, …, 6
    for b in range(1, 7):      # второй кубик
        vse += 1
        if a + b == 7:
            podhodyat += 1
print(podhodyat, "из", vse)                  # 6 из 36
print(round(podhodyat / vse * 100, 1), "%")  # 16.7 %
range(1, 7) – это числа от 1 до 6: правая граница в range не входит. round(…, 1) округляет до десятых.
Запомни. , и все исходы должны быть равновозможными. . «Не случится» – . У двух монет 4 исхода, у двух кубиков – 36: каждую монету и каждый кубик считай отдельно.
Совет. Подходящие исходы выписывай в столбик парами (первый кубик, второй кубик): (1, 6), (2, 5), (3, 4)… Такой список легко проверить глазами, а в уме пары теряются. Если подходящих слишком много, пересчитай неподходящие – их бывает меньше.
3.5. Частота в эксперименте
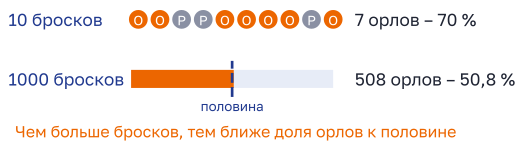
За 10 бросков орёл вполне может выпасть 7 раз. За 1000 бросков доля орлов подбирается к половине.
Вероятность орла – 50 %. Значит ли это, что из 10 бросков ровно 5 будут орлами? Попробуй – скорее всего, нет. Мы попросили компьютер бросить монету 10 раз и получили 7 орлов. Монета тут ни при чём: на коротком отрезке случай «гуляет».
Частота события – доля опытов, в которых оно случилось. Считают её так:
7 орлов из 10 – частота %. Бросаем дальше. После 100 бросков набралось 54 орла – 54 %. После 1000 – 508 орлов, 50,8 %.
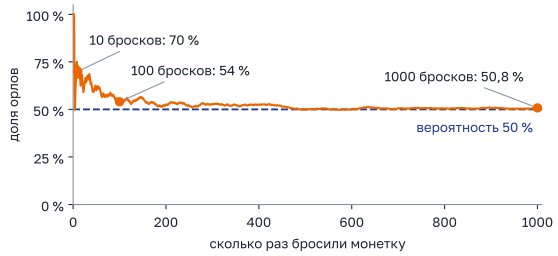
Это одно из главных наблюдений теории вероятностей, его называют законом больших чисел: чем больше опытов, тем ближе частота к вероятности. Ближе, но не обязательно ровно: 508 орлов из 1000 – самое обычное дело.
Сколько раз ожидать. Если вероятность известна, то в опытах событие случится примерно раз. Кубик бросили 600 раз – шестёрка выпадет около раз. Может, 93, может, 108, но не 20 и не 300.
Вероятность по опыту. Бывает, что исходы не пересчитать. Вероятность того, что школьный автобус опоздает, по дереву не найдёшь. Зато можно вести записи: за 80 учебных дней автобус опоздал 12 раз. Частота , и вероятность опоздания завтра оценим в 15 %. Так же учится машинное обучение: модель смотрит на тысячи примеров и запоминает, как часто что встречается. Чем больше примеров, тем точнее оценка – тот же закон больших чисел.
Бросать монету тысячу раз руками долго, а компьютер справится за долю секунды. Модуль random (он тоже есть в любом Python) выдаёт случайные числа: random.randint(0, 1) – случайно 0 или 1, как монета.
import random

orly = 0
for n in range(1, 1001):
    if random.randint(0, 1) == 1:    # 1 – орёл, 0 – решка
        orly += 1
    if n in (10, 100, 1000):
        print(n, "бросков:", round(orly / n * 100, 1), "% орлов")
Запусти программу несколько раз. Числа каждый раз будут другими – на то он и случай. Но после 1000 бросков доля орлов почти всегда окажется где-то между 45 и 55 %.
Запомни. Вероятность – сколько должно выходить в среднем, частота – сколько вышло в нашем опыте. На малом числе опытов они могут сильно различаться, на большом – сближаются. Ожидаемое число случаев = .
Совет. «Вероятность 50 %» – не обещание «через раз». У монеты нет памяти: после трёх решек подряд вероятность орла на четвёртом броске всё те же 50 %.
3.6. Вероятность в ИИ: «модель уверена на 80 %»
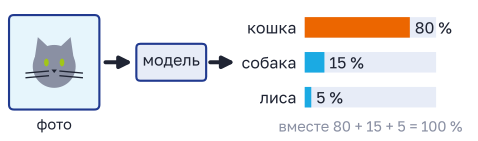
Модель не говорит просто «кошка». Она выдаёт вероятность каждому классу, который знает, и вместе выходит 100 %.
В главе 1 модель отвечала одним словом: «спам» или «не спам». На самом деле модель-классификатор обычно сначала выдаёт вероятности для каждого класса: кошка – 0,80, собака – 0,15, лиса – 0,05. Все 100 % она делит между классами, которые знает. Ответом называет класс с наибольшей вероятностью, а это число – 80 % – называют уверенностью модели. В Teachable Machine (её проходят в модуле 9 программы) такие проценты видны при проверке модели: у каждого класса своя полоска.
Что значит «уверена на 80 %»? Не то, что на фото «на 80 % кошка»: кошка там либо есть, либо нет. Смысл другой, и тут выручает частота. Если модель хорошо обучена, то среди всех фото, про которые она сказала «кошка, 80 %», кошки окажутся примерно на 80 из каждых 100. На остальных двадцати она ошибётся. Уверенность – обещание про частоту верных ответов на многих примерах, а не гарантия для одного снимка.
Модель может и переоценивать себя: говорит «90 %», а права лишь в 70 случаях из 100. Проверяют это как в разделе 3.5: берут много ответов с одинаковой уверенностью и считают частоту верных. Такая модель похожа на одноклассника, который на каждый вопрос уверенно тянет руку, а отвечает верно через раз.
Порог уверенности. Часто модели разрешают отвечать, только если уверенность выше порога, а иначе зовут человека. Камера на въезде во двор распознала номер машины с уверенностью 55 % – шлагбаум не поднимается, фото уходит охраннику. Вот такое правило на Python:
otvet = {"кошка": 0.80, "собака": 0.15, "лиса": 0.05}

klass = max(otvet, key=otvet.get)    # класс с самой большой вероятностью
if otvet[klass] >= 0.7:
    print("На фото", klass, "– уверенность", otvet[klass] * 100, "%")
else:
    print("Не уверена – пусть посмотрит человек")
otvet – это словарь: набор пар «ключ: значение», здесь «класс: вероятность». max(otvet, key=otvet.get) находит ключ с самым большим значением. Программа напечатает На фото кошка – уверенность 80.0 %. Поменяй 0.80 на 0.55 (а 0.15 на 0.40) – и ответом станет просьба позвать человека.
Вероятность в генеративном ИИ. Чат-боты вроде GigaChat или Алисы пишут ответ по кусочку – обычно это слово или часть слова. На каждом шаге языковая модель (программа, обученная на огромном количестве текстов) оценивает, что может идти дальше, и раздаёт вероятности. После «На Обском море дует сильный …» слову «ветер» достаётся много, слову «кактус» – почти ничего. Потом модель выбирает кусочек – чаще один из самых вероятных, но не всегда самый-самый. Поэтому на один и тот же вопрос чат-бот может ответить немного по-разному.
Вероятность целой фразы считают по дереву, как у двух монет, – доля от доли. Пусть модель начинает ответ со слова «привет» в 60 % случаев, а после «привет» дописывает «друг» в половине случаев. Тогда фраза «привет, друг» выходит в , то есть в 30 % случаев. Проще всего это увидеть на сотне ответов.
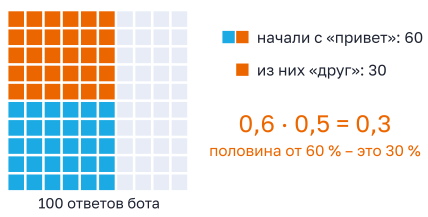
Запутался – вернись к сотне клеток: сначала отбери нужные по первому слову, потом среди отобранных – по второму.
Запомни. Проценты модели – её оценка, а не факт про один снимок. Честность модели проверяют на многих ответах: из тех, где она «уверена на 80 %», верными должны оказаться около 80 из 100. Вероятность фразы из нескольких слов – произведение вероятностей вдоль её ветки дерева.
3.7. Разбираем задачи
Задача 3.1 Сценарии бота-звездочёта
Для планетария делают чат-бота «Звездочёт». Сначала он предлагает тему: Луна, Марс, Солнце, кометы или МКС. Потом спрашивает, как рассказывать: текстом, картинками или голосом. В конце загадывает по теме загадку – лёгкую или трудную, на выбор посетителя. Сценарий разговора – вся цепочка выборов. Сколько разных сценариев может быть у «Звездочёта»? В ответ введи целое число.
Дано: тем – 5; способов рассказа – 3; уровней загадки – 2.
Найти: – число сценариев.
Шаг 1. Что происходит. Разговор идёт в три шага, на каждом посетитель выбирает один вариант. Сценарий = тема + способ рассказа + уровень загадки. Это выбор «и»: по варианту на каждом шаге.
Шаг 2. Можно ли умножать. Число способов рассказа не зависит от темы: и про Луну, и про кометы бот рассказывает тремя способами. Уровней загадки после любой темы – два. Значит, правило умножения работает.
Шаг 3. Считаем. В дереве из начала выходят 5 веток-тем, каждая делится на 3 ветки-способа: пар «тема + способ». Каждая пара делится ещё на 2 уровня загадки: .
Проверим с другого конца. Выпишем начало: «Луна – текст – лёгкая», «Луна – текст – трудная», «Луна – картинки – лёгкая»… На одну только Луну приходится сценариев, а тем пять: . Сходится.
Типичная ошибка. Сложить: . Это число всех кнопок, которые бот может показать, а не число разговоров. Складывают, когда выбирают что-то одно из всех вариантов, а здесь выбирают на каждом шаге.
Ответ: 30.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Дерево возможностей»
Реши сам
3.1. У велосипедного замка три колёсика, на каждом – цифры от 0 до 9. Сколько разных кодов можно набрать на таком замке?
ответ3.2. Бот-экскурсовод краеведческого музея предлагает выбрать зал (их 4), язык рассказа (русский или английский) и длительность экскурсии: 15, 30 или 45 минут. Сколько разных сценариев экскурсии может получиться?
ответЗадача 3.2 Бот с развилкой
Чат-бот школьной библиотеки сначала спрашивает: «Подобрать книгу или фильм?» Для книги он уточняет, как подбирать: по автору, по жанру или по эпохе. Для фильма – по жанру или по году выхода. После рекомендации посетитель выбирает одно: мини-викторину по ней в одном из четырёх видов (текст, картинка, аудио или видео) или «спасибо, не надо» – тогда бот прощается. Сколько разных сценариев разговора у бота? В ответ введи целое число.
Дано: книга – 3 способа подбора; фильм – 2 способа; викторина – 4 вида; отказ – 1 вариант.
Найти: – число сценариев.
Шаг 1. Делим разговор на шаги. Сначала бот выясняет, что и как подбирать, потом – чем закончить разговор.
Шаг 2. Первый шаг – это «или». Посетитель берёт книгу по одному из 3 признаков или фильм по одному из 2. Книгу и фильм сразу не подобрать, общих вариантов у веток нет. Складываем: вариантов первого шага.
Шаг 3. Второй шаг – тоже «или». Викторина одного из 4 видов или прощание: вариантов.
Шаг 4. Шаги между собой – «и». После любого из 5 вариантов подбора возможны все 5 окончаний. Умножаем: .
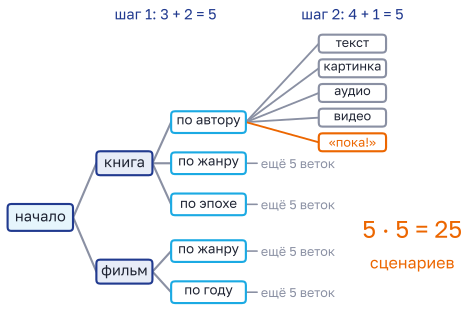
А если по большим веткам? Ветка «книга» даёт сценариев, ветка «фильм» – . Вместе – то же число.
Типичная ошибка. Перемножить всё подряд: . Но книга и фильм – ветки «или», их складывают. Коварство в том, что 24 очень похоже на 25, и прикидкой «на глаз» ошибку не поймать. Ещё часто забывают отказ от викторины и получают . Прощание – тоже конец разговора, то есть отдельный лист дерева.
Ответ: 25.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Дерево возможностей»
Реши сам
3.3. Бот-меню школьной столовой предлагает на первое суп (2 вида) или салат (3 вида), а к нему – один из 4 напитков. Сколько разных обедов «первое + напиток» можно заказать через бота?
ответ3.4. Бот доставки сначала спрашивает: «Пицца или роллы?» Пицц в меню 6 видов, наборов роллов – 3. Потом бот предлагает один из двух соусов или «без соуса». Сколько разных заказов «еда + соус» можно оформить через бота?
ответЗадача 3.3 Очередь на защиту
На защите проектов выступают 5 команд, порядок определяет жребий. Команда «Сигма» просит поставить её последней: капитан едет из Бердска и успеет только к концу. Сколько существует порядков выступления, при которых «Сигма» – последняя?
Дано: команд – 5; «Сигма» – на 5-м месте.
Найти: – число порядков.
Шаг 1. Что считаем. Порядок выступления – перестановка: команды занимают места с 1-го по 5-е, каждая по одному разу.
Шаг 2. Закрепляем «Сигму». Пятое место уже занято, выбора там нет, вариант один. Остаются 4 команды на 4 места.
Шаг 3. Считаем по местам. На 1-е место – любая из 4 оставшихся команд, на 2-е – любая из 3, на 3-е – из 2, на 4-е – последняя: .
Сверим со всеми порядками. Без условия их . Последней может оказаться любая из пяти команд, и ни у одной нет преимущества. Значит, «Сигме» достаётся пятая часть порядков: – тот же ответ.
Типичная ошибка. Считать «на первое место – любая из пяти» и получить 120. Но «Сигма» на первое место встать уже не может – она занята на пятом. Участника с закреплённым местом сразу убирают из выбора на остальные места.
Ответ: 24.
Своя задача по программе сферы, модуль 2
Реши сам
3.5. Шесть роботов встают в ряд для общей фотографии. Сколькими способами их можно расставить?
ответ3.6. Петя и ещё трое ребят по очереди рассказывают о своих проектах. Петя очень не хочет выступать первым. Сколько существует порядков выступления, в которых Петя не первый?
ответ3.7. В турнире по робофутболу играют 8 команд. Сколькими способами могут распределиться золотая, серебряная и бронзовая медали?
ответ3.8. В шахматном кружке 7 человек. Каждый сыграл с каждым ровно одну партию. Сколько всего партий было сыграно?
ответЗадача 3.4 Случайная песня
В плейлисте для поездки на дачу 20 песен: 8 – рок, 5 – рэп, 7 – поп. Включили режим «перемешать», первая песня выбирается случайно, у всех шансы одинаковые. Какова вероятность, что первой заиграет не рэп? Ответ дай в процентах.
Дано: песен – 20; из них рэп – 5.
Найти: – ?
Шаг 1. Все исходы. Опыт – выбор первой песни. Исходов 20, все равновозможные.
Шаг 2. Подходящие исходы. «Не рэп» – это рок или поп: песен. То же самое проще: .
Шаг 3. Вероятность. . В процентах: %.
Можно и через противоположное событие: , значит, %.
Типичная ошибка. Ответить 25 % – это вероятность рэпа, а спрашивали «не рэп». Частицу «не» в условии полезно подчеркнуть. Другая ошибка – : делить надо на число всех песен, а не только тех, что «не рэп».
Ответ: 75 %.
Своя задача по программе сферы, модуль 2
Реши сам
3.9. Бросают один кубик. Какова вероятность, что выпадет число больше 4? Ответ дай в процентах, округли до целых.
ответ3.10. В классе 25 человек, из них 10 мальчиков. Дежурного на сегодня выбирает программа, случайно и с равными шансами для всех. Какова вероятность, что дежурной будет девочка? Ответ дай в процентах.
ответЗадача 3.5 Выбраться из чёрной дыры
В настольной игре фишка вылетает из «чёрной дыры», только если на двух кубиках в сумме выпало не меньше 10. Какова вероятность вылететь с первого броска? Ответ дай в процентах, округли до целых.
Дано: кубиков – 2; нужна сумма .
Найти: – ?
Шаг 1. Все исходы. Кубики мысленно красим: красный и синий. Каждый даёт 6 вариантов, всего равновозможных исходов.
Шаг 2. Подходящие исходы. «Не меньше 10» – это 10, 11 или 12. Выпишем пары (красный, синий):
- сумма 10: (4, 6), (5, 5), (6, 4) – 3 исхода;
- сумма 11: (5, 6), (6, 5) – 2 исхода;
- сумма 12: (6, 6) – 1 исход.
Всего подходящих исходов. В таблице двух кубиков из раздела 3.4 это маленький треугольник в правом нижнем углу.
Шаг 3. Вероятность. . В процентах – 16,67 %, до целых – 17 %.
Много это или мало? Большие суммы на двух кубиках выпадают редко: нужны крупные числа сразу на обоих. Шесть клеток из 36 – меньше пятой части таблицы. Вот почему в таких играх из «дыры» обычно выбираются не с первого раза.
Типичная ошибка. Решить, что сумм всего 11 (от 2 до 12), а подходящих 3, и ответить %. Суммы не равновозможные: 7 выпадает шестью способами, а 12 – одним. Вторая ошибка – посчитать (4, 6) и (6, 4) одним исходом. Тогда подходящих станет 4, пар без учёта порядка – 21, и выйдет %. Тоже неверно: «5 и 5» выпадает одним способом, а «4 и 6» – двумя, такие исходы не равновозможные.
Ответ: 17 %.
Своя задача по программе сферы, модуль 2
Реши сам
3.11. Бросают два кубика. Какова вероятность «дубля» – одинаковых чисел на обоих кубиках? Ответ дай в процентах, округли до целых.
ответ3.12. Бот для настольной игры бросает три виртуальные монеты. Какова вероятность, что выпадет хотя бы один орёл? Ответ дай в процентах.
ответЗадача 3.6 Честна ли модель?
Фотоловушки в лесу под Новосибирском снимают всех, кто проходит мимо. Модель ищет на снимках лосей. Отобрали 60 снимков, про которые модель сказала «лось» с уверенностью 90 %. Экологи проверили их глазами: лось оказался на 42. Какова частота верных ответов модели на этих снимках в процентах? Честно ли модель оценивает свою уверенность?
Дано: снимков – 60; уверенность модели – 90 %; лось на самом деле – на 42 снимках.
Найти: частоту верных ответов в процентах; сравнить с уверенностью.
Шаг 1. Что проверяем. Уверенность 90 % обещает: среди многих таких ответов верных будет около 90 из 100. Проверить обещание можно только частотой – сразу на многих снимках.
Шаг 2. Частота. Верных ответов 42 из 60: . В процентах: %.
Шаг 3. Сравниваем. Обещано 90 %, вышло 70 %: из каждых 100 таких ответов верных на меньше, чем обещано. Если бы модель была честной, верных ответов было бы около , а их 42. Модель переоценивает себя – она самоуверенна.
Прикидка. 42 из 60 – больше половины, но далеко не «почти все». 70 % в эту вилку ложится.
Типичная ошибка. Сравнивать 42 с 90 или делить 42 на 90: это смешивание штук с процентами. Сначала переведи «42 из 60» в проценты, потом сравнивай. И не суди по одному снимку: «на этом фото лося нет, значит, модель врёт». Про один снимок уверенность ничего не обещает, судить можно только по многим.
Ответ: 70 %; модель самоуверенна – обещает 90 верных ответов из 100, а на деле выходит 70.
Своя задача по программе сферы, модули 1 и 2
Реши сам
3.13. Канцелярскую кнопку бросили на стол 400 раз, и 260 раз она упала остриём вверх. Сколько раз примерно она упадёт остриём вверх, если бросить её 1000 раз?
ответ3.14. Модель оценивает себя честно: её уверенность совпадает с частотой верных ответов. Она дала 300 ответов, и у каждого уверенность 90 %. Сколько примерно ошибок среди этих ответов?
ответ3.15. Модель различает на фото кошку, собаку и лису. Для очередного снимка она выдала: кошка – 70 %, собака – 20 %. Какую вероятность модель выдала для лисы? Какой ответ она назовёт?
ответЗадача 3.7* Что допишет модель
Маленькая языковая модель продолжает фразу «Завтра в Новосибирске …» двумя словами. Первое слово она выбирает так: «пойдёт» – с вероятностью 0,5, «будет» – 0,4, «ожидается» – 0,1. Второе слово зависит от первого. После «пойдёт»: «снег» – 0,45, «дождь» – 0,35, «град» – 0,2. После «будет»: «мороз» – 0,9, «оттепель» – 0,1. После «ожидается» – всегда «метель». Какое продолжение из двух слов модель пишет чаще всего и с какой вероятностью? Вероятность дай в процентах.
Дано: вероятности первого слова – 0,5; 0,4; 0,1; вероятности второго слова после каждого первого – по условию.
Найти: самую вероятную фразу из двух слов и её вероятность .
Шаг 1. Рисуем дерево. Из начала – три ветки первого слова, на каждой подписана её вероятность. Из каждого первого слова – ветки второго.
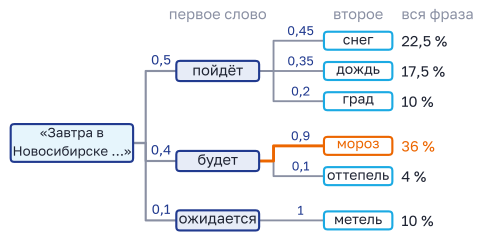
Шаг 2. Как посчитать одну фразу. Возьмём «пойдёт снег». В половине запусков модель начинает со слова «пойдёт», и среди этих запусков в 45 % дописывает «снег». Доля от доли: , то есть 22,5 %. На пальцах: из 1000 запусков «пойдёт» появится примерно в 500, а «снег» после него – в . Это тот же приём, что с сотней клеток в разделе 3.6.
Шаг 3. Считаем все шесть фраз.
| Фраза | Расчёт | Вероятность |
|---|---|---|
| пойдёт снег | 0,225 = 22,5 % | |
| пойдёт дождь | 0,175 = 17,5 % | |
| пойдёт град | 0,1 = 10 % | |
| будет мороз | 0,36 = 36 % | |
| будет оттепель | 0,04 = 4 % | |
| ожидается метель | 0,1 = 10 % |
Шаг 4. Выбираем наибольшую. Больше всех – «будет мороз», 36 %.
Не потеряли ли ветку? Модель всегда что-нибудь допишет, поэтому шесть фраз вместе обязаны дать 1: . Все на месте. Ту же таблицу выдаст программа:
pervoe = {"пойдёт": 0.5, "будет": 0.4, "ожидается": 0.1}
vtoroe = {"пойдёт": {"снег": 0.45, "дождь": 0.35, "град": 0.2},
          "будет": {"мороз": 0.9, "оттепель": 0.1},
          "ожидается": {"метель": 1.0}}

for w1 in pervoe:
    for w2 in vtoroe[w1]:
        p = pervoe[w1] * vtoroe[w1][w2]      # доля от доли
        print(w1, w2, round(p * 100, 1), "%")
Типичная ошибка. Взять самое вероятное первое слово («пойдёт», 0,5), к нему самое вероятное второе («снег», 0,45) и ответить «пойдёт снег». Но у «пойдёт» вероятность размазана по трём продолжениям, а у «будет» почти вся досталась «морозу». Выбор «по одному лучшему слову за раз» не всегда даёт самую вероятную фразу. А кто-то складывает вероятности вдоль ветки: . Больше 1 вероятность не бывает – это сигнал, что нужно было умножать.
Ответ: «будет мороз», 36 %.
Своя задача по программе сферы, модули 1 и 2
Реши сам
3.16. Клавиатура телефона подсказывает продолжение фразы «Встретимся …» двумя словами. Первое слово: «завтра» – с вероятностью 0,6, «вечером» – 0,4. После «завтра»: «утром» – 0,5, «днём» – 0,3, «вечером» – 0,2. После «вечером»: «дома» – 0,8, «там» – 0,2. Какое продолжение из двух слов клавиатура предложит чаще всего и с какой вероятностью? Вероятность дай в процентах.
ответ3.17.* Чат-бот отвечает на вопрос «Как дела?» двумя словами. Первое слово: «всё» – с вероятностью 0,6, «отлично» – 0,3, «нормально» – 0,1. После «всё»: «хорошо» – 0,5, «отлично» – 0,3, «нормально» – 0,2. После «отлично»: «спасибо» – 0,8, «сегодня» – 0,2. После «нормально» – всегда «спасибо». Какова вероятность, что в ответе бота встретится слово «отлично» (первым или вторым)? Ответ дай в процентах.
ответЗакономерности, последовательности, уравнения
Прогноз погоды на завтра, подсказка следующего слова в телефоне, цена поездки в приложении такси – за всем этим одна идея: найти правило и по нему угадать то, чего ещё не видели. В этой главе мы ищем правила в рядах чисел, записываем их буквами, решаем уравнения, а в конце проводим прямую через облако точек. Так работает самая простая модель машинного обучения – линейная регрессия. Задачи на эти темы обычно короткие: ряд чисел с пропуском, история, из которой нужно составить уравнение, таблица или график, по которым надо сделать прогноз. Чаще всего в ответ вводят одно число.
4.1. Ряды чисел: ищем правило
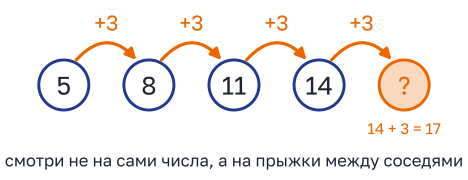
Между соседями каждый раз один и тот же прыжок: +3. Нашёл прыжок – знаешь, какое число будет дальше.
Числовая последовательность, или просто ряд, – числа, выписанные друг за другом по какому-то правилу. Каждое число ряда называют членом, и у каждого члена есть номер: первый, второй, третий… В ряду 5, 8, 11, 14 первый член – 5, а четвёртый – 14. Номер и сам член не путай: четвёртый член равен 14, а не 4.
Задача «найди следующее число» – это задача на поиск правила. Правило тебе никто не покажет. Его нужно угадать по нескольким числам и проверить на всех остальных. Так же учится и ИИ: ему дают примеры, он ищет в них закономерность и применяет её к новому. Компьютер может перебрать тысячи правил подряд, а тебе хватит пяти приёмов – пробуй их по порядку.
- Разности. Из каждого числа вычти предыдущее. Если разности одинаковые, ряд каждый раз растёт (или уменьшается) на одно и то же число. Ряд 7, 12, 17, 22: разности 5, 5, 5, значит, дальше .
- Отношения. Раздели каждое число на предыдущее. Если выходит одно и то же, ряд каждый раз умножается на это число. Ряд 3, 6, 12, 24: разности 3, 6, 12 разные, зато , , . Дальше . Подсказка, что пора делить: числа растут всё быстрее и быстрее.
- Разности разностей. Если разности не равны, но сами идут по понятному правилу – ищи правило в них. Ряд 3, 5, 9, 15, 23: разности 2, 4, 6, 8 растут на 2. Следующая разность 10, следующий член .
- Знакомые ряды. Квадраты чисел: 1, 4, 9, 16, 25 – это , , и так далее. Ряд, в котором каждое число – сумма двух предыдущих: 1, 1, 2, 3, 5, 8, 13, 21. Его называют рядом Фибоначчи, в честь итальянского математика, который описал его около восьмисот лет назад.
- Два ряда в одном. Если числа скачут то вверх, то вниз, выпиши отдельно числа с нечётных мест и с чётных. Ряд 2, 10, 4, 20, 6, 30 – это 2, 4, 6 и 10, 20, 30 вперемешку. Дальше идёт 8.
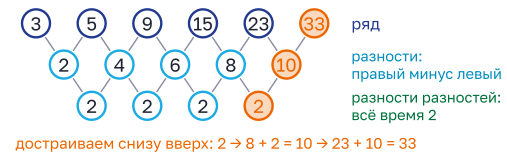
Одна честная оговорка. По трём-четырём числам правило иногда можно придумать разными способами. Ряд 1, 2, 4 продолжится числом 8, если каждый раз удваивать, и числом 7, если разности растут: 1, 2, 3. Поэтому в задачах дают пять-шесть членов, а ты проверяй найденное правило на каждом данном числе, а не на первых двух. У ИИ та же беда: мало примеров – и модель находит не то правило.
Разности удобно считать и в Python:
ryad = [3, 5, 9, 15, 23]
raznosti = []
for i in range(1, len(ryad)):
    raznosti.append(ryad[i] - ryad[i - 1])
print(raznosti)        # [2, 4, 6, 8]
В первой строке мы кладём ряд в список – набор чисел в квадратных скобках. Во второй заводим пустой список для разностей. Цикл for проходит по номерам i от 1 до последнего: len(ryad) – длина списка, 5, а range(1, 5) даёт номера 1, 2, 3, 4. Внимание: в Python счёт идёт с нуля, поэтому ryad[0] – это первое число, 3. Строка ryad[i] - ryad[i - 1] вычитает из числа его левого соседа, а append дописывает результат в конец списка.
Запомни. Порядок поиска: разности, отношения, разности разностей, знакомые ряды, два ряда вперемешку. Правило, которое подходит к первым двум числам, но не подходит к третьему, – не правило.
Совет. Выписывай разности прямо под рядом, мелкими цифрами в промежутках между числами. Следи за знаком: если число уменьшилось, разность отрицательная. У ряда 20, 17, 14 разности , .
4.2. Арифметическая прогрессия: n-й член без перебора
От первого члена до пятого – не пять шагов, а четыре. До сотого – 99.
Ряд, в котором к каждому числу прибавляют одно и то же, называется арифметической прогрессией. Число, которое прибавляют, – шаг прогрессии (в учебниках его зовут разностью), обозначают буквой . Шаг бывает и отрицательным: 50, 46, 42, 38 – прогрессия с шагом , она убывает.
Как найти, скажем, сотый член, не выписывая сто чисел? Встань на первый член и прыгай по ряду вперёд. Каждый прыжок прибавляет . До второго члена – один прыжок, до третьего – два, до десятого – девять. До члена с номером прыжков на один меньше, чем номер: .
Словами: член с номером n равен первому члену плюс шаг, умноженный на (n − 1). Буквами:
где – член с номером (читается «а энное»), – первый член, – шаг, – номер.
Пример. Ряд 5, 8, 11, 14, … Первый член 5, шаг 3. Сотый член: . Проверим формулу на том, что видим своими глазами: четвёртый член – как в ряду.
Обратная задача: какой у числа номер? Есть ли в ряду 5, 8, 11, … число 65, и если есть, какое оно по счёту? От первого члена до 65 нужно пройти . Это прыжков. Номер на единицу больше числа прыжков: . Значит, 65 – двадцать первый член. Проверка: . А числа 66 в ряду нет: на 3 нацело не делится, на число 66 мы не попадём никаким числом прыжков.
Ряд можно построить и в Python – прыжок за прыжком или сразу по формуле:
a = 5      # первый член
d = 3      # шаг
for n in range(1, 6):
    print(n, a)      # номер и член
    a = a + d        # прыгаем к следующему члену
print(5 + (100 - 1) * 3)   # сотый член по формуле: 302
Программа печатает пары «номер – член»: 1 5, 2 8, 3 11, 4 14, 5 17, а последней строкой – 302. Запись range(1, 6) означает номера от 1 до 5: число 6 в счёт не входит. Строка a = a + d читается так: «возьми старое a, прибавь шаг и положи результат обратно в a».
Для любопытных. Сумму арифметической прогрессии можно найти без долгого сложения. Есть известная история про Карла Гаусса, будущего великого математика. Учитель велел классу сложить все числа от 1 до 100, а маленький Гаусс почти сразу дал ответ. Он заметил, что , , … Таких пар 50, значит, сумма . Для любой арифметической прогрессии: сумма равна (первый член + последний) · количество членов : 2.
Здесь каждый раз не прибавляют, а умножают на 2. Поэтому каждый следующий прирост больше предыдущего: сначала +0,1 мм, потом +0,2 мм, потом +0,4 мм.
Геометрическая прогрессия – ряд, в котором каждое число умножают на одно и то же. Это число называют знаменателем и обозначают . Ряд 3, 6, 12, 24 – геометрическая прогрессия с . Логика прыжков та же, только прыжок теперь – умножение: до члена с номером нужно умножений, поэтому . Запись – степень: множителей, и каждый равен . Например, .
Такие ряды растут стремительно. Лист бумаги толщиной 0,1 мм после одного сгиба станет 0,2 мм, после второго – 0,4 мм. После десяти сгибов вышло бы мм – толще десяти сантиметров. Попробуй сложить настоящий лист хотя бы шесть раз подряд – к седьмому сгибу он почти перестаёт гнуться.
Запомни. : прыжков на один меньше, чем номер. Номер по числу – это (число − первый член) : шаг, и к результату прибавить 1. Не делится нацело – такого числа в ряду нет. В геометрической прогрессии вместо прибавления – умножение: .
4.3. Выражения с переменными
Кладёшь в машинку число x – она выполняет действия по порядку и выдаёт ответ. Положил другое x – получил другой ответ, а машинка та же.
Переменная – буква, вместо которой можно подставить число. Представь коробку с надписью «x»: надпись одна и та же, а положить внутрь можно любое число. Выражение с переменной, например , – это рецепт: «возьми x, умножь на 3, прибавь 2». Подставить в него число и посчитать – значит найти значение выражения.
Считаем по обычному порядку действий: сначала скобки, потом умножение и деление, потом сложение и вычитание. Пример: при . Скобка: . Умножение: . Сложение: .
Между числом и буквой знак умножения обычно не пишут: – это , а – это . В Python так нельзя. Там звёздочку ставят всегда, иначе программа выдаст ошибку:
x = 10
print(4 * (x - 3) + x)   # 38
Из слов – в выражение. Главное умение этого раздела – перевести историю на язык букв. Школьный автобус утром выезжает из гаража, в нём уже едут 6 человек, и на каждой остановке садятся ещё 4. Сколько людей в автобусе после остановок? После одной остановки , после двух , после – . Подставим : человек. Узнаёшь? Это арифметическая прогрессия из раздела 4.2, только номер теперь – переменная.
| Словами | Выражение |
|---|---|
| на 5 больше, чем x | |
| на 5 меньше, чем x | |
| в 5 раз больше, чем x | |
| в 5 раз меньше, чем x | |
| x тетрадей по 45 ₽ и ручка за 30 ₽ |
Подобные слагаемые. : две коробки с x да ещё три такие же – всего пять коробок. (одинокое – это ). Буквенные части складывают с буквенными, числа – с числами: . Это пригодится в уравнениях, где x стоит с двух сторон.
Запомни. Переменная – место для числа. Подставил – посчитал в порядке: скобки, умножение и деление, сложение и вычитание. «На …» – это плюс или минус, «в … раз» – умножение или деление.
Совет. Составил выражение – проверь его на маленьком числе, которое легко посчитать в уме. Для автобуса: после одной остановки должно быть 10 человек, и правда .
4.4. Линейные уравнения
Снимешь с обеих чаш одно и то же – равновесие не нарушится. Сняли по 2 кг: остались три пакета против 12 кг, значит, один пакет весит кг.
Уравнение – равенство, в котором есть неизвестное число, обычно его обозначают x. Решить уравнение – найти, какое число вместо x делает равенство верным. Такое число называют корнем уравнения. Уравнения, где x просто умножается на число и к нему что-то прибавляется, вроде , называют линейными. Откуда слово, станет ясно в разделе 4.5: у них график – прямая линия.
Правило весов: с обеими частями уравнения можно делать одно и то же – прибавлять, вычитать, умножать или делить на одно и то же число (только не делить на ноль). Равенство останется верным. Решаем, «снимая» с x всё лишнее в обратном порядке: что с x сделали последним, то снимаем первым.
Пример. . С x сначала умножили на 4, потом прибавили 9 – значит, первой уходит девятка. Вычитаем 9 из обеих частей: . Делим обе части на 4: . Проверка подстановкой: – верно.
| Уравнение | Как найти x | Корень |
|---|---|---|
| 12 | ||
| 28 | ||
| 18 | ||
| 7 | ||
| 36 | ||
| 12 |
Посмотри на третью и последнюю строки: там x стоит справа от знака минуса или деления, и правило другое. Если из 30 вычли что-то и осталось 12, то вычли . Не уверен в строчке – подставь корень и проверь.
x с двух сторон. . Снимем с обеих чаш по : . Дальше как обычно: , . Проверка: слева , справа – равны.
Уравнение из истории. Сначала обозначь буквой то, что ищешь, и сразу напиши единицы: «x – масса одного датчика, г». Потом найди величину, про которую в условии сказано двумя способами, и приравняй. А решив уравнение, проверь ответ по условию задачи, а не по своему уравнению.
Пример. Коробка с пятью одинаковыми датчиками весит 640 г, пустая коробка – 90 г. Сколько весит один датчик? Пусть x – масса датчика в граммах. Массу полной коробки можно записать как , и мы знаем, что она равна 640: . Вычитаем 90: . Делим на 5: г. Проверка по условию: пять датчиков по 110 г – это 550 г, вместе с коробкой г. Сошлось.
Корень можно проверить и в Python:
x = 7
print(4 * x + 9 == 37)   # True – корень найден верно
Двойное == – это вопрос «равны ли?». Ответ True значит «да», False – «нет». Одинарное = в первой строке делает другое: кладёт число 7 в переменную x.
Запомни. Что делаешь с одной частью уравнения, делай и с другой. Действия с x снимаем в обратном порядке. Корень всегда проверяй подстановкой.
Совет. В задачах с историей проверяй ответ по тексту условия. Если уравнение составлено неверно, корень подойдёт к уравнению, но не к истории – и только проверка по условию это поймает.
4.5. Линейная зависимость: правило предсказания
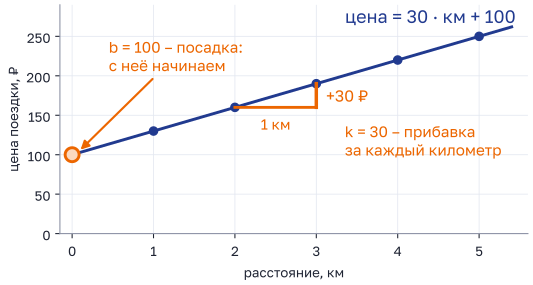
– с чего начинаем, цена поездки длиной 0 км. – на сколько цена растёт с каждым километром. Точки ложатся на прямую линию.
Часто одна величина зависит от другой: цена поездки – от расстояния, заряд квадрокоптера – от времени в полёте, высота сугроба – от числа снежных дней. Если каждый шаг по одной величине прибавляет к другой одно и то же, зависимость называют линейной и записывают так:
- – то, что мы знаем, вход: километры, минуты, градусы;
- – то, что хотим узнать, выход или прогноз;
- – на сколько меняется , когда увеличивается на 1 (его называют коэффициентом наклона);
- – чему равен , когда : стартовое значение.
Для такси с картинки ₽ за километр, ₽: . Поездка 7 км стоит ₽. Подставь – получишь 100, 130, 160, 190. Это арифметическая прогрессия с шагом ! Линейная зависимость – та же прогрессия, только может быть и дробным: поездка 2,5 км стоит ₽.
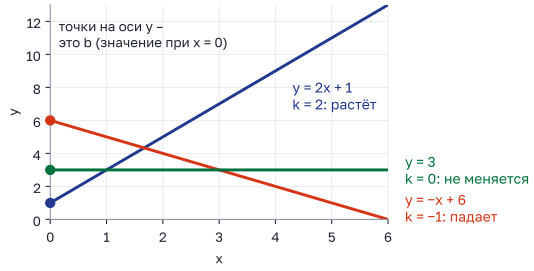
Как найти k и b по двум точкам. Сугроб у школы растёт равномерно: на 3-й день снегопадов в нём было 26 см, на 7-й день – 38 см. Сначала наклон: k равно тому, на сколько изменился y, делённому на то, на сколько изменился x:
Здесь – первая точка, – вторая. Теперь : подставим первую точку в правило, , откуда см. Правило: . Проверим второй точкой: – верно. Что значит ? Столько снега лежало в «нулевой» день, до начала подсчёта.
Прогноз – подставить в правило. Обратный вопрос – «когда y станет таким-то?» – это уравнение. Когда сугроб дорастёт до 50 см? , , – на 11-й день.
При чём тут ИИ. Правило – самая простая модель машинного обучения. Задача «предскажи число» называется регрессией (глава 1), а модель-прямая – линейной регрессией (linear regression). Числа и – её параметры: работает как вес нейрона, а – как его смещение. Когда говорят «модель обучилась», это значит, что компьютер сам подобрал и по примерам. На сфере работу в конструкторе GraphNet начинают как раз с линейной регрессии – об этом глава 7.
Запомни. : – прибавка на каждую единицу (со знаком), – значение при . . Прогноз – подставить . «Когда станет…» – решить уравнение.
Совет. Нашёл и по двум точкам – подставь третью точку из таблицы. Не сошлось – либо ошибка в счёте, либо зависимость не линейная. И считай разности всегда в одном порядке: вторая точка минус первая, и для , и для .
4.6. Прямая через облако точек и ошибка прогноза
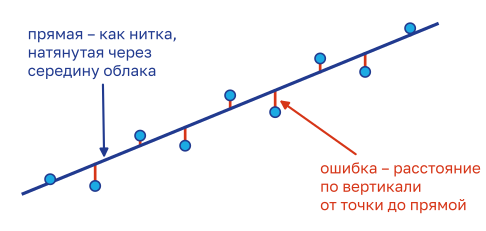
Модель – прямая, натянутая через середину облака, как нитка. Красные отрезки – ошибки: на сколько прогноз промахнулся в каждой точке.
В жизни точки почти никогда не ложатся на прямую ровно. Продажи кваса зависят от жары, но ещё и от дня недели, от того, пошёл ли дождь, приехал ли автобус с туристами. Такой разброс называют шумом. Задача линейной регрессии – провести одну прямую, которая проходит как можно ближе ко всем точкам сразу.
Как провести прямую на глаз:
- Посмотри на облако целиком. Вытянуто вдоль линии – хорошо. Если точки лежат кругом или выгибаются дугой, прямая – плохая модель, и никакая линейка её не спасёт.
- Приложи линейку так, чтобы точки были и сверху, и снизу, примерно поровну, а прямая шла вдоль всего облака – от левого края до правого.
- Не гонись за одной странной точкой. Выброс – значение, которое сильно отличается от остальных: датчик заглючил, кто-то опечатался при вводе. Прямая, которая тянется к выбросу, хуже предсказывает все остальные точки.
- Выбери на своей прямой две точки подальше друг от друга, лучше в узлах сетки, и найди по ним и , как в разделе 4.5.
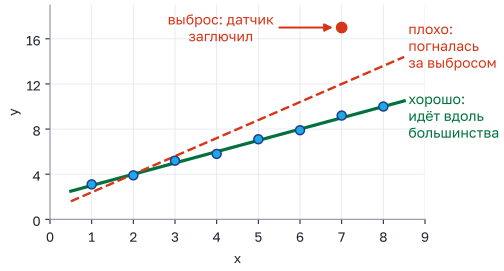
Два человека проведут прямые чуть по-разному, и их прогнозы разойдутся на пару единиц. Это нормально: «на глаз» – значит приблизительно. В задачах этой книги прямая уже проведена или названы две её точки, чтобы ответ был один.
Ошибка прогноза. Для каждой точки:
Ошибка со знаком плюс – модель занизила: прогноз меньше правды. Со знаком минус – завысила. Когда сравнивают модели, знак отбрасывают и смотрят только на размер промаха. Средняя ошибка – та, что в главе 1: сложить ошибки без знака и разделить на число точек. Чем она меньше, тем лучше прямая описывает данные.
Пример. Прямая и четыре точки: , , , . Прогнозы: 3, 5, 7, 9. Ошибки: , , , . Средняя ошибка без знака . А теперь сложи ошибки со знаком: . Выходит, будто модель не ошиблась ни разу, хотя она промахнулась в каждой точке. Вот зачем знак отбрасывают.
Где прямой верить. Прогноз надёжен внутри облака и чуть-чуть за его краями. Далеко за краем прямая может выдать чушь. Прямая, которая хорошо предсказывает летние продажи мороженого, в январский мороз пообещает отрицательное число порций. Модель знает только то, что видела в примерах.
Для любопытных. Компьютер проводит прямую не на глаз. Чаще всего он подбирает и так, чтобы сумма квадратов ошибок была как можно меньше. Этот способ называют методом наименьших квадратов. Квадрат строже наказывает за большие промахи: одна ошибка на 10 даёт 100, а десять ошибок по 1 – всего 10. Нейросети учатся похоже, только постепенно: чуть-чуть меняют параметры, смотрят, уменьшилась ли ошибка, и повторяют так много раз.
Запомни. Ошибка = настоящее − прогноз: плюс – модель занизила, минус – завысила. Две модели сравнивают по средней ошибке без знака – у кого она меньше, та и лучше. Одна странная точка – не повод гнуть прямую, а далеко за краем облака прямой не верь.
4.7. Разбираем задачи
Задача 4.1 Какое число дальше
Найди следующее число в каждом ряду.
а) 7, 12, 17, 22, …
б) 3, 6, 12, 24, …
в) 2, 3, 6, 11, 18, 27, …
Дано: три ряда чисел.
Найти: следующий член каждого ряда.
Шаг 1. Ряд а), разности. , , . Все разности равны 5 – каждый раз прибавляем пять. Дальше .
Шаг 2. Ряд б), разности. , , – разные. Числа растут всё быстрее – пробуем делить.
Шаг 3. Ряд б), отношения. , , . Каждый раз умножаем на 2. Дальше .
Шаг 4. Ряд в), разности. , , , , . Разности разные, но это нечётные числа подряд: 1, 3, 5, 7, 9. Разности разностей – всё время 2. Следующая разность , следующий член .
Ряд б) разгоняется, поэтому и ответ у него «прыгнул» сильнее всех: с 24 сразу на 48.
Посмотрим на все три ответа вместе. Ряды растут, и каждый ответ больше последнего числа своего ряда. В ряду б) рост ускоряется, поэтому и ответ «прыгнул» сильнее всех: с 24 сразу на 48.
Типичная ошибка. Увидеть последнюю разность и прибавить её ещё раз. В ряду б) последняя разность 12, и выходит . В ряду в) последняя разность 9, и выходит тоже . Разность не обязана повторяться – сначала найди, по какому правилу меняются сами разности.
Ответ: а) 27; б) 48; в) 38.
Своя задача по программе сферы, модуль 2
Реши сам
4.1. Найди следующее число в ряду: 81, 27, 9, 3, …
ответ4.2. Найди следующее число в ряду: 1, 3, 7, 15, 31, …
ответ4.3.* В первый день ролик кружка посмотрели 5 человек. Каждый следующий день ролик смотрели втрое больше людей, чем накануне. В какой по счёту день число просмотров за день впервые станет больше 10 000?
ответЗадача 4.2 Скачиваем каталог по страницам
Сервер с каталогом фильмов отдаёт данные страницами: на каждой странице 25 записей, записи идут по порядку номеров (на первой странице – записи с 1 по 25, на второй – с 26 по 50 и так далее). Всего в каталоге 318 записей. Один запрос к серверу приносит одну страницу.
а) Сколько запросов нужно сделать, чтобы скачать весь каталог?
б) С записи с каким номером начинается 9-я страница?
в) На какой странице лежит запись № 250?
Дано: 25 записей на странице; всего 318 записей.
Найти: число запросов; первую запись 9-й страницы; страницу записи № 250.
Шаг 1. Зачем это считать. Программы, которые собирают данные из интернета, почти всегда получают их порциями – страницами. Сколько страниц придётся попросить, считают заранее.
Шаг 2. а) Полные страницы. . Значит, 12 страниц заполнены целиком – на них записей.
Шаг 3. а) Хвост. Осталось записей. Им нужна ещё одна, 13-я страница, неполная. Всего 13 запросов. Число страниц округляем вверх: даже одна лишняя запись требует отдельного запроса.
Шаг 4. б) Первые записи страниц. Первые номера страниц – 1, 26, 51, 76, … Это арифметическая прогрессия: первый член 1, шаг 25. До 9-й страницы – прыжков: .
Шаг 5. в) Страница записи № 250. Делим номер записи на число записей на странице: – ровно. Значит, запись № 250 – последняя на 10-й странице. Проверим: 10-я страница начинается с записи и кончается записью .
Шаг 6. Проверка программой.
import math
vsego = 318      # записей в каталоге
na_str = 25      # записей на странице
print(math.ceil(vsego / na_str))    # а) 13
print(1 + (9 - 1) * na_str)         # б) 201
print(math.ceil(250 / na_str))      # в) 10
import math подключает набор математических функций, а math.ceil округляет число вверх до целого: 12,72 → 13.
Не многовато ли 13? 13 страниц по 25 – это место на 325 записей, чуть больше 318. А 12 страниц вместили бы только 300. Меньше 13 никак.
Типичная ошибка. В а) – округлить 12,72 по обычным правилам или вниз и ответить 12: последние 18 записей так и не скачаются. В б) – сделать столько прыжков, сколько номер: . Это первая запись 10-й страницы. В в) ловушка появляется, когда деление не нацело: запись № 260 даёт , и страница здесь 11-я (округляем вверх), а не 10-я.
Ответ: а) 13 запросов; б) с записи № 201; в) на 10-й странице.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Сбор данных»
Реши сам
4.4. Нейросеть рисует узор из клеток. В первом ряду 5 клеток, в каждом следующем – на 4 больше, чем в предыдущем. Сколько клеток в 30-м ряду?
ответ4.5. Сервер отдаёт данные страницами по 40 записей, записи идут по порядку номеров (на первой странице – с 1 по 40). На какой странице лежит запись № 587?
ответ4.6. Ряд 10, 16, 22, 28, … – арифметическая прогрессия. Каким по счёту членом в нём стоит число 250?
ответЗадача 4.3 Сколько рисует нейросеть
Нейросеть-художник сначала загружается – на это уходит 12 секунд, – а потом рисует картинки по одной, каждую за одно и то же время. Лиза заказала 8 картинок, и от нажатия кнопки до появления последней картинки прошла 1 минута 40 секунд. Сколько секунд нейросеть рисует одну картинку?
Дано: загрузка 12 с; 8 картинок; всё вместе – 1 мин 40 с.
Найти: – время на одну картинку, с.
Шаг 1. Переводим единицы. Загрузка дана в секундах, значит, и общее время нужно в секундах: 1 мин 40 с с.
Шаг 2. Обозначаем. Пусть – время на одну картинку в секундах.
Шаг 3. Составляем уравнение. Общее время можно записать двумя способами. Через : загрузка плюс 8 картинок, то есть . И по условию оно равно 100 с. Приравниваем: .
Шаг 4. Решаем. Вычитаем 12 из обеих частей: . Делим обе части на 8: .
Шаг 5. Проверка по условию. Загрузка 12 с, восемь картинок по 11 с – это 88 с, всего с = 1 мин 40 с, как в условии.
А если бы без загрузки? Тогда на картинку ушло бы с. Загрузка съела часть времени, так что ответ обязан быть меньше 12,5 – и 11 с сюда подходит.
Типичная ошибка. Записать 1 мин 40 с как 140 с или как 1,4 мин. В минуте 60 секунд, а не 100. А ещё забывают про загрузку и делят всё время на 8: получается 12,5 с.
Ответ: 11 с.
Своя задача по программе сферы, модуль 2
Реши сам
4.7. Реши уравнение .
ответ4.8. 3D-принтер в кружке сначала 6 минут разогревается, а потом печатает одинаковые фигурки, каждую за одно и то же время. Девять фигурок вместе с разогревом заняли 1 час 36 минут. Сколько минут печатается одна фигурка?
ответ4.9. Сопоставь описание и выражение. 1) на 3 больше, чем удвоенное x; 2) удвоенная сумма x и 3; 3) x уменьшили на 3, а результат удвоили; 4) x уменьшили в 3 раза, а потом прибавили 2. Выражения: А) ; Б) ; В) ; Г) . Ответ запиши парами «цифра – буква».
ответ4.10. Найди значение выражения при и .
ответЗадача 4.4 Заряд квадрокоптера
Во время полёта заряд аккумулятора квадрокоптера падает равномерно. Через 2 минуты после взлёта пульт показал 88 %, через 5 минут – 70 %. По правилам кружка квадрокоптер сажают, когда заряд опускается до 10 %.
а) С каким зарядом квадрокоптер взлетел?
б) Через сколько минут после взлёта его нужно сажать?
Дано: мин, %; мин, %; посадка при 10 %.
Найти: – заряд при взлёте; – время до посадки, мин.
Шаг 1. Что происходит. «Падает равномерно» – значит, каждую минуту заряд уменьшается на одно и то же число процентов. Зависимость линейная: , где – минуты полёта, – заряд в процентах.
Шаг 2. Находим k. За минуты заряд изменился на %. За одну минуту: % в минуту. Минус – потому что заряд падает.
Шаг 3. Находим b. Подставим первую точку: , то есть , и %. Это ответ на вопрос а): в момент взлёта () заряд был 100 %.
Шаг 4. Проверяем правило. . Вторая точка: – верно.
Шаг 5. Когда сажать. Нужно, чтобы заряд стал 10 %: . Прибавим к обеим частям, чтобы избавиться от минуса: . Вычтем 10: . Разделим на 6: мин.
Взлетели с полной батареей – логично. А четверть часа в воздухе – обычное время для небольшого квадрокоптера.
Много это или мало? От 100 % до 10 % – это 90 процентных пунктов, по 6 в минуту как раз выходит 15 минут. Четверть часа в воздухе – обычное время для небольшого квадрокоптера.
Типичная ошибка. Потерять минус у : тогда , и выходит, что заряд при взлёте был меньше, чем через 2 минуты полёта, – так не бывает. И не попадись на «10 минут»: столько осталось лететь после пятой минуты, а спрашивали время после взлёта.
Ответ: а) 100 %; б) через 15 минут после взлёта.
Своя задача по программе сферы, модуль 2
Реши сам
4.11. Воду в кастрюле греют на плите, температура растёт равномерно. В начале было 20 °C, через минуту – 28 °C, через две – 36 °C, через три – 44 °C. Через сколько минут от начала вода нагреется до 100 °C?
ответ4.12.* Весной сугроб у крыльца тает равномерно. 1 апреля его высота была 60 см, 6 апреля – 45 см. Какого числа апреля от сугроба ничего не останется, если он будет таять так же? Ответ – число месяца.
ответЗадача 4.5 Квас и жара
Хозяйка киоска на берегу Обского моря неделю записывала температуру воздуха в полдень и число стаканов кваса, проданных за день. Каждая точка на графике – один день. Аналитик провёл через точки прямую, она проходит через два узла сетки, отмеченных оранжевыми кружками.
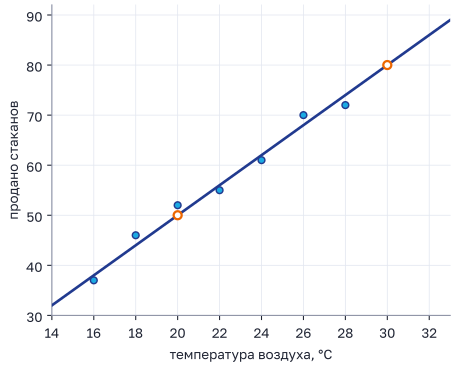
а) Запиши правило прямой в виде , где – температура в градусах, – число стаканов.
б) Сколько стаканов прямая предсказывает на день с температурой 32 °C?
в) В день, когда было 26 °C, продали 70 стаканов. Какова ошибка прогноза в этот день?
Дано: график, прямая через два узла сетки.
Найти: , ; прогноз при 32 °C; ошибку при 26 °C.
Шаг 1. Читаем точки прямой. Кружки стоят в узлах и : при 20 °C прямая показывает 50 стаканов, при 30 °C – 80.
Шаг 2. Находим k. . Каждый градус жары – плюс 3 стакана.
Шаг 3. Находим b. , , . Правило: . Проверка второй точкой: – верно.
Шаг 4. Прогноз на 32 °C. стаканов.
Шаг 5. Ошибка при 26 °C. Прогноз: стаканов. Ошибка: . Плюс – модель занизила: продали на 2 стакана больше, чем она обещала.
Сверься с графиком. Точка для 26 °C и правда чуть выше прямой. Прогноз 86 для 32 °C больше, чем в самый жаркий день недели (28 °C, 72 стакана), – в жару квас берут охотнее. 32 °C лежит чуть правее облака точек, так что прогнозу можно верить, но с осторожностью. А вот не пугайся: при 0 °C прямая обещает минус десять стаканов, но 0 °C далеко за краем данных, туда прямую никто не применяет.
Типичная ошибка. Взять для расчёта голубые точки вместо узлов на прямой. Точки – это данные, а правило модели задаёт прямая. Например, точки и дадут , но – и все прогнозы сдвинутся. Вторая ошибка – найти как : забыли умножить на .
Ответ: а) ; б) 86 стаканов; в) +2 стакана (модель занизила на 2).
Своя задача по программе сферы, модуль 5
Реши сам
4.13. Модель предсказывает, сколько литров воды за день выпивают ребята в летнем лагере, по температуре воздуха (в градусах). Прямая модели проходит через точки и . а) Запиши правило прямой в виде . б) Сколько литров модель предскажет на день с температурой 27 °C? в) В день, когда было 24 °C, выпили 41 литр. Какова ошибка прогноза в этот день?
ответ4.14. Маша тренируется бегать круг по стадиону. Модель предсказывает время круга (в секундах) по номеру тренировки , её прямая проходит через точки и . а) Запиши правило прямой. б) На какой тренировке модель обещает круг за 40 с? в) На 8-й тренировке Маша пробежала круг за 50 с. Какова ошибка прогноза?
ответЗадача 4.6* Две модели для такси
Две команды обучили модели, которые предсказывают цену поездки на такси по расстоянию. Модель А: . Модель Б: (здесь – расстояние в километрах, – цена в рублях). Модели проверили на пяти настоящих поездках:
| Расстояние, км | Настоящая цена, ₽ |
|---|---|
| 2 | 180 |
| 4 | 235 |
| 6 | 290 |
| 8 | 330 |
| 10 | 395 |
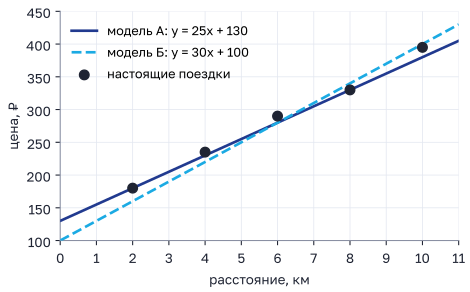
а) Найди среднюю ошибку каждой модели (в рублях). б) Какая модель лучше? в) Какую цену она предскажет за поездку 12 км?
Дано: две модели, пять поездок.
Найти: средние ошибки А и Б; лучшую модель; её прогноз для 12 км.
Шаг 1. Прогнозы. Подставляем каждое расстояние в обе формулы. Для 2 км: А – , Б – . Остальные – так же, всё собрано в таблице.
Шаг 2. Ошибки без знака. Из настоящей цены вычитаем прогноз и отбрасываем знак.
| Км | Цена | Прогноз А | Ошибка А | Прогноз Б | Ошибка Б |
|---|---|---|---|---|---|
| 2 | 180 | 180 | 0 | 160 | 20 |
| 4 | 235 | 230 | 5 | 220 | 15 |
| 6 | 290 | 280 | 10 | 280 | 10 |
| 8 | 330 | 330 | 0 | 340 | 10 |
| 10 | 395 | 380 | 15 | 400 | 5 |
Шаг 3. Средние ошибки. А: ₽. Б: ₽.
Шаг 4. Сравниваем. У модели А средняя ошибка меньше: 6 ₽ против 12 ₽. Она лучше.
Шаг 5. Прогноз на 12 км. ₽.
Шаг 6. Проверка программой.
km = [2, 4, 6, 8, 10]
cena = [180, 235, 290, 330, 395]

def srednyaya_oshibka(k, b):
    summa = 0
    for i in range(len(km)):
        prognoz = k * km[i] + b
        summa = summa + abs(cena[i] - prognoz)
    return summa / len(km)

print(srednyaya_oshibka(25, 130))   # модель А: 6.0
print(srednyaya_oshibka(30, 100))   # модель Б: 12.0
print(25 * 12 + 130)                # прогноз А на 12 км: 430
Построчно: def создаёт свою функцию – маленькую программу с именем, в которую передают и . Внутри цикл проходит по всем поездкам, считает прогноз и прибавляет к сумме ошибку. abs – модуль, он отбрасывает знак: abs(-20) даёт 20. return возвращает ответ – сумму, делённую на число поездок. Python печатает 6.0 с точкой – в тетради это 6,0.
На графике то же самое: прямая А проходит точно через точки для 2 и 8 км и совсем рядом с точкой для 4 км, а прямая Б заметно промахивается на коротких поездках. На последней поездке (10 км) Б ошиблась меньше, чем А, – 5 ₽ против 15 ₽. Но модель оценивают по всем примерам, а не по одному удачному.
Типичная ошибка. Складывать ошибки со знаком. У модели Б тогда выйдет , средняя 6 ₽ – ровно как у А, и модели покажутся одинаковыми. Плюсы и минусы съели друг друга, хотя Б промахивается сильнее. Средняя ошибка считается без знака.
Ответ: а) А – 6 ₽, Б – 12 ₽; б) модель А; в) 430 ₽.
Своя задача по программе сферы, модуль 5
Реши сам
4.15. Модель предсказывает время поездки школьного автобуса (в минутах) по числу остановок : . Настоящие поездки: 5 остановок – 21 мин, 10 остановок – 28 мин, 15 остановок – 41 мин, 20 остановок – 49 мин. Найди среднюю ошибку модели в минутах.
ответ4.16.* Две модели предсказывают, сколько минут Коля делает домашнее задание по математике, по числу задач . Модель А: . Модель Б: . Настоящие вечера: 2 задачи – 18 мин, 4 задачи – 27 мин, 6 задач – 34 мин, 8 задач – 43 мин. а) Найди среднюю ошибку каждой модели. б) Какая модель лучше? в) Сколько минут она предскажет на 10 задач?
ответЗадача 4.7* Два тарифа для обучения нейросети
Чтобы обучить нейросеть, школьная команда арендует через интернет мощный компьютер. Тариф «Старт»: 300 ₽ за подключение и 12 ₽ за каждую минуту работы. Тариф «Про»: 60 ₽ за подключение и 20 ₽ за минуту.
а) При какой длительности обучения оба тарифа стоят одинаково?
б) Обучение займёт 45 минут. Какой тариф выгоднее и на сколько рублей?
Дано: «Старт» – 300 ₽ + 12 ₽/мин; «Про» – 60 ₽ + 20 ₽/мин; обучение 45 мин.
Найти: – длительность, при которой цены равны, мин; выгодный тариф при 45 мин и экономию, ₽.
Шаг 1. Два правила. Пусть – время обучения в минутах. «Старт» стоит рублей, «Про» – рублей. Это две линейные зависимости: у «Старта» , , у «Про» , .
Шаг 2. Уравнение. Цены равны: .
Шаг 3. Решаем. Снимаем с обеих частей по : . Снимаем по 60: . Делим на 8: мин.
Шаг 4. Проверка. «Старт»: ₽. «Про»: ₽. Одинаково.
Шаг 5. 45 минут. «Старт»: ₽. «Про»: ₽. Выгоднее «Старт», экономия ₽.
Шаг 6. Проверка другим способом. После 30-й минуты тарифы стоят одинаково, а дальше каждая минута «Старта» дешевле на ₽. С 30-й до 45-й минуты – 15 минут, экономия ₽ – те же деньги.
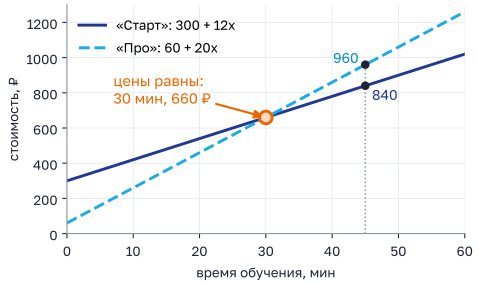
Кому какой тариф. «Про» дешевле на старте, но дороже за минуту. Значит, для коротких заданий выгоден он, а для долгих – «Старт». Точка, где тарифы меняются местами, – 30 минут, и 45 минут лежит после неё.
Типичная ошибка. Сравнить только цену подключения («Про» дешевле – значит, он и выгоднее) или только цену минуты. Выгоду решают оба числа вместе. Ещё одна ошибка в счёте: – поделили не на разницу цен минуты (), а на цену минуты одного тарифа.
Ответ: а) 30 минут; б) «Старт», дешевле на 120 ₽.
Своя задача по программе сферы, модуль 2
Реши сам
4.17. Кружок робототехники заказывает печать деталей. Мастерская А: 200 ₽ за заказ и 15 ₽ за каждую деталь. Мастерская Б: 50 ₽ за заказ и 25 ₽ за деталь. а) При скольких деталях заказ в обеих мастерских стоит одинаково? б) Нужно 22 детали. Где дешевле и на сколько рублей?
ответ4.18.* Прокат самокатов. Тариф А: 50 ₽ за старт и 8 ₽ за минуту. Тариф Б: старт бесплатно, 10 ₽ за минуту. При какой длительности поездки (в минутах) тарифы стоят одинаково?
ответДанные: собираем и наводим порядок
Любая нейросеть начинается не с нейронов, а с таблицы. Кто-то должен собрать примеры, записать их в файл, выкинуть повторы и опечатки – и только потом модель чему-то научится. В главе пройдём этот путь целиком: откуда берутся данные, как устроены файлы CSV и JSON, как программа забирает записи с сайта страница за страницей и как навести порядок в таблице, прежде чем считать. На отборе прошлых лет встречались как раз такие задачи: сколько страниц скачать у сервера, какие три книги самые популярные в жанре. Ответ в них – число или несколько шифров через запятую.
5.1. Данные, датасет и таблица
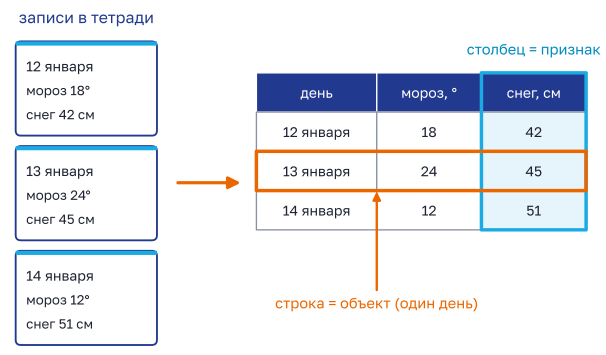
Каждая запись в тетради – одна строка таблицы. Каждое поле записи – свой столбец.
Данные – это записанные наблюдения: числа, слова, отметки «да» или «нет». Термометр за окном показывает −18 °C – пока ты просто смотришь, это не данные. Записал в тетрадь «12 января, мороз 18°, снег 42 см» – появились данные. Их можно сравнить с завтрашними, отправить другу, посчитать по ним среднее.
Если записи однотипные – про каждый день одно и то же, про каждого ученика одно и то же, – их удобно сложить в таблицу. Набор однотипных записей называют набором данных, или датасетом (dataset). В таблице датасета:
- строка – один объект: один день, один ученик, одна книга, один пассажир;
- столбец – одно свойство объекта: дата, мороз, высота снега. В анализе данных столбцы так и называют – признаками;
- клетка – одно значение: «снег 13 января – 45 см»;
- заголовок – самая верхняя строка с именами столбцов. Это не запись, объекта за ней нет.
Размер таблицы говорят так: «столько-то строк на столько-то столбцов». В образовательном курсе сферы собирают набор данных о пассажирах космического лайнера: 8693 строки и 14 столбцов. Сколько в нём значений? Строки умножаем на столбцы, как клетки в прямоугольнике тетрадного листа: клетки. Больше ста тысяч – руками такую таблицу не заполнишь, её собирает программа.
В главе 1 мы делили столбцы на признаки, ответ (целевую переменную) и идентификаторы – это нужно, когда по таблице учат модель. Здесь вопрос другой: как таблицу получить и как привести её в порядок.
Запомни. Строка – объект, столбец – признак (свойство), клетка – одно значение. Строка заголовка – не запись. Число клеток = число строк · число столбцов.
5.2. Типы данных: число, текст, да/нет, дата
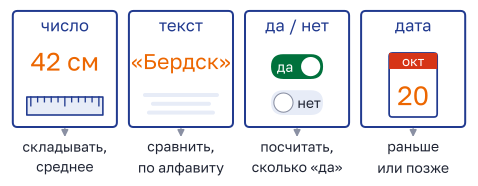
Тип значения решает, что с ним можно делать. Числа складывают, тексты сравнивают, «да» считают, даты ставят по порядку.
В одной таблице встречаются значения разных типов:
- число – высота снега 42 см, цена 350 руб., мороз −12,5°. Бывает целым (42) и дробным (−12,5);
- текст (его ещё называют строкой) – «Бердск», «Незнайка на Луне», «фантастика»;
- да/нет – был ли снег, есть ли электронная версия книги. В файлах это пишут по-разному: «да/нет», 1 и 0, True и False;
- дата (и время) – 20.10.2026, 14:30.
Для анализа данных важнее другое деление – всего на две группы. Количественные данные – числа, которые что-то измеряют или считают: рост, цена, число страниц, мороз. С ними можно делать арифметику: сложить, найти среднее. Категориальные данные – значения-ярлыки: город, жанр, цвет, «да» или «нет». Их можно сравнить («одинаковые или разные?») и посчитать, сколько раз встречается каждый ярлык. Складывать их нельзя: «Бердск + Искитим» – бессмыслица.
Самая частая ловушка – цифры, которые не количество. Номер школы, номер телефона, почтовый индекс, шифр книги в библиотеке записаны цифрами, но это ярлыки, как номерок в гардеробе. Средний номер школы по району посчитать можно, только он ничего не значит. Проверка простая: есть ли смысл сложить эти значения или найти среднее? Есть – количественные. Нет – категориальные, даже если там цифры.
У компьютера свои названия типов. В Python целое число – int, дробное – float, текст – str, да/нет – bool (значения True и False). Функция type показывает тип, а int(...) превращает текст из цифр в число:
print(type(42))                    # <class 'int'> – целое число
print(type(-12.5))                 # <class 'float'> – дробное число
print(type("Бердск"))              # <class 'str'> – текст
print(type(True))                  # <class 'bool'> – да/нет
print("38" + "41")                 # 3841 – два текста просто склеились
print(int("38") + int("41"))       # 79 – а это уже сложение чисел
print(sorted(["9", "10", "100"]))  # ['10', '100', '9'] – тексты встали по алфавиту
Последние три строки – главная засада. Когда программа читает таблицу из файла, числа часто приходят текстом. Текст «38» и число 38 для компьютера – разные вещи. Два текста при + склеиваются, а при сортировке встают по алфавиту: «1…» раньше «9…», как «арбуз» раньше «яблока». Поэтому перед подсчётами числа из файла переводят в числа.
С датами то же самое. Мы пишем 20.10.2026 – день, месяц, год. Если отсортировать такие даты как текст, компьютер сравнит сначала дни: «03.11» окажется раньше «15.09», хотя ноябрь позже сентября. Поэтому в данных даты часто пишут наоборот: год-месяц-день, 2026-10-20. Тогда сортировка по алфавиту совпадает с сортировкой по времени.
Запомни. Количественные данные можно складывать и усреднять, категориальные – только сравнивать и пересчитывать. Цифры в номере, шифре, индексе – это ярлык, а не количество. Числа из файла сначала переведи из текста в число.
Совет. Увидел в программе странный результат вроде «3841» вместо 79 или «10» раньше «9» – почти наверняка числа остались текстом. Оберни значение в int(...) или float(...).
5.3. Форматы файлов: CSV и JSON
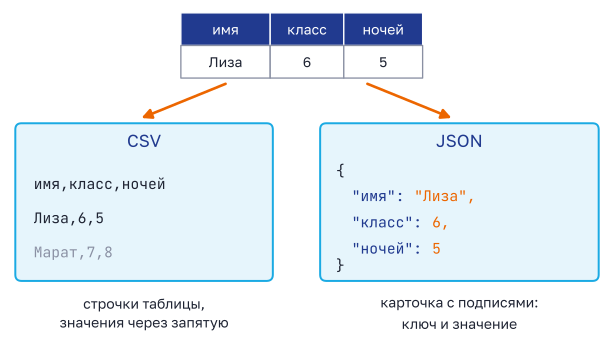
CSV записывает таблицу строчками через запятую. JSON – как карточка, где у каждого значения есть подпись.
Таблицу на экране ты видишь с линиями и клетками. А в файле она хранится как обычный текст. Формат – это правило, по которому таблицу записывают текстом, чтобы другая программа поняла её так же. Для данных чаще всего встречаются два формата.
CSV (сокращение от английского «значения через запятую») – самый простой. Открой такой файл в Блокноте, и увидишь:
имя,класс,ночей
Лиза,6,5
Марат,7,8
Вера,5,3
Первая строка – заголовок, имена столбцов. Каждая следующая – одна запись. Значения внутри строки разделены запятой. Отсюда удобно считать: записей в файле на одну меньше, чем строк (здесь 4 строки, значит, 3 записи), а запятых в каждой строке на одну меньше, чем столбцов (3 столбца – 2 запятые).
Разделителем бывает не только запятая. Русский Excel часто сохраняет CSV через точку с запятой: у нас запятая уже занята в дробных числах (12,5). А если запятая нужна внутри значения, его берут в кавычки: "Новосибирск, Академгородок".
Прочитать CSV в Python можно без всяких установок – модуль csv встроен:
import csv, io

text = """дата,снег_см
01.12,38
02.12,41
03.12,44"""

rows = list(csv.DictReader(io.StringIO(text)))
print(len(rows))              # 3 – записи, без строки заголовка
print(rows[0])                # {'дата': '01.12', 'снег_см': '38'}
total = 0
for r in rows:
    total = total + int(r["снег_см"])
print(total)                  # 123
Что здесь происходит. Первая строка подключает два встроенных модуля. В переменную text мы положили маленький CSV прямо в программе. Тройные кавычки разрешают писать текст в несколько строк. io.StringIO(text) делает из строки как бы файл, а csv.DictReader читает его и превращает каждую запись в словарь – пары «имя столбца: значение». list(...) собирает все записи в список rows. Дальше цикл for идёт по записям и прибавляет к total высоту снега. Зачем int(...)? В словаре лежит текст '38', а не число, и без перевода вместо сложения вышла бы склейка. Для настоящего файла вместо io.StringIO(text) пишут open("sneg.csv", encoding="utf-8").
JSON устроен иначе. В нём у каждого значения есть подпись – ключ:
{
  "club": "Юный астроном",
  "members": [
    {"name": "Лиза", "class": 6, "nights": 5},
    {"name": "Марат", "class": 7, "nights": 8}
  ]
}
Правила JSON:
- фигурные скобки
{ }– объект, та самая карточка: внутри пары"ключ": значениечерез запятую; - квадратные скобки
[ ]– список: значения по порядку через запятую; - текст – в двойных кавычках, числа – без кавычек и с точкой вместо запятой (
-12.5); - да и нет пишут как
trueиfalse, пустое значение –null; - внутри карточки может лежать список, а в списке – снова карточки. Так, как в примере выше: у кружка есть список участников, и про каждого – своя карточка.
Чтобы достать значение, идут по ключам и номерам, как по адресу: сначала ключ, потом номер в списке, потом снова ключ. Номера в списке начинаются с нуля: первая карточка – [0], вторая – [1].
import json

text = '{"club": "Юный астроном", "members": [{"name": "Лиза", "nights": 5}, {"name": "Марат", "nights": 8}]}'
data = json.loads(text)             # из текста JSON – в словари и списки Python
print(data["club"])                 # Юный астроном
print(len(data["members"]))         # 2 – в списке две карточки
print(data["members"][1]["name"])   # Марат – [1] это ВТОРАЯ карточка
Когда использовать какой формат? CSV – для ровных таблиц, где у всех записей одинаковые столбцы: он короче. JSON – когда у данных есть вложенность (у кружка – список участников) и когда данные отдаёт сайт: почти все API, о которых следующий раздел, отвечают именно в JSON.
Запомни. CSV: первая строка – заголовок, записей на одну меньше, чем строк; запятых в строке на одну меньше, чем столбцов. JSON: {} – карточка с ключами, [] – список, счёт в списке с нуля.
5.4. Откуда берут данные и что такое API
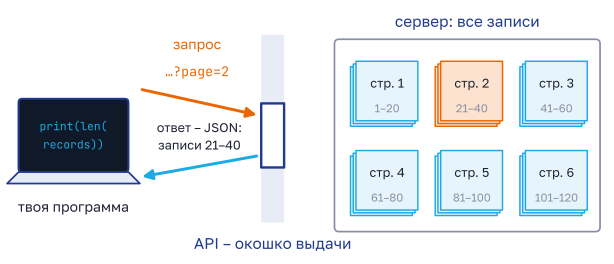
Все записи хранятся у сервера. Программа не заходит на склад сама – она подаёт запрос в окошко и получает порцию.
Прежде чем что-то считать, данные надо где-то взять. Источников несколько, и у каждого своя работа:
| Источник | Что даёт | Пример |
|---|---|---|
| Датчик | измеряет прямо сейчас и сколько угодно раз | термометр в теплице, шагомер в телефоне |
| Камера, спутник | снимки | снимок Обского моря из космоса, фото с телескопа |
| Человек | мнения и ответы, которые не измерит ни один прибор | опрос, анкета, голосование |
| Архив, открытые данные | то, что кто-то уже собрал за годы | погода за сто лет, численность населения |
| Сайт через API | свежие данные по запросу программы | каталог книг, расписание, курс валют |
Открытые данные – наборы, которые научные институты, государственные службы и проекты выкладывают для всех. Бесплатно – не значит надёжно. Перед тем как их брать, выясни, кто их выложил и когда последний раз обновлял, как их собирали, подходят ли они к твоему вопросу, нет ли в них больших пропусков и разрешено ли их использовать. И в работе всегда указывай, откуда взял данные.
API (программный интерфейс) – это «окошко выдачи» сайта, только не для людей, а для программ. Человек открывает страницу и читает глазами. Программа отправляет запрос – обращение по особому адресу – и получает ответ: данные, чаще всего в формате JSON. Адрес запроса выглядит примерно так (это адрес-образец, настоящего API там нет):
https://example.com/api/books?genre=фантастика&page=2До знака ? – сам адрес, куда обращаемся. После него – параметры, уточнения к запросу в виде имя=значение. Параметры разделяют знаком &. Здесь их два: жанр – фантастика, страница – вторая.
Зачем страница? Сервер не отдаёт тысячи записей за один раз: это долго и тяжело. Он выдаёт их постранично, порциями одного размера. Такой приём называют пагинацией. Если на странице 20 записей, то страница 1 – записи с 1-й по 20-ю, страница 2 – с 21-й по 40-ю, страница 3 – с 41-й по 60-ю. Правило для любой страницы с номером : она начинается с записи и заканчивается записью . Проверь на третьей: и .
Сколько страниц нужно скачать? Словами: всего записей делим на записи на одной странице и округляем вверх. Вверх – потому что остаток тоже лежит на странице, пусть и неполной. На последней странице записей обычно меньше:
Пример. 90 записей по 20 на странице: – значит, 5 страниц. Четыре полные – это записей, на пятой .
Скачивать страницы по одной руками никто не станет: это делает цикл. В Python запросы отправляют библиотекой requests (в Colab она уже есть). Вот заготовка программы:
import requests

url = "https://example.com/api/meteors"      # адрес-образец: подставь адрес из задачи
records = []                                  # сюда сложим записи со всех страниц
for page in range(1, 15):                     # страницы 1, 2, …, 14
    res = requests.get(url, params={"page": page}).json()
    records.extend(res["records"])            # добавить записи этой страницы в конец списка
print(len(records))
Разберём по строкам. records = [] – пустой список, копилка. range(1, 15) даёт номера от 1 до 14: последнее число в range не входит. Поэтому для 14 страниц пишут 15. requests.get(...) отправляет запрос, параметр page подставляется в адрес сам, а .json() превращает ответ в словари и списки Python. extend добавляет в копилку все записи страницы, а len(records) в конце показывает, сколько записей собрано.
Бывает, что сервер не говорит, сколько всего записей. Тогда страницы берут, пока не придёт пустая. Проверим этот способ без интернета: вместо сервера напишем функцию, которая ведёт себя так же. Эта программа запустится в любом онлайн- интерпретаторе:
VSEGO = 3380          # столько записей хранит «сервер»
NA_STRANICE = 250     # столько он отдаёт за один запрос

def get_page(page):
    """Притворяемся сервером: отдаём номера записей со страницы page."""
    first = (page - 1) * NA_STRANICE + 1
    last = min(page * NA_STRANICE, VSEGO)
    return list(range(first, last + 1))

records = []
page = 1
while True:                       # повторяем, пока не встретим break
    chunk = get_page(page)
    if len(chunk) == 0:           # пустая страница – записи кончились
        break
    records.extend(chunk)
    page = page + 1
print("страниц с данными:", page - 1)        # 14
print("записей собрано:", len(records))      # 3380
print("на последней:", len(get_page(14)))    # 130
В курсе сферы такую программу собирают из блоков в среде CodeChef (codechef.ru, блоки «HTTP», «Pandas», «Списки», «Переменные»; Scratch – другой, не курсовой инструмент). Алгоритм при этом тот же, что в коде выше. А алгоритм везде один: пустая копилка – цикл по страницам – запрос – добавить в копилку – после цикла сохранить всё в файл.
Запомни. Страниц = всего : на странице, с округлением вверх. На последней = всего − (страниц − 1) · на странице. В цикле range(1, N + 1): последнее число в range не входит.
Совет. Собрал данные – сверь итог: число записей в копилке должно совпасть с тем, сколько их на сервере. Не сошлось – ищи потерянную последнюю страницу или страницу, скачанную дважды.
5.5. Ошибки в данных и чистка
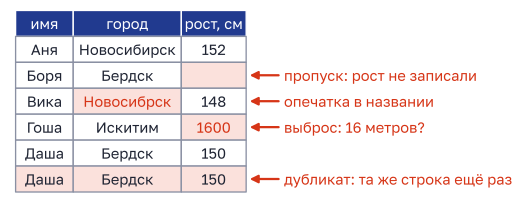
Каждая такая ошибка тихо портит итог. Прежде чем считать, таблицу чистят.
У программистов есть поговорка: «мусор на входе – мусор на выходе». Модель, обученная на грязной таблице, выучит грязь. Среднее, посчитанное по таблице с ошибкой, соврёт. Ошибки в данных бывают четырёх видов.
Пропуск – пустая клетка: значение не записали, датчик не ответил, человек пропустил вопрос анкеты. В файлах пропуск выглядит как пустое место, прочерк, null, None или NaN. Что делать: либо удалить строку, либо заполнить пропуск разумным значением – средним по столбцу, медианой или словом «неизвестно». Одно делать нельзя: молча поставить ноль. Снег 40 см, 50 см и пропуск: без пропуска среднее см, а с нулём см – будто снег растаял.
Дубликат – строка, повторённая дважды: ученик два раза нажал «Отправить», программа скачала одну страницу два раза. Лишнюю копию удаляют. Осторожно: две одинаковые покупки в магазине могут быть настоящими – человек купил два одинаковых пирожка. Если у записей есть номер (идентификатор), сверяй по нему.
Опечатки и разнобой – одно и то же записано по-разному: «Новосибирск», «новосибирск», «Новосибрск», «Новосибирск » с пробелом в конце. Человек видит один город, а компьютер – четыре разных: для него тексты равны, только если совпадает каждая буква, включая большие и маленькие и пробелы. Лечится так: убрать пробелы по краям, сделать все буквы маленькими и исправить опечатки по словарю.
goroda = ["Новосибирск", "новосибирск ", "Бердск", "Новосибрск", "бердск"]
ispravit = {"новосибрск": "новосибирск"}    # словарь опечаток: как написано → как правильно

chistye = []
for g in goroda:
    g = g.strip().lower()        # strip – убрать пробелы по краям, lower – все буквы маленькие
    g = ispravit.get(g, g)       # есть в словаре опечаток – заменить, нет – оставить как есть
    chistye.append(g)

print(chistye)                     # ['новосибирск', 'новосибирск', 'бердск', 'новосибирск', 'бердск']
print(len(set(goroda)), len(set(chistye)))   # 5 2 – было «пять городов», стало два
set(...) – это множество из главы 2: одинаковые значения в нём склеиваются. Поэтому len(set(...)) – число разных значений.
Выброс – значение, резко не похожее на остальные: рост ученика 1600 см, мороз −95° в Новосибирске. Выброс бывает ошибкой: лишний ноль, перепутанные единицы (1,6 м записали в столбец «см»), сбой датчика. А бывает правдой: рекордный прыжок, редкий мороз. Здравый смысл помогает поставить границу: самый высокий человек, рост которого измеряли врачи, – американец Роберт Уодлоу, 2 м 72 см. Значит, 1600 см – точно ошибка. В задачах правило обычно дано: «значения больше 200 считать ошибкой». Выброс сильно тянет за собой среднее, а медиану почти не трогает (справочник, раздел «Среднее, медиана и другие»).
Порядок чистки такой: сначала убрать дубликаты и привести тексты к одному виду, потом разобраться с пропусками и выбросами, и только потом считать. Если сначала посчитать, а потом чистить, считать придётся заново.
В Colab и Jupyter для таблиц есть библиотека pandas: там таблица называется DataFrame, а чистка занимает по строчке на шаг. Та же маленькая таблица с картинки:
import pandas as pd

df = pd.DataFrame({"имя":   ["Аня", "Боря", "Вика", "Гоша", "Даша", "Даша"],
                   "город": ["Новосибирск", "Бердск", "Новосибрск", "Искитим", "Бердск", "Бердск"],
                   "рост":  [152, None, 148, 1600, 150, 150]})

df = df.drop_duplicates()                    # убрать повторы строк: 6 → 5
df["город"] = df["город"].replace({"Новосибрск": "Новосибирск"})   # исправить опечатку
df = df.dropna()                             # убрать строки с пропусками: 5 → 4
df = df[df["рост"] < 250]                    # убрать выброс: 4 → 3
print(len(df), df["рост"].mean())            # 3 150.0
Запомни. Четыре беды: пропуск, дубликат, опечатка, выброс. Пропуск не превращай в ноль. Для компьютера «Бердск» и «бердск» – разные слова. Сначала чистка, потом подсчёт.
Совет. Перед подсчётом пробеги глазами по каждому столбцу: отсортируй его и посмотри на самые маленькие и самые большие значения. Выбросы и пустые клетки обычно собираются как раз по краям.
5.6. Фильтр, сортировка и подсчёт
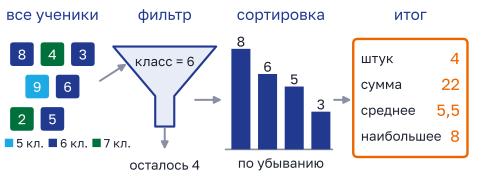
Из семи карточек фильтр «класс = 6» пропустил четыре. Их выстроили по убыванию и посчитали: сумма 22, среднее 5,5.
Почти любой вопрос к таблице собирается из трёх действий.
Фильтр оставляет только строки, для которых условие верно: «класс = 6», «снег больше 40 см», «жанр – фантастика». Условия можно соединять связками из главы 2: «фантастика и оценка не ниже 4,5». Остальные строки не удаляются навсегда – просто не участвуют в этом подсчёте.
Сортировка ставит строки по порядку одного столбца: по возрастанию (от меньшего к большему) или по убыванию. Тексты сортируются по алфавиту. «Три лучших», «топ-3» – это сортировка по убыванию и первые три строки. Если значения равны, нужно второе правило: «при равенстве – по алфавиту» или «по второму столбцу». Без него порядок одинаковых строк не определён.
Подсчёт сворачивает много строк в одно число. Основные подсчёты – те же, что в сервисах визуализации данных:
| Подсчёт | Что делает | Для ряда 8, 3, 6, 5 |
|---|---|---|
| количество | сколько непустых | 4 |
| сумма | складывает значения | 22 |
| среднее | сумма : количество | 5,5 |
| максимум, минимум | наибольшее и наименьшее | 8 и 3 |
| количество уникальных | сколько разных значений | 4 |
Количество работает с любым столбцом, даже с текстовым. В таблице без пропусков оно равно числу строк, а у столбца с пропусками – меньше: пустые клетки не считаются. Сумма и среднее – только с количественными.
Часто подсчёт делают по группам: «сколько часов в сумме у каждого кружка», «средняя оценка в каждом жанре». Строки раскладывают на кучки по значению одного столбца и считают в каждой кучке отдельно. Это называют группировкой.
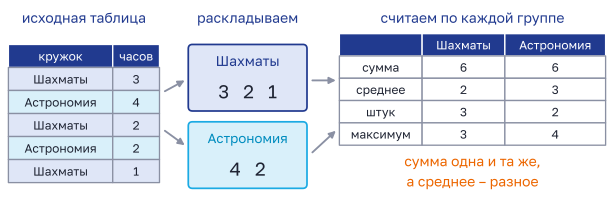
Посмотри на рисунок внимательно: сумма часов у кружков одинаковая, а среднее – разное. В шахматы ходят трое, в астрономию двое. Вопрос «где больше часов всего» и вопрос «где больше часов у одного ученика» – разные вопросы, и ответы на них могут не совпасть. Читай условие до слова, которое говорит, что считать.
Вручную всё это делают так: отметь галочкой строки, прошедшие фильтр; выпиши нужные значения столбиком; посчитай; проверь, что количество выписанных чисел совпадает с числом галочек.
В Python – тем же порядком. Таблицу удобно хранить как список словарей: каждая запись – карточка, как в JSON.
ucheniki = [
    {"имя": "Аня",  "класс": 6, "книг": 8},
    {"имя": "Боря", "класс": 7, "книг": 4},
    {"имя": "Вика", "класс": 6, "книг": 3},
    {"имя": "Гоша", "класс": 5, "книг": 9},
    {"имя": "Даша", "класс": 6, "книг": 6},
    {"имя": "Егор", "класс": 7, "книг": 2},
    {"имя": "Женя", "класс": 6, "книг": 5},
]

kolichestvo = 0
summa = 0
for u in ucheniki:
    if u["класс"] == 6:              # фильтр: только шестиклассники
        kolichestvo = kolichestvo + 1
        summa = summa + u["книг"]
print(kolichestvo, summa, summa / kolichestvo)    # 4 22 5.5

po_ubyvaniyu = sorted(ucheniki, key=lambda u: u["книг"], reverse=True)
for u in po_ubyvaniyu[:3]:           # [:3] – первые три
    print(u["имя"], u["книг"])       # Гоша 9, Аня 8, Даша 6
В sorted параметр key говорит, по какому столбцу сортировать: запись lambda u: u["книг"] читается как «для карточки u возьми число книг». reverse=True – по убыванию. Здесь сортировали всех учеников, без фильтра, поэтому первым стоит пятиклассник Гоша.
В pandas фильтр, сортировка и группировка пишутся ещё короче:
import pandas as pd

df = pd.DataFrame(ucheniki)
shestye = df[df["класс"] == 6]                            # фильтр
print(len(shestye), shestye["книг"].sum(), shestye["книг"].mean())   # 4 22 5.5
print(df.sort_values("книг", ascending=False).head(3))   # три лидера по книгам
print(df.groupby("класс")["книг"].sum())                 # по классам: 5 – 9, 6 – 22, 7 – 6
print(df["класс"].nunique())                             # 3 – разных классов
Запомни. Фильтр – оставить строки по условию, сортировка – расставить по столбцу, подсчёт – свернуть в число: количество, сумма, среднее, максимум, минимум, количество уникальных. «Сумма по группе» и «среднее по группе» – разные вопросы.
Совет. В Excel и похожих таблицах подсчёт по условию делают формулами: СЧЁТЕСЛИ – сколько строк подходит, СУММЕСЛИ – сумма по подходящим строкам, СРЗНАЧЕСЛИ – их среднее. Например, =СЧЁТЕСЛИ(B2:B8; 6) посчитает, сколько раз в клетках от B2 до B8 встречается 6. А кнопки «Сортировка» и «Фильтр» на панели сделают то же самое мышкой.
5.7. Разбираем задачи
Задача 5.1 Откуда взять данные
Шестиклассники из Кольцово готовят четыре проекта. Для каждого проекта выбери подходящий источник данных.
- Каждые 10 минут записывать температуру и влажность воздуха в школьной теплице.
- Узнать, в какие годы за последние полвека первый снег в Новосибирске выпал раньше 1 октября.
- Выяснить, в какие кружки хотели бы ходить шестиклассники школы.
- Посмотреть, какая часть Обского водохранилища покрыта льдом 1 декабря.
Источники: А – датчик; Б – снимки со спутника; В – архив метеонаблюдений; Г – опрос (анкета). Ответ запиши в виде «1А, 2…».
Дано: четыре проекта, четыре источника.
Найти: пары «проект – источник».
Шаг 1. Три вопроса к каждому проекту. Данные уже кто-то собрал или их надо измерить? Нужны сейчас или за прошлые годы? Их знают люди или показывают приборы?
Шаг 2. Проект 1. Температура и влажность прямо сейчас, и не один раз, а каждые 10 минут, днём и ночью. Человек так не просидит. Нужен прибор, который меряет сам, – датчик. 1А.
Шаг 3. Проект 2. Нужны прошлые 50 лет. Сегодня их не измеришь никаким прибором: можно только найти записи, которые метеостанции вели всё это время. Это архив. 2В.
Шаг 4. Проект 3. Кто в какой кружок хочет, не покажет ни один прибор – это знают только сами ребята. Надо их спросить – это опрос. 3Г.
Шаг 5. Проект 4. Водохранилище огромное, лёд надо увидеть сразу целиком, сверху. Это снимок со спутника. 4Б.
Все буквы в деле? А, Б, В, Г – каждая досталась своему проекту, ни одна не осталась лишней и не повторилась.
Ловушка в проекте 2. Рука тянется выбрать датчик: «там же про погоду». Датчик меряет только с той минуты, как его поставили. Про погоду 1980 года он ничего не знает. Прошлое – это всегда архив.
Ответ: 1А, 2В, 3Г, 4Б.
Своя задача по программе сферы, модуль 3
Реши сам
5.1. Сопоставь задачу и источник данных. Задачи: 1) сколько шагов в день делает ученик; 2) какие фильмы больше нравятся семиклассникам школы; 3) как менялось население Новосибирска за последние сто лет; 4) программа должна каждые 5 минут получать с сайта свежее расписание электричек. Источники: А – датчик в фитнес-браслете; Б – опрос; В – архив открытых данных статистики; Г – API сайта.
ответ5.2. Пятиклассники из Бердска готовят четыре проекта. Подбери каждому источник данных: 1) как менялась высота снега в Бердске каждую зиму за последние 30 лет; 2) сколько раз за учебный день открывается дверь в школьную столовую; 3) какие настольные игры хотели бы купить в класс сами ребята; 4) какая часть огромного поля за селом уже зазеленела весной – смотреть надо на всё поле сразу, сверху. Источники: А – снимки со спутника; Б – опрос; В – датчик на двери; Г – архив метеонаблюдений.
ответЗадача 5.2 Каталог школьной библиотеки
Вот две строки из каталога школьной библиотеки. Столбцов у каталога семь, поэтому таблицу повернули боком: имена столбцов идут сверху вниз, а каждая книга – это колонка.
| Столбец каталога | Первая книга | Вторая книга |
|---|---|---|
| Шифр | 1045 | 1046 |
| Название | Незнайка на Луне | Денискины рассказы |
| Автор | Н. Носов | В. Драгунский |
| Страниц | 336 | 160 |
| Цена, руб. | 420 | 350 |
| Есть электронная версия | да | нет |
| Дата поступления | 12.09.2025 | 03.10.2025 |
а) Определи тип каждого столбца: число, текст, да/нет или дата. б) Для каких столбцов имеет смысл сложить значения или найти среднее? Укажи, сколько таких столбцов.
Дано: семь столбцов каталога.
Найти: тип каждого столбца; количественные столбцы.
Шаг 1. Типы по виду значения. Цифрами записаны «Шифр», «Страниц», «Цена». Словами – «Название» и «Автор», это текст. «Есть электронная версия» принимает только два значения – да/нет. «Дата поступления» – дата.
Шаг 2. Проверка «есть ли смысл сложить». Страницы: средняя толщина книги в каталоге – разумный вопрос. Цена: сколько стоят все книги вместе – тоже. Это количественные столбцы.
Шаг 3. Шифр. Сложим шифры: . Что это? Ничего. Средний шифр 1045,5 – книги с таким шифром нет. Шифр – ярлык, как номерок в гардеробе, просто записан цифрами. Категориальный.
Шаг 4. Остальные. Складывать названия, авторов, «да» с «нет» или даты бессмысленно. Даты можно сравнивать – какая книга пришла раньше, – но не складывать.
Примета на будущее. У обоих количественных столбцов есть единица измерения – страницы и рубли. У шифра её нет.
Типичная ошибка. Записать «Шифр» в количественные, потому что там цифры. Цифры – не повод. Решает вопрос «имеет ли смысл средний шифр?», а он не имеет.
Ответ: а) число – «Шифр», «Страниц», «Цена»; текст – «Название», «Автор»; да/нет – «Есть электронная версия»; дата – «Дата поступления». б) Два столбца: «Страниц» и «Цена».
Своя задача по программе сферы, модуль 3
Реши сам
5.3. В наборе данных о погоде есть столбцы: «Дата», «Температура, °C», «Был снег» (да/нет), «Направление ветра» (С, Ю, З, В), «Скорость ветра, м/с», «Номер станции». Сколько из них количественных? Назови их.
ответ5.4. В столбце «Дата» записаны даты наблюдений: 15.09.2026, 03.11.2026, 20.10.2026, 28.09.2026. Программа отсортировала их командой sorted, как обычный текст. Какая дата окажется первой в списке? Какая из этих дат на самом деле самая ранняя?
Задача 5.3 Ответ метеостанции
У школьной метеостанции в Академгородке есть API. Программа отправила запрос и получила ответ, который сохранила в переменную res:
{
  "station": "Академгородок",
  "page": 1,
  "records": [
    {"date": "2026-01-10", "temp": -18.5, "snow": 42, "wind": 3},
    {"date": "2026-01-11", "temp": -24.0, "snow": 45, "wind": 1},
    {"date": "2026-01-12", "temp": -12.5, "snow": 51, "wind": 6},
    {"date": "2026-01-13", "temp": -9.0,  "snow": 50, "wind": 4}
  ]
}
Здесь temp – температура в °C, snow – высота снега в сантиметрах, wind – скорость ветра в м/с. а) Сколько записей о погоде в ответе? б) Что выведет команда print(res["records"][2]["snow"])? в) Найди среднюю температуру за эти дни. Ответ дай в °C с точностью до десятых.
Дано: ответ API в формате JSON.
Найти: число записей; значение по адресу ["records"][2]["snow"]; среднюю температуру.
Шаг 1. Где лежат записи. Сверху – карточка с тремя ключами: station, page, records. По ключу records лежит список в квадратных скобках. В нём четыре карточки в фигурных скобках – по одной на день. Записей 4.
Шаг 2. Идём по адресу. res["records"] – это список. [2] – карточка номер 2. Номера начинаются с нуля: [0] – 10 января, [1] – 11 января, [2] – 12 января. У этой карточки берём ключ snow – там 51.
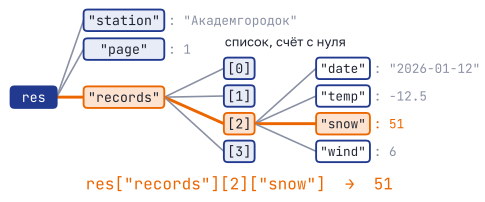
Шаг 3. Сумма температур. Все четыре числа отрицательные. Сложить отрицательные числа – всё равно что сложить морозы и поставить минус: . Сумма равна °C.
Шаг 4. Среднее. Делим на количество дней: °C.
Проверка кодом.
import json

text = """{"station": "Академгородок", "page": 1, "records": [
  {"date": "2026-01-10", "temp": -18.5, "snow": 42, "wind": 3},
  {"date": "2026-01-11", "temp": -24.0, "snow": 45, "wind": 1},
  {"date": "2026-01-12", "temp": -12.5, "snow": 51, "wind": 6},
  {"date": "2026-01-13", "temp": -9.0,  "snow": 50, "wind": 4}]}"""
res = json.loads(text)
print(len(res["records"]))           # 4
print(res["records"][2]["snow"])     # 51
temps = [r["temp"] for r in res["records"]]   # список всех температур
print(sum(temps) / len(temps))       # -16.0
Строка с temps собирает из каждой карточки r значение по ключу temp – получается список из четырёх чисел.
А на глаз? Среднее не может выскочить за края: −16 °C лежит между самым сильным морозом (−24) и самым слабым (−9). Для января под Новосибирском – обычная погода.
Где теряют баллы. На вопрос б) отвечают «45», посчитав [2] второй записью. В Python счёт в списке идёт с нуля, и [2] – это третья карточка. А в пункте в) теряют минус и пишут «16,0»: средний мороз 16 градусов – это −16 °C.
Ответ: а) 4; б) 51; в) −16,0 °C.
Своя задача по программе сферы, модуль 3
Реши сам
5.5. Что выведет программа?
data = {"club": "Юный астроном",
        "members": [{"name": "Лиза", "class": 6, "nights": 5},
                    {"name": "Марат", "class": 7, "nights": 8},
                    {"name": "Вера", "class": 5, "nights": 3}]}
print(data["members"][1]["name"])
print(len(data["members"]))5.6. Файл pogoda.csv открыли в Блокноте. В нём 31 строка, первая выглядит так: дата,температура,осадки,ветер. Сколько в файле записей о погоде? Сколько запятых в каждой строке?
Задача 5.4 Сколько страниц скачать
Каталог наблюдений метеоров обсерватории отдаёт данные через API постранично: по 250 записей на странице, страницы нумеруются с 1 (параметр page). Всего в каталоге 3380 записей.
а) Сколько страниц нужно скачать, чтобы собрать все записи? б) Сколько записей окажется на последней странице? в) Программа перебирает страницы циклом for page in range(1, ...). Какое число нужно поставить вместо многоточия?
Дано: всего 3380 записей; на странице 250; страницы с номера 1.
Найти: число страниц; записей на последней; второе число в range.
Шаг 1. Делим. . Значит, 13 страниц заполнены целиком, и ещё что-то осталось.
Шаг 2. Округляем вверх. 13 полных страниц – это записей. До 3380 не хватает, остаток лежит на 14-й странице. Страниц 14.
Шаг 3. Последняя страница. записей. Проверка: – все записи на месте.
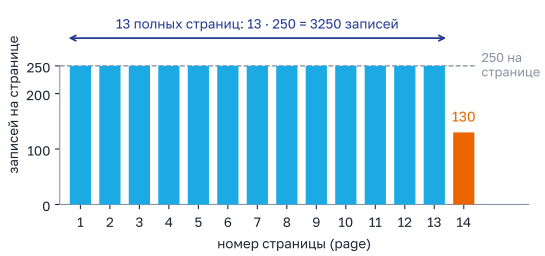
Шаг 4. Граница цикла. range(1, N) выдаёт числа от 1 до – последнее число не входит. Нам нужны страницы с 1-й по 14-ю, значит, : range(1, 15).
Проверка кодом. Сервер заменим функцией, которая отдаёт по 250 номеров записей:
import math

VSEGO, NA_STRANICE = 3380, 250
stranic = math.ceil(VSEGO / NA_STRANICE)          # ceil – округление вверх
print(stranic)                                     # 14
print(VSEGO - (stranic - 1) * NA_STRANICE)         # 130

def get_page(page):
    first = (page - 1) * NA_STRANICE + 1
    last = min(page * NA_STRANICE, VSEGO)
    return list(range(first, last + 1))

records = []
for page in range(1, 15):
    records.extend(get_page(page))
print(len(records))                                # 3380 – собрали всё
Прикинем. 14 страниц по 250 вместили бы 3500 записей – чуть больше, чем есть. А 13 страниц – 3250, меньше, чем есть. Значит, 14 – в самый раз.
Типичная ошибка. Округлять «по правилам», до ближайшего. Здесь это случайно сработало: 13,52 → 14. Но при 3310 записях , по правилам выйдет 13 страниц, и 60 записей с 14-й страницы потеряются. Страницы округляют только вверх. И с циклом легко промахнуться на единицу: написать range(1, 14) – и последняя страница останется на сервере.
Ответ: а) 14 страниц; б) 130 записей; в) 15.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Сбор данных»
Реши сам
5.7. API отдаёт по 400 записей на странице, всего записей 5270. Сколько страниц нужно скачать и сколько записей будет на последней?
ответ5.8. Программа отправляет запрос https://example.com/api/meteors?year=2025&month=8&page=3. а) Сколько параметров в этом запросе? б) На каждой странице 50 записей, страницы нумеруются с 1. С какой по какую запись вернёт этот запрос?
5.9.* В каталоге 2350 записей, API отдаёт их по 200 на странице, страницы нумеруются с 1. Программист написал цикл for page in range(1, 12): и скачал все страницы, которые этот цикл перебирает. Сколько записей он соберёт и сколько потеряет?
Задача 5.5 Чистим журнал снега
Школьная метеостанция записывает высоту снега каждое утро. За первые дни декабря в журнале вот что:
| Дата | Снег, см |
|---|---|
| 01.12 | 38 |
| 02.12 | 41 |
| 03.12 | |
| 04.12 | 44 |
| 04.12 | 44 |
| 05.12 | 470 |
| 06.12 | 47 |
| 07.12 | 46 |
| 08.12 | 52 |
| 09.12 | 50 |
Почисти журнал по правилам: 1) повторяющиеся строки оставить по одной; 2) строки с пропуском удалить; 3) значения больше 200 см – ошибка прибора, такие строки удалить. Найди среднюю высоту снега по оставшимся строкам. Ответ дай в сантиметрах, округли до десятых.
Дано: 10 записей; три правила чистки.
Найти: среднюю высоту снега после чистки, см.
Шаг 1. Дубликаты. Запись «04.12 – 44» встречается два раза. Оставляем одну. Было 10 записей, стало 9.
Шаг 2. Пропуски. 3 декабря клетка пустая – удаляем строку. Осталось 8.
Шаг 3. Выбросы. 470 см больше 200 – удаляем. Скорее всего, наблюдатель приписал лишний ноль, а было 47. Но правило велит удалить, и мы не гадаем. Осталось 7 записей: 38, 41, 44, 47, 46, 52, 50.
Шаг 4. Сумма. см.
Шаг 5. Среднее. Округляем до десятых: 45,4 см.
Проверка кодом.
zhurnal = [("01.12", 38), ("02.12", 41), ("03.12", None), ("04.12", 44), ("04.12", 44),
           ("05.12", 470), ("06.12", 47), ("07.12", 46), ("08.12", 52), ("09.12", 50)]

bez_povtorov = []
for zapis in zhurnal:
    if zapis not in bez_povtorov:          # такой строки ещё не было – берём
        bez_povtorov.append(zapis)

chistye = []
for data, sneg in bez_povtorov:
    if sneg is not None and sneg <= 200:   # нет пропуска и нет выброса
        chistye.append(sneg)

print(len(chistye), sum(chistye), round(sum(chistye) / len(chistye), 1))   # 7 318 45.4
Пустую клетку в Python записывают словом None – «ничего». Условие sneg is not None пропускает только строки, где значение есть.
Прикидка. Чистые значения лежат между 38 и 52 см, и 45,4 – примерно посередине. Снег за неделю подрос на полтора десятка сантиметров – обычное начало сибирской зимы.
Коварство этой задачи в том, что каждое пропущенное правило даёт свой неверный ответ, и все они выглядят правдоподобно. Забыл убрать повтор – 45,3 см. Поставил вместо пропуска ноль – 39,8 см. Оставил выброс – 98,5 см. Вот почему чистку делают по списку, отмечая каждое правило.
Ответ: 45,4 см.
Своя задача по программе сферы, модули 3 и 4
Реши сам
5.10. Ученик засекал, сколько минут уходит у него на одну задачу: 12, 15, 11, 14, 13 и 95 (над последней он отвлёкся на обед и не выключил секундомер). На сколько минут уменьшится среднее время, если убрать выброс 95? Округли до десятых.
ответ5.11.* В таблице ответов на анкету 40 строк. Четыре из них – точные копии других строк: кто-то нажал «Отправить» дважды. Ещё в 5 строках не заполнено поле «Класс». Подвох: один ученик с пустым «Классом» отправил анкету два раза, поэтому среди этих пяти строк есть и его ответ, и копия ответа. Сколько строк останется, если сначала удалить копии, а потом строки с пропусками?
ответ5.12. В таблице 2450 строк с записями (строку заголовка не считаем) и 12 столбцов. Сколько в ней клеток со значениями? Сколько клеток останется, если удалить 3 столбца-идентификатора и 50 строк-дубликатов?
ответЗадача 5.6 Фантастика месяца
Библиотекарь хочет выставить на полку «Фантастика месяца» три фантастические книги. Вот данные из электронного каталога («Прочитали» – сколько читателей брали книгу за год, «Оценка» – средняя оценка читателей):
| Шифр | Название | Жанр | Оценка | Прочитали |
|---|---|---|---|---|
| 101 | Незнайка на Луне | сказка | 4,7 | 58 |
| 102 | Приключения Электроника | фантастика | 4,6 | 64 |
| 103 | Сто лет тому вперёд | фантастика | 4,8 | 71 |
| 104 | Тимур и его команда | повесть | 4,3 | 40 |
| 105 | Голова профессора Доуэля | фантастика | 4,5 | 33 |
| 106 | Денискины рассказы | рассказы | 4,9 | 90 |
| 107 | Малыш и Карлсон | сказка | 4,8 | 77 |
| 108 | Понедельник начинается в субботу | фантастика | 4,7 | 52 |
| 109 | Остров сокровищ | приключения | 4,6 | 66 |
| 110 | Человек-амфибия | фантастика | 4,4 | 68 |
а) Выбери три фантастические книги, которые читали чаще всего. Запиши их шифры по убыванию числа прочтений. б) Какие три фантастические книги получили самую высокую оценку? Шифры – по убыванию оценки. в) Какие книги попали в обе тройки?
Дано: таблица из 10 книг.
Найти: две тройки шифров и их общие книги.
Шаг 1. Фильтр. Оставляем только строки с жанром «фантастика». Это 102, 103, 105, 108, 110 – пять книг. Остальные пять в этой задаче не участвуют.
Шаг 2. Сортировка по прочтениям. Выписываем у пяти книг столбец «Прочитали» и ставим по убыванию: 71 (103), 68 (110), 64 (102), 52 (108), 33 (105). Первые три: 103, 110, 102.
Шаг 3. Сортировка по оценке. Оценки: 4,8 (103), 4,7 (108), 4,6 (102), 4,5 (105), 4,4 (110). Первые три: 103, 108, 102.
Шаг 4. Общие. В обеих тройках есть 103 и 102. Книга 110 популярна, но оценка у неё самая низкая среди фантастики. У книги 108 наоборот.
Проверка кодом (нужна библиотека pandas – в Colab она уже есть):
import pandas as pd

knigi = pd.DataFrame({
    "шифр":      [101, 102, 103, 104, 105, 106, 107, 108, 109, 110],
    "жанр":      ["сказка", "фантастика", "фантастика", "повесть", "фантастика",
                  "рассказы", "сказка", "фантастика", "приключения", "фантастика"],
    "оценка":    [4.7, 4.6, 4.8, 4.3, 4.5, 4.9, 4.8, 4.7, 4.6, 4.4],
    "прочитали": [58, 64, 71, 40, 33, 90, 77, 52, 66, 68]})

fant = knigi[knigi["жанр"] == "фантастика"]                       # фильтр
top_chit = fant.sort_values("прочитали", ascending=False).head(3)["шифр"].tolist()
top_ocen = fant.sort_values("оценка", ascending=False).head(3)["шифр"].tolist()
print(top_chit)                        # [103, 110, 102]
print(top_ocen)                        # [103, 108, 102]
print(set(top_chit) & set(top_ocen))   # {102, 103} – пересечение, как в главе 2
Сверимся с условием. Все шесть шифров в ответе – из списка фантастики, и в каждой тройке значения идут по убыванию.
Самая обидная ошибка – забыть про фильтр и отсортировать всю таблицу: получится 106, 107, 103 – самые читаемые книги вообще, но две из них не фантастика. Если на отборе ответ не принят, первым делом проверь, применил ли ты все условия из задания: жанр, возраст, год.
Ответ: а) 103, 110, 102; б) 103, 108, 102; в) 103 и 102.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Лучшие книги»
Реши сам
5.13. Итоги тренировки по решению задач:
| Имя | Класс | Решено задач |
|---|---|---|
| Катя | 6 | 7 |
| Лёва | 5 | 3 |
| Маша | 6 | 4 |
| Нина | 7 | 9 |
| Олег | 6 | 5 |
| Паша | 6 | 8 |
| Рита | 5 | 6 |
| Саша | 7 | 2 |
Сколько задач в среднем решил один шестиклассник? Сколько шестиклассников решили больше 5 задач?
ответ5.14. Шесть команд запускали водяные ракеты. Высота полёта: А – 34 м, Б – 41 м, В – 29 м, Г – 41 м, Д – 38 м, Е – 27 м. Команды расставили по убыванию высоты, а при равной высоте – по алфавиту. Какая команда оказалась на третьем месте?
ответЗадача 5.7* Кружки: сначала порядок, потом подсчёт
Школа собрала через онлайн-форму записи в кружки. Название кружка каждый вписывал сам:
| Кружок | Часов в неделю |
|---|---|
| Робототехника | 4 |
| робототехника | 2 |
| Шахматы | 3 |
| Роботехника | 4 |
| шахматы | 2 |
| Астрономия | 3 |
| Шахматы | 2 |
| астрономия | 2 |
| Робототехника | 3 |
| Астрономия | 4 |
| ШАХМАТЫ | 1 |
| Астрономия | 3 |
а) Программа построила по этой таблице, ничего не исправляя, столбчатую диаграмму «сумма часов по кружкам». Сколько столбиков на ней будет и какой кружок выйдет в лидеры? б) Приведи названия к одному виду («Роботехника» – опечатка в слове «Робототехника»). Какой кружок набирает больше всего часов в сумме и сколько? в) Сколько в среднем часов в неделю у одного записавшегося в этот кружок?
Дано: 12 записей, названия кружков написаны вразнобой.
Найти: число столбиков и лидера до чистки; лидера и его сумму после чистки; среднее у лидера.
Шаг 1. Как видит таблицу программа. Для компьютера два текста одинаковые, только если совпадает каждая буква, в том числе большая или маленькая. Выписываем разные написания: «Робототехника», «робототехника», «Роботехника», «Шахматы», «шахматы», «ШАХМАТЫ», «Астрономия», «астрономия». Их 8 – на диаграмме будет 8 столбиков.
Шаг 2. Лидер до чистки. Считаем сумму часов для каждого написания отдельно:
| Написание | Сколько записей | Сумма часов |
|---|---|---|
| Робототехника | 2 | |
| робототехника | 1 | 2 |
| Роботехника | 1 | 4 |
| Шахматы | 2 | |
| шахматы | 1 | 2 |
| ШАХМАТЫ | 1 | 1 |
| Астрономия | 3 | |
| астрономия | 1 | 2 |
Самый высокий столбик – «Астрономия», 10 часов.
Шаг 3. Наводим порядок. Все буквы делаем маленькими, опечатку «роботехника» заменяем на «робототехника». Остаются три кружка.
Шаг 4. Считаем по группам.
- робототехника – 4 записи: ч;
- шахматы – 4 записи: ч;
- астрономия – 4 записи: ч.
Лидер – робототехника, 13 часов. До чистки он даже не был виден: его часы рассыпались по трём разным столбикам.
Шаг 5. Среднее у лидера. В робототехнику записались 4 человека: ч в неделю.
Проверка. Всего часов в таблице: . По группам: – ни одна строка не потерялась. И строк по группам , сколько и было.
Проверка кодом.
zapisi = [("Робототехника", 4), ("робототехника", 2), ("Шахматы", 3), ("Роботехника", 4),
          ("шахматы", 2), ("Астрономия", 3), ("Шахматы", 2), ("астрономия", 2),
          ("Робототехника", 3), ("Астрономия", 4), ("ШАХМАТЫ", 1), ("Астрономия", 3)]

syroe = {}                                   # сумма часов по написанию «как есть»
for kruzhok, chasy in zapisi:
    syroe[kruzhok] = syroe.get(kruzhok, 0) + chasy
print(len(syroe), max(syroe, key=syroe.get))  # 8 Астрономия

ispravit = {"роботехника": "робототехника"}
summa, kolvo = {}, {}
for kruzhok, chasy in zapisi:
    k = kruzhok.strip().lower()
    k = ispravit.get(k, k)
    summa[k] = summa.get(k, 0) + chasy
    kolvo[k] = kolvo.get(k, 0) + 1
print(summa)                                 # {'робототехника': 13, 'шахматы': 8, 'астрономия': 12}
lider = max(summa, key=summa.get)
print(lider, summa[lider], summa[lider] / kolvo[lider])   # робототехника 13 3.25
Словарь summa работает как ряд копилок, подписанных названиями кружков. summa.get(k, 0) – «сколько уже лежит в копилке k, а если её ещё нет – ноль». max(summa, key=summa.get) находит ключ с самым большим значением.
Откуда такое среднее? Людей в каждом кружке поровну, по четыре, поэтому лидер по сумме часов – тот, где ходят дольше. У робототехники записи от 2 до 4 часов, и 3,25 ч попадает между ними.
Типичная ошибка. Поверить диаграмме, построенной по грязной таблице, и ответить «Астрономия». Прежде чем читать любую диаграмму или сумму, посмотри на список разных значений в столбце: если одно слово встречается в трёх написаниях, сначала чистка. Ещё одна ловушка – посчитать количество записей вместо суммы часов: у всех трёх кружков по 4 записи, и лидера так не найти.
Ответ: а) 8 столбиков, лидер «Астрономия» (10 ч); б) робототехника, 13 ч; в) 3,25 ч.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Описательная статистика и анализ возрастных ограничений»
Реши сам
5.15.* Продажи на школьной ярмарке записывали от руки:
| Товар | Продано, шт. |
|---|---|
| Чай | 12 |
| Пирожок | 15 |
| чай | 8 |
| Блины | 9 |
| блины | 6 |
| ЧАЙ | 5 |
| Пирожок | 7 |
| Блины | 10 |
| пирожок | 4 |
| Чай | 3 |
а) Какой товар выйдет в лидеры по сумме проданных штук, если считать по таблице как есть, не исправляя написание? Сколько штук у него? б) Какой товар на самом деле продали больше всего и сколько?
ответ5.16.* Классы сдавали макулатуру, и каждый вписывал свой класс в форму сам:
| Класс | Сдано, кг |
|---|---|
| 6А | 12 |
| 6а | 8 |
| 7Б | 15 |
| 6 А | 10 |
| 7б | 9 |
| 5В | 14 |
| 7Б | 11 |
| 5в | 16 |
| 6А | 7 |
| 5В | 13 |
| 6а | 9 |
а) Сколько разных классов насчитает программа, если ничего не исправлять? б) Приведи записи к одному виду. Какой класс сдал больше всего макулатуры в сумме и сколько? в) У какого класса больше всего килограммов в среднем на одну сдачу? Округли до десятых.
ответГрафики и анализ данных
Таблица на сто строк молчит, пока её не превратишь в картинку. Один взгляд на график – и видно, где максимум, куда всё растёт и есть ли вообще то, что ты ищешь. В этой главе мы учимся выбирать график под вопрос, читать его без ошибок, считать среднее и медиану, проверять догадки и замечать графики, которые обманывают. На отборе такие задачи выглядят так: дан график или таблица, нужно ввести число, выбрать верные выводы из списка или сопоставить ситуацию и вид диаграммы.
6.1. Четыре главных графика и когда какой
Сначала реши, какой у тебя вопрос. Вид графика выбирают под вопрос, а не под настроение.
Визуализация – это превращение чисел в картинку: столбики, линии, точки, дольки. Слова «график» и «диаграмма» в жизни значат почти одно и то же, путать их не страшно. Видов графиков десятки, но почти любую школьную задачу закрывают четыре.
Столбчатая диаграмма сравнивает величины между собой. Сколько макулатуры собрал каждый класс, сколько книг прочитал каждый друг, в каком кружке больше всего ребят. Каждому предмету сравнения – свой столбик, и чем выше столбик, тем больше число. Порядок столбиков не важен, их можно даже отсортировать по высоте.
Линейный график показывает, как величина меняется со временем. По горизонтали – дни, месяцы, годы, по вертикали – то, что мерили: температуру, число подписчиков, рост тыквы на даче. Соседние точки соединяют линией, потому что между ними время шло без перерыва. Линия вверх – величина растёт, вниз – падает, чем круче линия – тем быстрее.
Круговая диаграмма показывает, какую долю от целого занимает каждая часть. Весь круг – это все 100 %: все ученики школы, весь бюджет, все дни месяца. Долька в четверть круга – 25 %. Круговая годится, только когда части вместе и правда составляют одно целое и не пересекаются. Если в опросе можно было отметить несколько ответов, проценты в сумме выйдут больше 100, и круга из них не сложить – тогда рисуют столбики.
Точечная диаграмма (её ещё называют диаграммой рассеяния) показывает, связаны ли две величины. Каждая точка – один объект: ученик, день, книга. По горизонтали откладывают одну его величину, по вертикали – другую. Если точки вытягиваются в полосу, идущую вверх, – чем больше одно, тем больше и другое. Если полоса идёт вниз – чем больше одно, тем меньше другое. Если точки рассыпаны кашей, связи не видно.
| Вопрос | Какой график | Пример |
|---|---|---|
| Кто больше, кто меньше? | столбчатая | макулатура по классам |
| Как менялось со временем? | линейный | температура по месяцам |
| Какая доля от целого? | круговая | как ученики добираются до школы |
| Связаны ли две величины? | точечная | рост и размер обуви у 30 ребят |
Запомни. Сравнить – столбики. Время – линия. Доли одного целого – круг. Две величины у каждого объекта – точки.
Совет. Проверка для круговой диаграммы: сложи все проценты. Вышло ровно 100 % – круг можно рисовать. Больше 100 % – ответы пересекались, и нужны столбики.
6.2. Как читать график: оси, единицы, масштаб
Подписана не каждая чёрточка, а только каждая пятая. Сколько градусов в одном промежутке между чёрточками, считаем сами: разницу подписей делим на число промежутков.
Прежде чем смотреть на линии и столбики, прочитай подписи. Это занимает десять секунд и спасает от половины ошибок. Порядок всегда один.
- Название. Про что график? Где и когда собраны данные?
- Горизонтальная ось (её называют осью X). Что на ней: месяцы, дни, классы, температура?
- Вертикальная ось (ось Y). Что на ней и в каких единицах: градусы, минуты, тысячи просмотров, проценты. «Просмотры, тысяч» и число 30 означают 30 000 просмотров, а не 30.
- Масштаб. С какого числа начинается ось и сколько стоит одно деление.
Промежуток между соседними чёрточками называют делением, а сколько он стоит – ценой деления. Находят её так же, как на градуснике с рисунка: возьми две соседние подписи, вычти меньшую из большей и раздели на число делений между ними. На градуснике подписи −20 и −10, между ними 5 делений: градуса. Если на оси подписаны 0, 20, 40, а между подписями по 4 деления, то цена деления .
Теперь настоящий график. Ниже – средняя температура в Новосибирске по месяцам. Данные условные, округлены до целых, но похожи на то, что показывают метеостанции.
Как найти по графику значение: найди нужный месяц на горизонтальной оси, поднимись (или опустись) до точки, от точки иди влево к вертикальной оси. Для июля это 19 °C, для ноября −7 °C. Отсюда многое видно без единого вычисления:
- самый тёплый месяц – июль, это самая высокая точка;
- ниже нуля средняя температура держится пять месяцев: январь, февраль, март, ноябрь и декабрь;
- осенью линия идёт вниз, и чем она круче, тем быстрее холодает.
Насколько изменилась температура, считают так: «стало минус было». С октября по ноябрь было 2, стало −7: . Минус в ответе значит «стало холоднее», на 9 градусов. С отрицательным «было» аккуратнее. С февраля по март было −15, стало −8: , потеплело на 7 градусов. Вычесть отрицательное число – всё равно что прибавить его без минуса. Проверь по числовой прямой: от −15 до −8 ровно 7 шагов.
Графики удобно строить в Python. Библиотека matplotlib в Colab и Jupyter уже установлена, в простом онлайн-интерпретаторе её может не быть.
import matplotlib.pyplot as plt

mesyacy = ["янв", "фев", "мар", "апр", "май", "июн",
           "июл", "авг", "сен", "окт", "ноя", "дек"]
temp = [-17, -15, -8, 2, 10, 17, 19, 16, 10, 2, -7, -14]

plt.plot(mesyacy, temp, marker="o")      # линия с кружками в точках
plt.axhline(0, color="gray")              # линия нуля
plt.title("Новосибирск: средняя температура (данные условные)")
plt.xlabel("месяц")
plt.ylabel("температура, °C")
plt.show()
Построчно. Первая строка подключает библиотеку графиков и даёт ей короткое имя plt. Дальше два списка – наборы значений в квадратных скобках: подписи месяцев и температуры, по одной на месяц, в том же порядке. plt.plot рисует линию: первым идёт то, что по горизонтали, вторым – то, что по вертикали; marker="o" ставит кружок в каждой точке. plt.axhline(0) проводит горизонтальную линию на нуле. Три следующие строки пишут название и подписи осей, а plt.show() показывает картинку. Для столбиков вместо plt.plot пишут plt.bar, для точек – plt.scatter, для круга – plt.pie.
Запомни. Сначала подписи, потом картинка: что по осям, в каких единицах, с какого числа начинается ось. Цена деления – разница соседних подписей, делённая на число промежутков между ними.
Совет. Если на оси написано «тыс.», «млн» или «%», запиши это рядом с ответом ещё до вычислений. Ответ «30» вместо «30 000» – одна из самых обидных потерь баллов.
6.3. Числа-сводки: среднее, медиана, минимум, максимум, размах
Возьми лишние кубики с высоких столбиков и отдай низким. Когда все сравнялись, их высота и есть среднее.
Когда чисел много, их хочется описать одним-двумя числами. В этой книге такие числа мы зовём сводками, в учебнике статистики – числовыми характеристиками. Главных пять.
- Минимум – самое маленькое значение, максимум – самое большое.
- Размах – насколько далеко разбежались значения: максимум минус минимум.
- Среднее арифметическое, или просто среднее, – сумма всех значений, делённая на их количество. Это та самая высота разровненных столбиков: .
- Медиана – число, которое стоит посередине, если выстроить все значения по возрастанию. Половина значений не больше медианы, половина – не меньше.
Разберём на примере. Семь ребят решали одну задачу и записали, сколько минут у каждого ушло: 9, 4, 12, 30, 6, 10, 7.
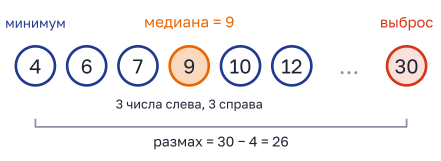
Шаг 1. Выстраиваем по возрастанию: 4, 6, 7, 9, 10, 12, 30. Без этого шага медиану не найти – это первое, что забывают.
Шаг 2. Минимум и максимум: 4 и 30 мин. Размах: мин.
Шаг 3. Среднее. Сумма , чисел 7, среднее мин (округлили до десятых).
Шаг 4. Медиана. Чисел 7 – нечётное количество, посередине стоит четвёртое: слева три числа, справа три. Медиана – 9 мин.
Если чисел чётное количество, посередине оказываются два числа. Тогда медиана – их среднее. Для 4, 6, 7, 9, 10, 12 середина – между 7 и 9, медиана .
А теперь сравни. Среднее 11,1 мин больше, чем у пятерых ребят из семи. Кто-то один задумался на 30 минут (может, отвлёкся на телефон) – и утащил среднее вверх. Такое значение, резко не похожее на остальные, называют выбросом. Выброс сильно тянет за собой среднее и почти не трогает медиану. Убери 30 из ряда – среднее упадёт до мин, а медиана сдвинется совсем чуть-чуть: с 9 до . Поэтому, когда в данных есть выбросы, честнее смотреть на медиану. Так поступают, например, когда рассказывают о зарплатах: пара миллионеров в посёлке сильно поднимает среднюю зарплату, а медиану почти не меняет.
Посчитаем всё это программой. Здесь хватит самого простого онлайн-интерпретатора Python.
minuty = [4, 6, 7, 9, 10, 12, 30]

srednee = sum(minuty) / len(minuty)
po_poryadku = sorted(minuty)
n = len(po_poryadku)
if n % 2 == 1:
    mediana = po_poryadku[n // 2]
else:
    mediana = (po_poryadku[n // 2 - 1] + po_poryadku[n // 2]) / 2

print(round(srednee, 1))              # 11.1
print(mediana)                        # 9
print(max(minuty) - min(minuty))      # 26
sum складывает все числа списка, len считает, сколько их. sorted выстраивает числа по возрастанию. n % 2 – остаток от деления на 2: если он равен 1, чисел нечётное количество. if … else читается как «если …, иначе …»: строка под if выполнится при нечётном количестве, строка под else – при чётном. n // 2 – деление без остатка: для получится 3. Номер 3 в Python – это четвёртое число, потому что счёт номеров идёт с нуля. При чётном количестве берём два средних числа и находим их среднее. max и min дают максимум и минимум, round(…, 1) округляет до десятых, print выводит результат на экран. После # идёт комментарий – Python его не читает, это заметка для человека.
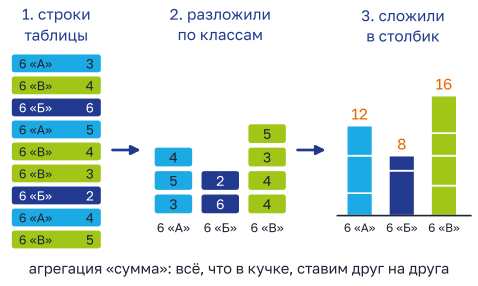
В таблице одна строка – один ученик. На диаграмме один столбик – целый класс. Между ними стоит правило, по которому кучка чисел становится одним числом.
Сводки по группам. В разделе 5.6 мы уже раскладывали строки таблицы на кучки и считали в каждой сумму, среднее, максимум. В сервисах для графиков такой подсчёт по группам называют агрегацией. Когда по таблице строят столбчатую диаграмму, выбирают три вещи: какое поле пойдёт по горизонтали (например, класс), какое по вертикали (прочитанные книги) и какую агрегацию применить. Высота столбика – результат агрегации для своей группы. На рисунке выбрана «сумма», и выше всех 6 «В». Возьми «среднее» – и все три столбика станут одинаковыми: , , . Данные те же, а картинка совсем другая. Как выглядят эти настройки в Датавиз-конструкторе, покажут на курсе сферы, а смысл у них тот же.
Запомни. Медиана – середина упорядоченного ряда; при чётном количестве – среднее двух средних. Выброс тянет среднее и почти не трогает медиану. Сумма, среднее, максимум по группам – разные вопросы и разные ответы.
Совет. Проверь среднее на разумность: оно всегда лежит между минимумом и максимумом. Вышло среднее больше максимума – ошибка в сумме или в количестве.
6.4. Гипотеза: проверяем догадку графиком
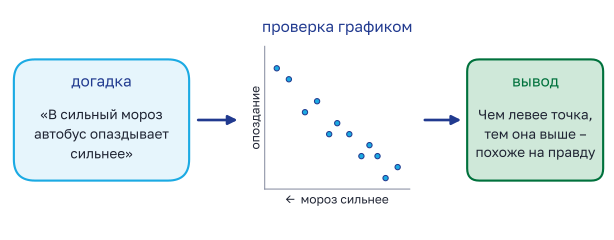
Догадку не принимают на веру и не отбрасывают на глаз: строят по данным график и смотрят, согласен ли он с ней.
Гипотеза – предположение, которое можно проверить данными. «Зимой в библиотеке берут больше книг, чем летом». «Чем дольше ребята сидят вечером в телефоне, тем позже засыпают». Хорошая гипотеза говорит конкретно, что с чем связано, и её можно проверить таблицей. «Погода влияет на жизнь» – не гипотеза: непонятно, что мерить.
Сначала решают, какие две величины сравнивать. Потом собирают таблицу, где у каждого объекта (дня, ученика) есть обе величины. По ней строят подходящий график: связь двух величин – точечная диаграмма, сравнение групп – столбчатая, изменение во времени – линейный. И уже глядя на график, честно говорят: подтверждает он догадку, опровергает или по этим данным сказать нельзя.
Пример. Школьник из Бердска две зимы подряд записывал утреннюю температуру и на сколько минут опоздал школьный автобус. Гипотеза: в сильный мороз автобус опаздывает сильнее.
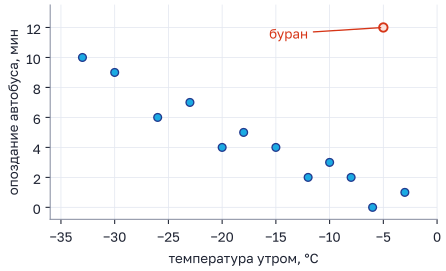
Точки вытянулись полосой из левого верхнего угла в правый нижний. Левее – значит холоднее, выше – значит дольше опоздание. В утра от −25 °C и холоднее автобус опаздывал на 6–10 минут, в утра от −10 °C и теплее (кроме одного) – на 0–3 минуты. Гипотеза подтверждается. Одна точка выбивается: −5 °C и 12 минут. Это утро бурана – дорогу замело. Выброс не отменяет вывод, но подсказывает, что на опоздание влияет не только мороз.
Но радоваться рано: у такого вывода есть два слабых места.
- Мало данных – слабый вывод. По трём точкам можно «увидеть» что угодно. Чем больше точек, тем больше доверия.
- Связь – ещё не причина. Летом на Обском море в дни, когда продают больше мороженого, больше людей и обгорает на солнце. Мороженое тут ни при чём: обе величины растут в жаркие солнечные дни. График показывает, что две величины меняются вместе, но не говорит, какая из них «виновата». В нашем примере причина правдоподобна – в мороз хуже заводятся моторы и скользко, – но это знание о жизни, а не о графике.
Запомни. Гипотеза – конкретная догадка, которую можно проверить таблицей. Точки полосой вверх или вниз – связь есть, кашей – не видно. Связь не доказывает, что одно вызывает другое.
6.5. Обманчивые графики
Слева ось начинается с нуля, и видно: классы собрали почти поровну. Справа низ оси отрезали – и второй столбик выглядит втрое выше первого.
График можно нарисовать так, что все числа на нём верные, а впечатление – ложное. Иногда это делают нечаянно, иногда – нарочно, в рекламе. Приёмы у таких графиков одни и те же.
Обрезанная ось. Вертикальная ось столбчатой диаграммы начинается не с нуля, а с числа поближе к данным. Тогда столбики сравнивают только «верхушки». На рисунке 48 и 52 кг, ось от 46: видимые столбики – и делений. Кажется, что второй класс собрал в раза больше. А по числам – в раза, то есть всего на 8 % больше. У линейного графика ось часто начинают не с нуля, и обмана тут нет: там важна форма линии, а не высота. А вот столбики без нуля внизу почти всегда вводят в заблуждение.
Неровный шаг. На оси времени подписаны 2020, 2021, 2022, 2025 – между последними двумя прошло три года, а расстояние такое же. Линия после 2022 года будто взлетает круче, чем на самом деле.
Нет единиц или подписи оси. «Выросло до 40» – сорок чего? Процентов, тысяч, штук? Без подписи график ничего не доказывает.
Круг, который не круг. Круговая диаграмма, где доли в сумме дают 130 %, или трёхмерный наклонённый круг, где передняя долька кажется больше, чем она есть.
Выбранный кусочек. Показали только те месяцы, где линия идёт вверх, а остальные «забыли».
Запомни. Перед сравнением столбиков посмотри, с какого числа начинается ось. Сравнивай сами числа, а не высоту картинки: во сколько раз – делением, на сколько процентов – от того значения, с которым сравниваешь.
6.6. Дашборд и вычислительное эссе
Водитель не листает отчёт – он одним взглядом видит скорость и бензин. Дашборд делает то же с данными.
Дашборд (от английского dashboard – приборная панель) – один экран, на котором собраны главные числа и несколько графиков про одно и то же. Сверху обычно стоят плитки с главными числами: среднее, максимум, итог. Ниже – графики, каждый отвечает на свой вопрос. Зачем всё на одном экране? Чтобы сравнивать. Посмотрел на круг – ясных дней больше всего. Перевёл взгляд на линию – а ясные дни, оказывается, самые холодные.
Читают дашборд сверху вниз. Заголовок скажет, про что он, где и за какое время. Плитки – ответы на самые частые вопросы. Каждый график сначала прочитай отдельно, по правилам раздела 6.2, а потом сопоставь их между собой: ось времени у них общая (здесь – дни марта), и один и тот же день можно найти на каждом.
Вычислительное эссе – это короткое исследование, где рассуждение идёт вперемешку с таблицами и графиками, а в конце стоит вывод словами. В программе сферы эссе и дашборд делают в Датавиз-конструкторе: это последовательность диаграмм и текстовых пояснений (текст пишут в формате Markdown), кода там нет. Для сравнения: тетради Colab и Jupyter устроены похоже, только там между текстом и графиком есть ещё и код. Проверять себя можно одним вопросом: если закрыть весь текст и оставить только график, подтвердит ли он твой вывод?
Хорошее эссе отвечает на пять вопросов:
- Что проверяем? Вопрос или гипотеза одной фразой.
- На каких данных? Откуда, сколько строк, за какое время, условные они или настоящие.
- Что показывает график? Какой вид выбран и почему.
- Какой вывод? Словами и с числами: «в 4 ясных дня средняя температура −14,75 °C, в 3 снежных −5 °C».
- Какие оговорки? Мало данных, выбросы, связь не равна причине.
Вот пример вывода по графику опозданий автобуса из раздела 6.4:
Мы проверяли, опаздывает ли школьный автобус сильнее в мороз. Данные – 13 утр двух зим (условные). Мы выбрали точечную диаграмму: у каждого утра две величины, температура и опоздание. Самые морозные утра (−25 °C и холоднее) дали опоздания 6–10 минут, утра от −10 °C и теплее – не больше 3 минут. Гипотеза подтверждается. Исключение одно: буран при −5 °C и опоздание 12 минут, значит, на опоздания влияет не только мороз. Утр всего 13, вывод стоит проверить ещё на одной зиме.
Текст между кодом в тетрадях Colab и Jupyter пишут на Markdown – это простая разметка текста значками: строка с # в начале становится заголовком, слово в **звёздочках** – жирным, строки с - в начале – списком. Такой текст легко читать даже без оформления, в обычном блокноте.
# Опаздывает ли автобус в мороз

**Гипотеза:** в сильный мороз автобус опаздывает сильнее.

- данные: 13 утр, две зимы (условные)
- график: точечная диаграмма «температура – опоздание»
Запомни. Дашборд – главное на одном экране: плитки с числами и несколько графиков. Эссе – вопрос, данные, график, вывод с числами и оговорки. Вывод без чисел – это мнение, а не вывод.
Совет. Задачи «выбери все верные выводы» решай по одному утверждению за раз. Для каждого найди на графике или в таблице число, которое его подтверждает или опровергает, и поставь рядом «да» или «нет». Слова «потому что», «из-за», «всегда» – повод насторожиться: график редко доказывает причину.
6.7. Разбираем задачи
Задача 6.1 Год в Новосибирске
По графику средней температуры в Новосибирске (раздел 6.2) ответь на вопросы. а) Какой месяц самый холодный и какая в нём средняя температура? б) Сколько месяцев в году средняя температура выше нуля? в) Найди размах средних температур за год. г) Между какими соседними месяцами средняя температура выросла сильнее всего и на сколько градусов?
Дано: линейный график, 12 точек с подписанными значениями.
Найти: самый холодный месяц; число месяцев выше нуля; размах; самый большой рост между соседями.
Шаг 1. Самый холодный месяц. Ищем самую нижнюю точку. Это январь, −17 °C.
Шаг 2. Выше нуля. Считаем точки над линией нуля: апрель (2), май (10), июнь (17), июль (19), август (16), сентябрь (10), октябрь (2). Всего 7 месяцев.
Шаг 3. Размах. Максимум – июль, 19 °C, минимум – январь, −17 °C. Размах градусов.
Шаг 4. Самый большой рост. Рост – это «следующий минус предыдущий». Смотрим весну, где линия идёт вверх: январь → февраль: ; февраль → март: ; март → апрель: ; апрель → май: ; май → июнь: ; июнь → июль: . Самый большой – 10 градусов, с марта по апрель. На графике это самый крутой подъём линии.
В Новосибирске и правда холоднее всего в январе, а в апреле сходит снег – так что резкий скачок весной не удивляет.
Типичная ошибка. Потерять минус у −17 и посчитать размах как . Размах не может быть меньше разницы между любыми двумя точками, а июль и январь явно отличаются больше чем на 2 градуса. Ещё путают «самый большой рост» с самой высокой точкой (июль). Высокая точка – не то же самое, что крутой подъём.
Ответ: а) январь, −17 °C; б) 7 месяцев; в) 36 °C; г) с марта по апрель, на 10 °C.
Своя задача по программе сферы, модуль 4
Реши сам
6.1. По графику температуры в Новосибирске (раздел 6.2): а) сколько месяцев в году средняя температура ниже −10 °C? б) Какой месяц теплее: май или сентябрь?
ответ6.2. На вертикальной оси подписаны 0, 50, 100, 150, а между соседними подписями – по 5 одинаковых промежутков. Сколько стоит одно деление? Столбик кончается на третьем делении выше подписи 100. Какое число он показывает?
ответЗадача 6.2 Какой график нужен
Сопоставь каждую ситуацию с видом графика, который подходит лучше всего. Один вид может подойти к нескольким ситуациям.
Ситуации:
- Как менялся вес тыквы на даче каждую неделю лета.
- Какую часть учеников 6 классов занимает каждый кружок, если каждый ученик ходит ровно в один кружок.
- Сколько килограммов макулатуры собрал каждый из пяти классов.
- Есть ли связь между временем в телефоне вечером и временем засыпания у 30 учеников.
- Опрос «Какие предметы тебе нравятся? Можно отметить несколько»: сколько процентов учеников отметили каждый предмет.
Виды: А – столбчатая, Б – линейный, В – круговая, Г – точечная.
Дано: 5 ситуаций, 4 вида графиков.
Найти: пары «ситуация – вид».
Шаг 1. Для каждой ситуации задаём вопрос из таблицы раздела 6.1.
Шаг 2. Ситуация 1. Одна величина (вес тыквы) меняется со временем (недели). Это линейный график – Б.
Шаг 3. Ситуация 2. Все ученики – одно целое, каждый попал ровно в одну долю, доли в сумме дают 100 %. Круговая диаграмма – В.
Шаг 4. Ситуация 3. Сравниваем пять классов между собой – «кто больше». Столбчатая – А.
Шаг 5. Ситуация 4. У каждого ученика две величины: время в телефоне и время засыпания. Вопрос «связаны ли» – точечная диаграмма, Г. Каждый ученик станет одной точкой.
Шаг 6. Ситуация 5. Вроде бы проценты и доли – тянет нарисовать круг. Но ответы можно было отмечать по нескольку, поэтому проценты в сумме выйдут больше 100. Один и тот же ученик попадёт в несколько долек сразу, и целого круга из них не сложить. Сравниваем предметы между собой – столбчатая, А.
Столбчатая понадобилась дважды – условие это прямо разрешает.
Самая соблазнительная ошибка – в ситуации 5 выбрать круговую: «там же проценты». Проценты ещё не значат «доли одного целого». Круговая годится, только когда каждый объект попадает ровно в одну дольку.
Ответ: 1 – Б, 2 – В, 3 – А, 4 – Г, 5 – А.
Своя задача по программе сферы, модуль 4
Реши сам
6.3. Сопоставь ситуацию и вид графика (А – столбчатая, Б – линейный, В – круговая, Г – точечная). 1) Как менялось число подписчиков канала кружка по месяцам. 2) Какую долю учеников школы привозит автобус, привозят родители, приходят пешком (каждый назвал один способ). 3) Рост и масса 25 учеников: есть ли связь. 4) Сколько книг прочитал каждый из пяти друзей.
ответ6.4. Два опроса в 6 классах. Первый: «Где ты провёл больше всего времени летом?» (один ответ) – на даче 45 %, в лагере 30 %, в городе 25 %. Второй: «Где ты бывал летом? Можно отметить несколько» – на даче 60 %, в лагере 35 %, в городе 70 %. Для какого опроса можно нарисовать круговую диаграмму? Какой график нужен для другого?
ответЗадача 6.3 Какой жанр популярнее
Школьный клуб выложил в свой онлайн-кинотеатр 10 мультфильмов и через месяц выгрузил таблицу просмотров.
| Код | Жанр | Возраст | Просмотры |
|---|---|---|---|
| М1 | комедия | 0+ | 120 |
| М2 | комедия | 6+ | 90 |
| М3 | комедия | 6+ | 60 |
| М4 | комедия | 0+ | 70 |
| М5 | приключения | 6+ | 150 |
| М6 | приключения | 12+ | 110 |
| М7 | приключения | 0+ | 40 |
| М8 | фантастика | 12+ | 160 |
| М9 | фантастика | 6+ | 50 |
| М10 | фантастика | 12+ | 60 |
Аналитик строит столбчатую диаграмму: по горизонтали – жанр, по вертикали – просмотры. Какой жанр окажется самым высоким столбиком, если выбрать агрегацию а) «сумма»; б) «среднее»; в) «максимум»? г) Сколько всего просмотров у мультфильмов с меткой 6+?
Дано: таблица, 10 строк, 3 жанра.
Найти: победителя по сумме, по среднему и по максимуму; сумму просмотров для 6+.
Шаг 1. Раскладываем строки по жанрам. Комедия: 120, 90, 60, 70 (4 мультфильма). Приключения: 150, 110, 40 (3). Фантастика: 160, 50, 60 (3).
Шаг 2. Сумма. Комедия: . Приключения: . Фантастика: . Больше всех – комедия.
Шаг 3. Среднее. Сумму группы делим на число мультфильмов в ней. Комедия: . Приключения: . Фантастика: . Больше всех – приключения.
Шаг 4. Максимум. Самое большое число в каждой группе: комедия – 120, приключения – 150, фантастика – 160. Больше всех – фантастика.
Шаг 5. Метка 6+. Выбираем строки, где в столбце «Возраст» стоит 6+: М2 (90), М3 (60), М5 (150), М9 (50). Сумма .
Шаг 6. Проверка программой (в Colab, где есть библиотека pandas для таблиц).
import pandas as pd

df = pd.DataFrame({
    "жанр": ["комедия", "комедия", "комедия", "комедия",
             "приключения", "приключения", "приключения",
             "фантастика", "фантастика", "фантастика"],
    "просмотры": [120, 90, 60, 70, 150, 110, 40, 160, 50, 60],
})
print(df.groupby("жанр")["просмотры"].agg(["sum", "mean", "max", "count"]))
pd.DataFrame собирает таблицу из столбцов. groupby("жанр") раскладывает строки по жанрам, ["просмотры"] выбирает столбец, а agg считает для каждой группы сразу четыре агрегации: сумму, среднее, максимум и количество. Программа печатает таблицу: комедия – 340, 85, 120, 4; приключения – 300, 100, 150, 3; фантастика – 270, 90, 160, 3.
Почему победители разные? Комедий больше всех – четыре, поэтому они и выигрывают по сумме: побеждает количество. По среднему комедии проигрывают – каждую в отдельности смотрят не так уж много. А в «максимуме» фантастику вытягивает один хит на 160 просмотров.
Типичная ошибка. Посчитать среднее, поделив сумму на 10 (на все мультфильмы), а не на число мультфильмов своего жанра. Тогда у комедии выйдет 34, у приключений 30, у фантастики 27, и победитель по «среднему» совпадёт с победителем по сумме. А в пункте г) легко пропустить строку – пересчитай: мультфильмов с меткой 6+ должно быть четыре.
Ответ: а) комедия (340); б) приключения (100); в) фантастика (160); г) 350 просмотров.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Описательная статистика и анализ возрастных ограничений»
Реши сам
6.5. Таблица результатов олимпиады кружков: «Роботы» – участники набрали 7, 9 и 5 баллов; «ИИ» – 8 и 10; «Космос» – 6, 6, 6 и 9. Строим столбчатую диаграмму «кружок – баллы». Какой кружок будет самым высоким столбиком при агрегации а) «сумма»; б) «среднее»; в) «количество»?
ответ6.6.* В 6 «А» 20 учеников, в среднем каждый прочитал за лето 8 книг. В 6 «Б» 30 учеников, в среднем по 3 книги. Сколько книг в среднем прочитал один ученик, если считать оба класса вместе?
ответЗадача 6.4 Лучшие ролики планетария
Планетарий выложил 10 роликов о космосе. Аналитик построил точечную диаграмму: по горизонтали – сколько тысяч раз ролик посмотрели, по вертикали – какой процент зрителей досмотрел его до конца. Каждая точка подписана кодом ролика.
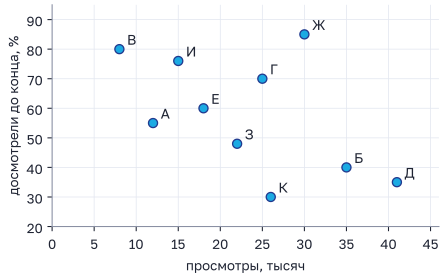
а) Запиши коды трёх роликов с наибольшим числом просмотров, от большего к меньшему. б) Запиши коды трёх роликов с наибольшим процентом досмотра, от большего к меньшему. в) Какой ролик попал в обе тройки? г) Подсказка у точек показала: у ролика Д – 41 тыс. просмотров и 35 % досмотра, у ролика Ж – 30 тыс. и 85 %. Сколько человек досмотрели до конца ролик Д и сколько – ролик Ж?
Дано: точечная диаграмма, 10 точек; для Д и Ж – точные значения.
Найти: две тройки кодов; общий код; число досмотревших Д и Ж.
Шаг 1. Тройка по просмотрам. Больше просмотров – правее. Идём справа налево: Д (около 41 тыс.), Б (35 тыс.), Ж (30 тыс.). Следующая точка, К, – уже левее, около 26 тыс.
Шаг 2. Тройка по досмотру. Больше процент – выше. Идём сверху вниз: Ж (85 %), В (80 %), И (около 76 %). Следующая, Г, – 70 %, заметно ниже.
Шаг 3. Общий ролик. В первой тройке Д, Б, Ж, во второй Ж, В, И. Общий – Ж. Это правая верхняя точка облака: ролик и смотрят много, и досматривают.
Шаг 4. Досмотревшие. Сначала переводим единицы: 41 тыс. = 41 000 человек, 30 тыс. = 30 000. Процент от числа – умножаем на процент и делим на 100. Ролик Д: человек. Ролик Ж: человек.
Выходит, самый просматриваемый ролик Д досмотрели почти вдвое меньше людей, чем Ж: его часто открывают, но бросают. Для планетария это ценный вывод – только по числу просмотров его не увидеть.
Ошибка номер один – перепутать оси: искать «больше просмотров» по высоте точки. Тогда в первую тройку попадут Ж, В, И, и обе тройки совпадут. Всегда сначала читай подписи осей. Бывает и так: в пункте г) выходит «14,35» и «25,5» – забыли, что на оси тысячи, а спрашивали людей.
Ответ: а) Д, Б, Ж; б) Ж, В, И; в) Ж; г) ролик Д – 14 350 человек, ролик Ж – 25 500 человек.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Лучшие книги»
Реши сам
6.7. В школьном приложении шесть игр. Оценка и число скачиваний: Г1 – 4,8 и 1200; Г2 – 4,1 и 3000; Г3 – 4,9 и 2500; Г4 – 3,5 и 3500; Г5 – 4,6 и 800; Г6 – 4,7 и 2800. Какая игра попадает и в тройку лучших по оценке, и в тройку лучших по скачиваниям?
ответ6.8. Круговая диаграмма показывает, какой кружок выбрали 240 учеников (каждый – один). Долька «Кванториум» занимает угол 90°. а) Сколько учеников выбрали «Кванториум»? б) Долька «Спорт» – 30 % учеников. Какой у неё угол? Весь круг – 360°.
ответЗадача 6.5 Реклама прогноза погоды
Два приложения прогнозируют погоду с помощью ИИ. За 100 дней прогноз А оказался верным в 92 днях, прогноз Б – в 98. Разработчики Б нарисовали рекламу.
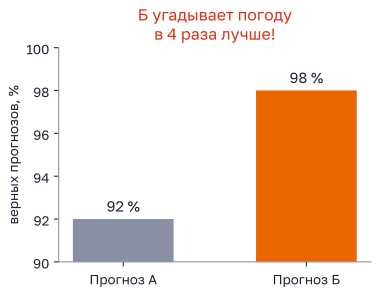
а) На сколько процентов прогноз Б верен чаще, чем прогноз А? Округли до десятых. б) Выбери все верные утверждения.
- На рисунке столбик Б в 4 раза выше столбика А.
- Приложение Б угадывает погоду в 4 раза чаще, чем А.
- Из 100 дней Б угадало на 6 дней больше, чем А.
- Приложение Б ошибается в 4 раза реже, чем А.
- Вертикальная ось на рисунке начинается с нуля.
Дано: А – 92 верных дня из 100, Б – 98 из 100; ось рисунка от 90 до 100.
Найти: на сколько процентов Б верен чаще; верные утверждения.
Шаг 1. Проценты. «На сколько процентов больше» считаем от того, с чем сравниваем, – от А. Разница дней. %.
Шаг 2. Утверждение 1. Ось начинается с 90. Видимая высота столбика А – деления, Б – делений. . На рисунке – правда в 4 раза. Верно.
Шаг 3. Утверждение 2. Угадывает в раза чаще, а не в 4. Неверно – этот обман и сделан обрезанной осью.
Шаг 4. Утверждение 3. дней. Верно.
Шаг 5. Утверждение 4. Ошибок у А дней, у Б дня. – ошибается в 4 раза реже. Верно! Любопытно: «в 4 раза» в рекламе взялось из неправильного рисунка, а про ошибки оно случайно правда.
Шаг 6. Утверждение 5. Нижняя подпись оси – 90. Неверно.
Можно было и не считать. Оба приложения угадывают больше 9 дней из 10, поэтому «в 4 раза чаще» невозможно в принципе: в 4 раза больше 92 дней – это 368 дней из 100.
Типичная ошибка. Отбросить утверждение 4 заодно с утверждением 2: «раз про 4 раза – значит, обман». Каждое утверждение проверяй своим числом. Угадывать и ошибаться – разные величины, и отношение у них разное. И в пункте а) не дели на 98: выйдет 6,1 %, а сравнивали с А.
Ответ: а) на 6,5 %; б) верны 1, 3 и 4.
Своя задача по программе сферы, модуль 4
Реши сам
6.9. 6 «А» собрал 150 кг макулатуры, 6 «Б» – 160 кг. На столбчатой диаграмме вертикальная ось начинается со 140. а) Во сколько раз столбик 6 «Б» выглядит выше столбика 6 «А»? б) Во сколько раз 6 «Б» собрал больше на самом деле? Округли до сотых.
ответ6.10. Число посетителей планетария по месяцам (условно): январь – 1200, февраль – 1500, март – 2100, апрель – 2600, май – 1900, июнь – 1400. а) Между какими соседними месяцами посетителей прибавилось больше всего? б) На сколько процентов уменьшилось число посетителей с апреля по май? Округли до целых.
ответЗадача 6.6* Кто больше читает
Библиотекарь проверяет гипотезу: «6 «А» читает больше, чем 6 «Б»». В каждом классе по 9 учеников, каждый назвал, сколько книг прочитал за лето.
6 «А»: 4, 2, 5, 40, 3, 6, 4, 3, 5.
6 «Б»: 7, 5, 8, 6, 9, 7, 6, 8, 7.
а) Найди среднее и медиану для каждого класса. б) Подтверждает ли гипотезу среднее? А медиана? в) Сколько учеников 6 «А» прочитали больше среднего по своему классу? г) Что честнее сказать о гипотезе и почему?
Дано: два ряда по 9 чисел.
Найти: средние и медианы; вывод о гипотезе.
Шаг 1. Упорядочиваем. 6 «А»: 2, 3, 3, 4, 4, 5, 5, 6, 40. 6 «Б»: 5, 6, 6, 7, 7, 7, 8, 8, 9.
Шаг 2. Средние. Сумма 6 «А»: , среднее книг. Сумма 6 «Б»: , среднее книг.
Шаг 3. Медианы. В каждом ряду 9 чисел, медиана – пятое по порядку (четыре слева, четыре справа). 6 «А»: 4 книги. 6 «Б»: 7 книг.
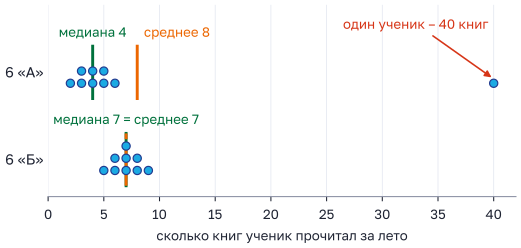
Шаг 4. Что говорят сводки. По среднему 6 «А» впереди: 8 больше 7 – гипотеза как будто подтверждается. По медиане впереди 6 «Б»: 7 больше 4 – гипотеза опровергается.
Шаг 5. Больше среднего в 6 «А». Среднее 8. Больше 8 книг прочитал только один ученик – тот, у кого 40. Остальные восемь прочитали от 2 до 6.
Шаг 6. Вывод. В 6 «А» есть выброс – один ученик с 40 книгами. Он один поднял среднее класса вдвое: без него сумма , среднее книги. Обычный ученик 6 «А» прочитал около 4 книг, обычный ученик 6 «Б» – около 7. Честный вывод: гипотеза не подтверждается, больше читает 6 «Б», а в 6 «А» есть один очень увлечённый читатель.
Шаг 7. Проверка программой. Модуль statistics входит в Python, ставить ничего не нужно.
from statistics import mean, median

klass_a = [2, 3, 3, 4, 4, 5, 5, 6, 40]
klass_b = [5, 6, 6, 7, 7, 7, 8, 8, 9]

print(mean(klass_a), median(klass_a))   # 8 4
print(mean(klass_b), median(klass_b))   # 7 7

bolshe = 0
for k in klass_a:
    if k > mean(klass_a):
        bolshe = bolshe + 1
print(bolshe)                            # 1
mean – среднее, median – медиана, сортировать для них вручную не нужно. Цикл for перебирает учеников 6 «А», и каждый раз, когда число книг больше среднего, счётчик bolshe увеличивается на 1.
Примета выброса: среднее вдвое больше медианы, а выше среднего всего один человек из девяти. У 6 «Б» среднее и медиана совпали: числа там ровные, без выбросов.
Самая частая ошибка – взять медиану из неупорядоченного ряда. Пятое число в исходной записи 6 «А» – это 3, а в 6 «Б» – 9, и вывод получится случайным. Обидно и другое: сказать «гипотеза подтверждается, среднее же больше» и не заметить, что одно число из девяти решило всё.
Ответ: а) 6 «А»: среднее 8, медиана 4; 6 «Б»: среднее 7, медиана 7; б) среднее подтверждает, медиана – нет; в) один ученик; г) гипотеза не подтверждается: среднее 6 «А» раздуто выбросом (40 книг), по медиане больше читает 6 «Б».
Своя задача по программе сферы, модуль 4
Реши сам
6.11. Пять недель подряд на даче мерили высоту снега, см: 12, 20, 26, 18, 39. Найди среднее, медиану и размах.
ответ6.12. Восемь ребят записали, сколько минут идут до школы: 25, 7, 12, 40, 15, 10, 18, 9. Найди медиану и среднее.
ответ6.13.* Средний балл пятерых участников команды – 12. В команду пришёл шестой, и средний балл команды стал 13. Сколько баллов у шестого участника?
ответЗадача 6.7* Дашборд метеостанции
Ребята из кружка поставили во дворе школы метеостанцию и собрали дашборд за 1–10 марта (рисунок в разделе 6.6). Температура по дням, °C: −12, −15, −6, −4, −9, −18, −14, −5, −3, −8. Погода: 1, 2, 6, 7 марта – ясно; 3, 4, 8 марта – снег; 5, 9, 10 марта – облачно без снега. Выбери все верные утверждения.
- Самый холодный день – 6 марта.
- Больше всего снега за один день выпало 8 марта – 8 см.
- Ясных дней вдвое больше, чем снежных.
- В снежные дни средняя температура больше чем на 9 градусов выше, чем в ясные.
- Средняя температура за 10 дней ниже −10 °C.
- Снег идёт потому, что становится теплее.
Дано: дашборд; температура и погода по 10 дням.
Найти: номера верных утверждений.
Шаг 1. Утверждение 1. Самая нижняя точка на линии температуры – день 6, −18 °C. То же число – на плитке «самый холодный день». Верно.
Шаг 2. Утверждение 2. Самый высокий столбик снега – день 8, он доходит до 8 см. Верно.
Шаг 3. Утверждение 3. По кругу: ясно – 40 %, снег – 30 %. Из 10 дней это 4 и 3. Вдвое больше было бы 6 и 3. Неверно.
Шаг 4. Утверждение 4. Считаем среднее для каждой группы дней. Ясные (1, 2, 6, 7 марта): °C. Снежные (3, 4, 8 марта): °C. Разница: градуса. Больше 9 – верно.
Шаг 5. Утверждение 5. Сумма всех десяти температур: . Среднее °C – это есть и на плитке. −9,4 выше −10: на градуснике оно ближе к нулю. Неверно.
Шаг 6. Утверждение 6. Дашборд показывает, что снег и относительно тёплые дни совпадают. Но «потому что» – это про причину, а график показывает только связь. Может быть, всё наоборот, а может, у обоих общая причина. Вообще-то зимой облака работают как одеяло: в ясную погоду тепло уходит в небо, и становится холоднее, а снег падает из облаков. Но это знание не из дашборда. Утверждение из данных не следует – неверно.
Шаг 7. Вывод словами. «За 1–10 марта средняя температура была −9,4 °C. Самыми холодными были ясные дни (в среднем −14,75 °C), в снежные дни было теплее – в среднем −5 °C. Снега выпало 18 см за три дня. Данных всего 10 дней, вывод о связи снега и тепла стоит проверить на всём марте».
Сверимся с плитками. На них те же числа, что у нас: −9,4 °C, −18 °C, см.
Типичная ошибка. В утверждении 5 сравнить числа без минуса: 9,4 меньше 10, значит, будто бы −9,4 «ниже» −10. Среди отрицательных чисел ниже (холоднее) то, у которого без минуса число больше: −10 холоднее −9,4. А с утверждением 6 соглашаются, потому что на графике «всё видно». График видит только «вместе», а не «потому что».
Ответ: верны 1, 2 и 4.
Своя задача по программе сферы, модуль 4
Реши сам
6.14. Гипотеза: «Чем больше часов в неделю ученик тренируется, тем быстрее он пробегает 60 м». Данные шести ребят (часы в неделю – время бега): 1 ч – 11,2 с; 2 ч – 10,8 с; 3 ч – 10,5 с; 4 ч – 10,1 с; 5 ч – 9,9 с; 6 ч – 9,6 с. Какой вывод верен? А) Гипотеза подтверждается. Б) Гипотеза опровергается: время растёт. В) По этим данным ничего сказать нельзя.
ответ6.15.* Пожарная часть целый год записывала про каждый пожар, сколько машин приехало его тушить и какой ущерб (в рублях) он нанёс. На точечной диаграмме точки идут полосой вверх: чем больше машин, тем больше ущерб. Выбери все верные выводы. 1) Пожарные машины увеличивают ущерб. 2) Обе величины больше, когда больше сам пожар. 3) Чтобы уменьшить ущерб, надо присылать меньше машин. 4) График показывает, что величины меняются вместе, но не показывает, что одна вызывает другую.
ответНейросети своими руками
В главе 1 ты познакомился с одним нейроном: входы умножаются на веса, складываются и сравниваются с порогом. Теперь соберём из нейронов сеть, посчитаем её ответ вручную и посмотрим, как она учится, – что такое эпоха, скорость обучения и почему сеть иногда «зубрит». В конце главы – сервисы, где нейросеть собирают мышкой: Teachable Machine, Machine Learning for Kids и конструктор GraphNet, с которым работают на сфере. В задачах будем считать выход маленькой сети и связи между слоями, искать по таблице точности, где сеть переобучилась, и подбирать сеть под задачу.
7.1. Из нейронов – сеть: слои и связи
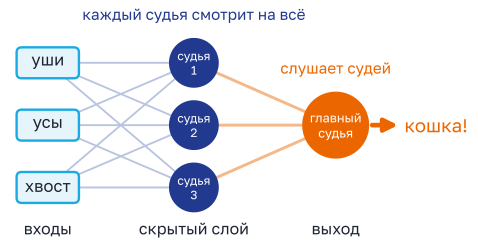
Каждый судья скрытого слоя смотрит на все признаки сразу и ставит свою оценку. Главный судья слушает судей, у каждого – свой вес. Его решение и есть ответ сети.
Один нейрон умеет немного: сложить входы с весами и сравнить с порогом. Решить, открывать ли купол телескопа, он может, а узнать кошку на фото – уже нет. Поэтому нейроны соединяют в сеть: ответ одного нейрона становится входом для других.
Нейроны в сети стоят слоями – столбиками. Напомним, какие бывают слои (подробнее – в главе 1):
- входной слой – сюда подают признаки объекта, по одному числу на вход;
- скрытые слои – нейроны внутри сети, их может быть один, два, десять;
- выходной слой – отсюда берут ответ.
Чаще всего каждый нейрон одного слоя соединён с каждым нейроном следующего. Такие слои называют полносвязными. Каждая связь – это одна стрелочка со своим весом. Сеть описывают коротко, числами через тире: «3–4–2» значит 3 входа, 4 нейрона в скрытом слое и 2 выхода.
Сколько связей между слоями
Сосчитаем связи в сети 3–4–2. От каждого из 3 входов идёт по стрелке к каждому из 4 скрытых нейронов: это связей. От каждого из 4 скрытых нейронов – к каждому из 2 выходов: связей. Всего .
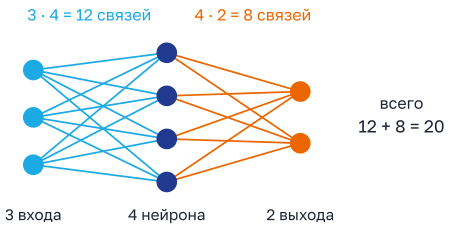
Выходит, число связей между двумя соседними слоями равно произведению числа нейронов в них. Для всей сети складываем связи между всеми парами соседних слоёв:
где – число входов, – число нейронов в следующем слое и так далее, – число связей. Перемножаем только соседние слои: входы с выходами в сети 3–4–2 напрямую не соединены.
Кроме весов связей у каждого нейрона скрытых и выходного слоя есть ещё одно число – смещение. Это добавка, которую нейрон прибавляет к сумме всегда, даже когда все входы равны нулю. По сути, это порог из главы 1, только с обратным знаком: порог 5 – всё равно что смещение −5. У входов смещения нет: они ничего не считают, а просто передают числа. Веса и смещения вместе называют параметрами сети: именно их она подбирает при обучении. В сети 3–4–2 смещений , а параметров .
Считать связи удобно программой. Список sloi хранит число нейронов в каждом слое. Запись sloi[1:] – тот же список без первого числа, то есть [4, 2]. zip из главы 1 складывает два списка в пары, и получаются пары соседних слоёв: (3, 4), потом (4, 2).
sloi = [3, 4, 2]                     # сеть 3–4–2

svyazi = 0
for a, b in zip(sloi, sloi[1:]):     # пары соседних слоёв
    svyazi += a * b
smeshcheniya = sum(sloi[1:])         # у всех слоёв, кроме входного
print(svyazi, smeshcheniya, svyazi + smeshcheniya)   # 20 6 26
Какую сеть выбрать под задачу
Число входов и выходов сеть не выбирает – его диктует задача.
- Входов столько, сколько признаков. Для таблицы – столько, сколько столбцов-признаков. Для картинки каждый пиксель (точка картинки) – отдельный признак: чёрно-белая картинка 8 × 8 пикселей даёт входа.
- Выходов при классификации столько, сколько классов. Каждый выход показывает, насколько сеть уверена «в своём» классе, и ответом считают выход с самым большим числом. Для трёх видов облаков – 3 выхода. Для ответа «да или нет» хватает одного выхода: близко к 1 – «да», близко к 0 – «нет».
- При регрессии, когда сеть предсказывает число (температуру, цену, время), выход один, и его число берут как есть, без ступеньки.
А вот сколько скрытых слоёв и нейронов в них, решает человек. Такие настройки, которые выбирают до обучения, называют гиперпараметрами: число слоёв и нейронов, число эпох, скорость обучения (о двух последних – в разделе 7.3). Веса же сеть подбирает сама. Мало скрытых нейронов – сеть не уловит сложную закономерность. Слишком много – учится долго и легко начинает зубрить примеры (раздел 7.4).
Запомни. Связи между соседними слоями = произведение числа нейронов в них; связи сети – сумма по всем парам соседних слоёв. Смещения есть у каждого нейрона, кроме входов. Входов – сколько признаков, выходов – сколько классов, для числа – один выход.
Совет. Прежде чем считать, выпиши слои в строчку: «64 – 16 – 10». Потом под каждым тире – произведение соседей: , . Так ты не перемножишь случайно первый слой с последним.
7.2. Считаем выход сети
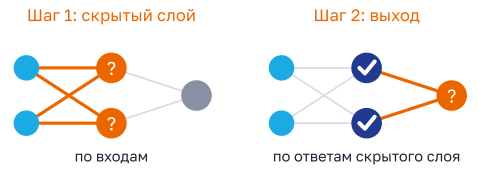
Пока скрытый слой не досчитал, выходу нечего складывать. Сначала находим ответы всех нейронов скрытого слоя, потом по ним – ответ выхода.
Каждый нейрон сети умножает каждый свой вход на вес его связи и всё складывает. Потом прибавляет своё смещение – получается сумма . И наконец пропускает сумму через функцию активации – правило, которое превращает сумму в ответ нейрона.
Буквами для нейрона с двумя входами:
где – входы, – веса, – смещение.
Функций активации в задачах три:
- ступенька из главы 1: – ответ 1, иначе 0 (если в задаче дан порог , сравнивают с порогом);
- ReLU (читается «рэ-лу»): отрицательную сумму заменяет нулём, а остальное пропускает как есть. , , . Проще всего запомнить так: «минус – в ноль»;
- без изменений (её ещё называют линейной): ответ равен сумме. Так делают у выхода, когда сеть предсказывает число.
ReLU – самая частая функция в скрытых слоях настоящих сетей. Если в задаче про неё ничего не сказано – читай условие ещё раз: какая функция у какого слоя, всегда написано.
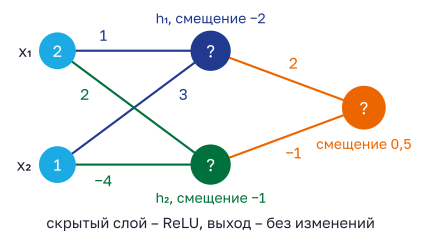
Посчитаем сеть с рисунка. На входах , . В скрытом слое ReLU, у выхода – без изменений.
Нейрон . Веса связей, которые в него входят: от – 1, от – 3. Смещение −2. . Сумма положительная, ReLU пропускает её: .
Нейрон . Веса: от – 2, от – (−4). Смещение −1. . Сумма отрицательная, ReLU превращает её в ноль: .
Выход. Его входы – ответы скрытого слоя: и . Веса 2 и (−1), смещение 0,5. . Функция «без изменений» – ответ сети 6,5.
Проверим программой. Каждый нейрон – одна строчка: сумма произведений плюс смещение. max(0, s) – вся ReLU в одной записи: из числа и нуля берём большее, поэтому минус превращается в ноль.
def relu(s):
    return max(0, s)       # «минус – в ноль»

x1, x2 = 2, 1
h1 = relu(x1 * 1 + x2 * 3 + (-2))
h2 = relu(x1 * 2 + x2 * (-4) + (-1))
y = h1 * 2 + h2 * (-1) + 0.5          # у выхода – без изменений
print(h1, h2, y)                      # 3 0 6.5
Что было бы, если забыть ReLU? Тогда и выход . Ответ другой, хотя вся арифметика верна. На этом баллы теряют чаще всего.
Запомни. Порядок всегда один: сумма «вход · вес» по всем входам, плюс смещение, потом функция активации. Считаем слой за слоем: входами выходного нейрона служат ответы скрытых нейронов, а не исходные .
Совет. Выписывай каждую связь отдельным слагаемым и отрицательные числа – в скобках: «». Рядом с каждым скрытым нейроном сразу пиши его ответ после ReLU, обведи его – и дальше бери только обведённые числа.
7.3. Как сеть учится: ошибка, веса, эпохи
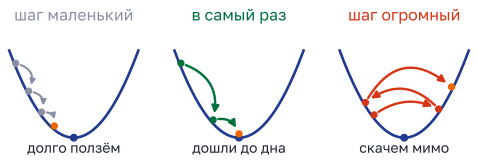
Маленькими шажками до дна идти долго. Слишком большими – перепрыгиваешь его и скачешь со склона на склон.
Обученная сеть – это сеть с хорошими весами. Сначала веса ставят наугад, и сеть отвечает невпопад. Потом ей по одному показывают обучающие примеры и каждый раз чуть-чуть подкручивают веса, чтобы ответ стал ближе к правильному. Никто не подбирает веса вручную – это делает программа, но по понятному правилу.
Разберём его на самой маленькой «сети» – одном нейроне с одним входом, без смещения и без функции активации. Его ответ . Это линейная регрессия – предсказание числа по прямой. С неё начинают и в конструкторе GraphNet (раздел 7.5).
Пример. Дачник поливает грядки и хочет, чтобы модель подсказывала, сколько вёдер воды нужно. Вход – число грядок, ответ – вёдра. Обучающий пример один: 2 грядки – 6 вёдер. (Ты уже видишь, что на грядку нужно 3 ведра, но модель этого не знает.) Начальный вес .
Ошибка – разность между правильным ответом и ответом модели:
Модель ответила ведра, а нужно 6. Ошибка . Она положительная – модель ответила мало, вес надо увеличить. Была бы отрицательной – уменьшить.
Правило поправки. Словами: новый вес равен старому весу плюс скорость обучения, умноженная на ошибку и на вход. Буквами:
где (греческая буква «эта») – скорость обучения, небольшое число, которое выбирает человек. Возьмём . Поправка , новый вес .
Почему в правиле стоит вход ? Чем больше был вход, тем сильнее этот вес повлиял на ответ – тем сильнее его и поправляем. А если вход был 0, вес в ответе вообще не участвовал, и трогать его незачем: .
Повторим поправку несколько раз на том же примере:
| Шаг | Вес | Ответ | Ошибка | Поправка | Новый вес |
|---|---|---|---|---|---|
| 1 | 1 | 2 | 4 | 0,8 | 1,8 |
| 2 | 1,8 | 3,6 | 2,4 | 0,48 | 2,28 |
| 3 | 2,28 | 4,56 | 1,44 | 0,288 | 2,568 |
| 4 | 2,568 | 5,136 | 0,864 | 0,1728 | 2,7408 |
Вес ползёт к 3, ошибка с каждым шагом тает: 4; 2,4; 1,44; 0,864. Ровно к 3 вес будет подбираться бесконечно долго, но уже через десяток шагов ошибка станет меньше 0,1 ведра, а этого хватает. Настоящая сеть делает то же самое сразу со всеми своими весами – с тысячами и миллионами.
w = 1          # начальный вес
eta = 0.1      # скорость обучения
x, y = 2, 6    # пример: 2 грядки – 6 вёдер

for shag in range(1, 5):
    E = y - w * x              # ошибка
    w = w + eta * E * x        # поправка веса
    print(shag, round(E, 4), round(w, 4))
# 1 4 1.8
# 2 2.4 2.28
# 3 1.44 2.568
# 4 0.864 2.7408
Эпоха
Обычно примеров не один, а сотни. Сеть проходит их по очереди и после каждого поправляет веса. Эпоха – один полный проход по всем обучающим примерам. «Обучили за 20 эпох» – значит, каждый пример сеть увидела 20 раз. Если в обучающей выборке 500 примеров и поправка идёт после каждого, за 20 эпох будет поправок.
Одной эпохи почти всегда мало: веса за один проход не успевают подобраться, как в нашей таблице после первого шага. Сколько эпох нужно, заранее не знает никто, и число эпох – тоже гиперпараметр.
Скорость обучения
Скорость обучения решает, насколько большой шаг делает сеть при каждой поправке. На графике – наш пример с грядками при трёх разных скоростях.
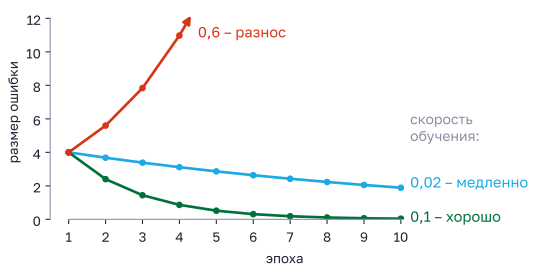
- – шаги крошечные. Через 10 эпох ошибка всё ещё почти 2 ведра. Учится, но очень медленно.
- – ошибка быстро тает до нуля.
- – шаг огромный. Вес с 1 прыгает сразу на – далеко за 3. На следующем шаге модель пытается вернуться и снова перелетает, только ещё дальше. Ошибка скачет с плюса на минус и растёт: 4; −5,6; 7,84; −10,98… (минус – модель ответила больше, чем нужно). Сеть «разносит», и ничему она уже не научится.
Отсюда правило: если ошибка от эпохи к эпохе растёт или скачет вверх-вниз, скорость обучения слишком большая – уменьши её. Если ошибка падает, но еле-еле, – можно немного увеличить скорость или добавить эпох.
Для любопытных. В сервисах поправку делают не после каждого примера, а после небольшой пачки примеров: ошибки по пачке усредняют и делают один шаг. Размер пачки по-английски – batch size. В Teachable Machine в дополнительных настройках (Advanced) три числа: Epochs – эпохи, Batch Size – размер пачки, Learning Rate – скорость обучения. По умолчанию там 50 эпох, пачка 16 и скорость 0,001.
Запомни. Ошибка = верный ответ − ответ модели. Новый вес = вес + скорость · ошибка · вход. Эпоха – один проход по всем обучающим примерам. Большая скорость – ошибка скачет и растёт, маленькая – учимся медленно.
Совет. Считая поправку вручную, записывай строчку таблицы целиком: вес, ответ, ошибка, поправка, новый вес. Знак ошибки проверяй по смыслу: модель ответила мало – ошибка положительная, вес растёт.
7.4. Переобучение: выучил наизусть, а новое не узнаёт
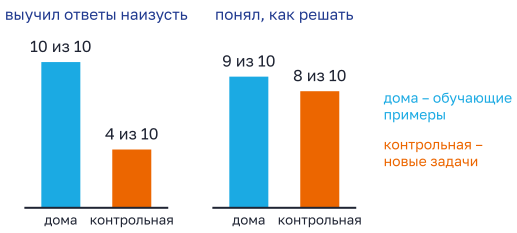
Первый выучил ответы наизусть: дома 10 из 10, а на контрольной с другими числами – 4. Второй понял, как решать, и на новых задачах почти не потерял. Сеть тоже умеет «зубрить».
Вспомни из главы 1: модель учат на обучающей выборке, а проверяют на проверочной – на примерах, которых она не видела. Если следить за точностью на обеих выборках после каждой эпохи, получится два графика.
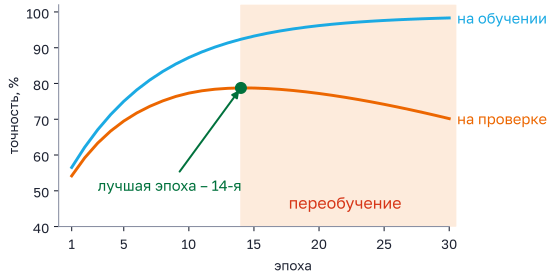
Сначала обе линии растут: сеть находит настоящие закономерности, и они работают и на новых примерах. Потом голубая линия ползёт дальше вверх, почти к 100 %, а оранжевая останавливается и начинает падать. Сеть перестала учиться общему и начала запоминать мелочи именно этих примеров: пятнышко на одной фотографии, шум на одной записи. На новых данных таких мелочей нет – и точность там падает. Так выглядит переобучение. На нашем графике оно начинается после 14-й эпохи.
Главный признак переобучения – большой разрыв: на обучении точность высокая, на проверке заметно ниже, и разрыв растёт с каждой эпохой. Бывает и обратная беда – недообучение: низкая точность и там, и там. Сеть ещё не выучила даже обучающие примеры: мало эпох, слишком маленькая скорость или слишком простая сеть.
| На обучении | На проверке | Что с сетью |
|---|---|---|
| высокая | тоже высокая, чуть ниже | всё хорошо |
| высокая | заметно ниже | переобучилась |
| низкая | низкая | недообучилась |
Что делать, если сеть переобучилась:
- остановиться вовремя – взять веса с той эпохи, где точность на проверке была лучшей (у нас – 14-я). Этот приём называют ранней остановкой;
- добавить примеров, и разных: сто одинаковых снимков в одной комнате научат меньше, чем тридцать в разных местах;
- упростить сеть – меньше скрытых нейронов. Сети с тысячами весов на полсотни примеров слишком легко запомнить каждый пример наизусть.
Разница двух точностей считается простым вычитанием, но будь внимателен со словами. Было 99 % и 72 %, разница – 27 процентных пунктов: так говорят, когда из процентов вычитают проценты. В задачах часто пишут проще: «на сколько процентов точность на обучении выше» – и ждут то же число 27.
Запомни. Переобучение – на обучении точность растёт, а на проверке падает. Лучшая эпоха – та, где выше всего точность на проверке, а не на обучении. Низкая точность на обеих выборках – недообучение.
Совет. В таблице точности по эпохам смотри только на «проверку» и найди там максимум. «Обучение» используй, лишь чтобы увидеть разрыв. Самая частая ошибка – выбрать эпоху, где точность на обучении 99 %.
7.5. Нейросеть без программирования
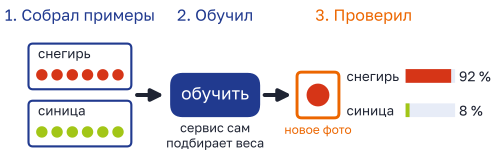
Разложил примеры по коробкам-классам, нажал кнопку – сервис сам подобрал веса. Показал новое фото – сеть ответила процентами: насколько она уверена в каждом классе.
Low-code (читается «лоу-код», по-английски «мало кода») – сервисы, где модель собирают мышкой, почти без программирования. Внутри у них те же слои, веса и эпохи, что в этой главе, просто считает всё программа.
Teachable Machine (teachablemachine.withgoogle.com) – сервис в браузере. Есть проекты для картинок, для звуков и для поз человека. Работа идёт так:
- Выбираешь проект, для картинок – «Standard image model». Создаёшь классы – те самые коробки с подписями. Сначала они называются «Class 1», «Class 2», их можно переименовать и добавить новые.
- В каждый класс добавляешь примеры: снимаешь с веб-камеры или загружаешь файлы (Upload). В звуковом проекте сервис дополнительно просит записать класс «фоновый шум» (Background Noise), чтобы сеть отличала тишину от звуков. Примеров звука нужно не меньше 20 на класс.
- Нажимаешь «Train Model» – «обучить модель». В дополнительных настройках можно поменять число эпох, размер пачки и скорость обучения (раздел 7.3).
- Проверяешь в окне Preview: показываешь камере новый предмет, и сеть рисует полоски с процентами для каждого класса. Проценты в сумме дают 100, ответ – класс с самой длинной полоской.
- Если модель устраивает, её можно выгрузить (Export Model) и вставить в свою программу.
Machine Learning for Kids (machinelearningforkids.co.uk) умеет учить модели распознавать текст, картинки, числа и звуки. В проекте три шага: «Train» – собрать примеры, «Learn & Test» – обучить модель и проверить её, «Make» – вставить её в свою программу на Scratch. Scratch там свой, встроенный в сайт: блоки для модели ищи в нём, на scratch.mit.edu их нет. Перед началом работы сайт может попросить подтвердить, что ты не робот; не пустил – попробуй ещё раз или с другого интернета. Автор сервиса – Дейл Лейн, тот самый, что написал книгу «Машинное обучение для детей» из списка литературы программы сферы.
Оба сервиса зарубежные и могут открываться не везде. Если не открылся – не беда: порядок работы у всех таких сервисов один, кнопки только называются по-разному.
GraphNet – конструктор нейросетей, который используют на сфере. Он ставится на компьютер, а сеть в нём собирают из блоков, соединяя их стрелками. Первые блоки загружают данные, дальше настраивают слои, функции активации и гиперпараметры. Обученная сеть делает прогноз на проверочных данных, программа сравнивает его с настоящими ответами и считает метрики точности. Начинают там с архитектуры для линейной регрессии: это нейрон из раздела 7.3, только со смещением – .
Сколько примеров нужно
Точного числа нет. Для первых опытов с картинками обычно хватает нескольких десятков примеров на класс, лучше – сотни. Важнее количества разнообразие: снимай предмет при разном свете, на разном фоне, с разных сторон, а голос записывай у разных людей. Сеть выучит только то, что ты ей показал. Показал кружку только сбоку – сверху она её не узнает.
И проверяй модель на новых примерах, которых не было в обучении. Проверка на тех же фото, что ушли в классы, ничего не скажет: их сеть могла просто запомнить.
Почему классы нельзя сильно перекашивать
Допустим, в классе «синица» 180 фото, а в классе «снегирь» – 20. Сеть быстро замечает, что «синица» почти всегда правильный ответ. Ленивая модель, которая про любую птицу говорит «синица», угадает 180 фото из 200: %. Точность выглядит прилично, а снегиря такая модель не узнает ни одного. Это та же ловушка редких случаев, что в главе 1.
Такой перекос называют дисбалансом классов, а выборку, где классы сопоставимы, – сбалансированной. Поровну быть не обязано: 500 и 500 – хороший баланс, 900 и 100 – сильный дисбаланс. Главное, чтобы примеров каждого класса было достаточно и они были примерно одного порядка. Так же, если в таблице из 100 записей какой-то класс встречается всего 5 раз, модель почти не увидит его. Если снегирей мало, добери снимков снегирей. Если добрать негде, убери часть лишних синиц: 20 и 20 лучше, чем 180 и 20, хотя примеров и меньше. В курсе вред дисбаланса называют «переобучением из-за дисбаланса»; не путай с переобучением из раздела 7.4: там модель хороша на обучении и плоха на проверке.
Ловушка фона. Сеть не знает, на что ты хотел, чтобы она смотрела. Если все снегири сняты зимой на снегу, а все синицы – летом на зелёной ветке, сеть легко научится отличать снег от листвы. На проверке с теми же условиями точность будет отличной, а синицу на снегу она назовёт снегирём. Лечится разнообразием: у каждого класса должен быть разный фон.
Запомни. Low-code: собрал примеры по классам → обучил → проверил на новых примерах. Классы – сопоставимо, без сильного перекоса, примеры – разные. Ответ сети – класс с наибольшей уверенностью.
Совет. Перед обучением посчитай примеры в каждом классе и посмотри, чем, кроме нужного признака, классы отличаются друг от друга: фоном, светом, размером картинки. Всё, чем они отличаются, сеть может принять за подсказку.
7.6. Разбираем задачи
Задача 7.1 Сколько связей в сети
Сеть по 6 признакам поездки (расстояние, погода, день недели и так далее) советует, чем добраться из Новосибирска до Академгородка: автобусом, электричкой или на машине. В сети один скрытый слой из 4 нейронов, все соседние слои полносвязные. Сколько связей (весов) в этой сети? Смещения не считай.
Дано: сеть 6–4–3, слои полносвязные.
Найти: – число связей.
Шаг 1. Выписываем слои. 6 признаков – 6 входов. Скрытый слой – 4 нейрона. Способов доехать 3 – значит, 3 выхода, по одному на класс. Сеть 6–4–3.
Шаг 2. Связи между входами и скрытым слоем. Каждый из 6 входов соединён с каждым из 4 нейронов: связи.
Шаг 3. Связи между скрытым слоем и выходами. связей.
Шаг 4. Всего. .
Прикинем. Нейронов в сети всего , а связей почти втрое больше: каждый нейрон тянет стрелки сразу к нескольким соседям. Если бы спросили параметры вместе со смещениями, добавилось бы смещений – вышло бы 43.
Типичная ошибка. Перемножить все слои подряд: . Слои соединены парами, поэтому произведения соседей складывают. Бывает и так: посчитали нейроны (), а спрашивали связи.
Ответ: 36.
Своя задача по программе сферы, модуль 5
Реши сам
7.1. Сеть 3–5–2, все соседние слои полносвязные. Сколько в ней связей (без смещений)?
ответ7.2. Сеть 8–6–6–1 (два скрытых слоя по 6 нейронов), слои полносвязные. а) Сколько в ней связей? б) Сколько всего параметров, если к связям добавить смещения? Ответ – два числа через точку с запятой.
ответ7.3.* а) Сеть 10–?–4 с одним скрытым слоем, слои полносвязные, всего 196 связей. Сколько нейронов в скрытом слое? б) В сети 10–?–?–4 два скрытых слоя с одинаковым числом нейронов, всего 312 связей. Сколько нейронов в каждом скрытом слое? (Подсказка: подставляй по очереди 10, 11, 12… и считай связи, пока не получится 312.)
ответЗадача 7.2 Сколько литров налить в грядку
Нейросеть на даче подсказывает, сколько литров воды налить в грядку. Входы: – сколько дней не было дождя, – температура днём, делённая на 10 (так сети удобнее: числа на входах одного размера). В скрытом слое два нейрона с функцией ReLU, у выхода – без изменений.
| Нейрон | Вес от | Вес от | Смещение |
|---|---|---|---|
| 2 | 1 | −3 | |
| −1 | 2 | −4 |
Выход: вес от равен 2, вес от равен 4, смещение 1. Сколько литров посоветует сеть, если дождя не было 3 дня, а днём было 25 °C?
Дано: ; ; веса и смещения – в таблице; скрытый слой – ReLU.
Найти: – ответ сети, л.
Шаг 1. Готовим входы. . Температуру по условию делим на 10: .
Шаг 2. Нейрон . . Сумма положительная, ReLU её не меняет: .
Шаг 3. Нейрон . . Сумма отрицательная, ReLU даёт ноль: .
Шаг 4. Выход. Входы выходного нейрона – ответы скрытого слоя, 5,5 и 0: . Функция «без изменений» – ответ 12 л.
Проверка кодом.
relu = lambda s: max(0, s)    # короткая запись функции: «минус – в ноль»

x1, x2 = 3, 25 / 10
h1 = relu(x1 * 2 + x2 * 1 - 3)
h2 = relu(x1 * (-1) + x2 * 2 - 4)
y = h1 * 2 + h2 * 4 + 1
print(h1, h2, y)    # 5.5 0 12.0
Прикинь по жизни: 12 литров – чуть больше ведра на грядку после трёх сухих жарких дней. Дачник примерно столько и нальёт.
Где теряют баллы. Забыли ReLU и оставили – выход л, в три раза меньше верного. И ещё: подали на вход 25 вместо 2,5, хотя в условии прямо сказано, что температуру делят на 10.
Ответ: 12 л.
Своя задача по программе сферы, модуль 5
Реши сам
7.4. Суммы трёх нейронов скрытого слоя (уже со смещением) равны −4; 0; 2,5. Функция активации – ReLU. Запиши ответы нейронов через точку с запятой.
ответ7.5. Сеть 2–2–1. Входы , . Нейрон : веса 1 (от ) и −1 (от ), смещение 0. Нейрон : веса −2 и 1, смещение 3. В скрытом слое ReLU. Выход: вес от равен 3, от равен 5, смещение −1, функция без изменений. Найди ответ сети.
ответЗадача 7.3 Когда остановить обучение
Школьники из Академгородка учат сеть различать на снимках неба три вида облаков. Каждые 5 эпох они записывали точность на обучающей и на проверочной выборке:
| Эпоха | Точность на обучении, % | Точность на проверке, % |
|---|---|---|
| 5 | 64 | 61 |
| 10 | 73 | 70 |
| 15 | 81 | 77 |
| 20 | 87 | 82 |
| 25 | 92 | 83 |
| 30 | 96 | 80 |
| 35 | 98 | 76 |
| 40 | 99 | 72 |
а) Веса после какой эпохи лучше сохранить, чтобы сеть хорошо работала на новых снимках? б) На сколько процентов точность на обучении выше точности на проверке после 40-й эпохи? Ответ запиши двумя числами через точку с запятой.
Дано: таблица точности по эпохам.
Найти: лучшую эпоху; разрыв точностей на 40-й эпохе.
Шаг 1. Какой столбец важен. Работать сеть будет на новых снимках, а «новые» – это проверочная выборка. Значит, лучшую эпоху ищем по столбцу «на проверке».
Шаг 2. Ищем максимум на проверке. 61, 70, 77, 82, 83, 80, 76, 72. Самое большое число – 83 %, эпоха 25.
Шаг 3. Что после. После 25-й эпохи точность на обучении растёт (92 → 96 → 98 → 99), а на проверке падает (83 → 80 → 76 → 72). Это переобучение: сеть начала запоминать снимки обучающей выборки.
Шаг 4. Разрыв на 40-й эпохе. процентных пунктов. Для сравнения, на 25-й эпохе разрыв был – втрое меньше.
Проверка кодом.
epohi = [5, 10, 15, 20, 25, 30, 35, 40]
obuch = [64, 73, 81, 87, 92, 96, 98, 99]
prov  = [61, 70, 77, 82, 83, 80, 76, 72]

i = prov.index(max(prov))     # номер места, где проверка лучше всего
print(epohi[i], max(prov))    # 25 83
print(obuch[-1] - prov[-1])   # 27
83 % для трёх видов облаков – совсем неплохо: если тыкать наугад, выйдет около 33 %. А вот 99 % на обучении при 72 % на проверке – это уже зубрёжка.
Типичная ошибка. Выбрать эпоху 40, потому что там «99 % – самая высокая точность». Это точность на примерах, которые сеть уже видела. Про новые снимки говорит только правый столбец.
Ответ: 25; 27.
Своя задача по программе сферы, модули 1 и 5
Реши сам
7.6. Точность модели, которая узнаёт по голосу, кто из четырёх ребят говорит:
| Эпоха | На обучении, % | На проверке, % |
|---|---|---|
| 10 | 55 | 53 |
| 20 | 68 | 65 |
| 30 | 78 | 74 |
| 40 | 85 | 79 |
| 50 | 90 | 78 |
| 60 | 94 | 75 |
| 70 | 97 | 71 |
| 80 | 99 | 68 |
а) Веса после какой эпохи лучше сохранить? б) На сколько процентов точность на обучении выше, чем на проверке, после 80-й эпохи? Ответ – два числа через точку с запятой.
ответ7.7. Верно (В) или неверно (Н)? 1) Эпоха – один проход по всем обучающим примерам. 2) Чем больше скорость обучения, тем лучше: сеть обучится и быстрее, и точнее. 3) Если точность на обучении 99 %, а на проверке 60 %, сеть переобучилась. 4) У сети, которая относит объект к одному из 4 классов, обычно 4 выхода. 5) Между полносвязными слоями из 5 и 3 нейронов 8 связей. Ответ – пять букв подряд.
ответЗадача 7.4 Подбери сеть под задачу
Есть три задачи:
- По 5 признакам погоды (температура, давление, ветер, влажность, облачность) предсказать температуру завтра в градусах.
- По чёрно-белой картинке 10 × 10 пикселей узнать, что на ней нарисовано: круг, крест или треугольник.
- По тем же 5 признакам погоды определить, что будет завтра: снег, дождь или без осадков.
И четыре сети:
- А) 5–8–1, выход без изменений;
- Б) 100–16–3;
- В) 5–8–3;
- Г) 3–16–100.
Подбери к каждой задаче сеть. Ответ запиши тремя буквами для задач 1, 2, 3.
Дано: три задачи и четыре сети.
Найти: сеть для каждой задачи.
Шаг 1. Задача 1. Признаков 5 – входов 5. Ответ – число (температура), это регрессия: один выход, число берут как есть. Подходит А (5–8–1, выход без изменений).
Шаг 2. Задача 2. Каждый пиксель – вход: входов. Классов три – выходов 3. Это Б (100–16–3).
Шаг 3. Задача 3. Входов снова 5, но ответ теперь – один из трёх классов: 3 выхода. Это В (5–8–3).
Шаг 4. Лишняя сеть. Г (3–16–100) не подходит никому: у неё 3 входа и 100 выходов – как будто картинку перепутали местами с ответом.
Заметь: у задач 1 и 3 входы одинаковые, а сети разные. Входы задают признаки, а выходы – вопрос, который мы задаём сети.
Типичная ошибка. Взять для картинки 10 входов («картинка 10 на 10») вместо . Ещё легко выбрать для задачи 3 сеть А: погода та же, но ответ теперь не число, а класс из трёх.
Ответ: АБВ.
Своя задача по программе сферы, модули 1 и 5
Реши сам
7.8. Сеть узнаёт по чёрно-белой картинке 12 × 12 пикселей одну из 5 букв. В ней один скрытый слой из 20 нейронов, слои полносвязные. Сколько у сети входов, выходов и связей? Ответ – три числа через точку с запятой.
ответ7.9. Есть три задачи: 1) по 4 признакам яблока (диаметр, цвет в баллах, твёрдость, сколько дней лежит на складе) предсказать его массу в граммах; 2) по тем же 4 признакам определить, какой из 5 сортов перед нами; 3) по чёрно-белой картинке 8 × 8 пикселей узнать, какая цифра на ней нарисована: 0 или 1. И четыре сети: А) 64–12–2; Б) 4–10–5; В) 4–10–1, выход без изменений; Г) 8–12–2. Подбери к каждой задаче сеть. Ответ – три буквы для задач 1, 2, 3.
ответЗадача 7.5 Синицы и снегири у кормушки
Ваня всю зиму фотографировал птиц у кормушки на даче и собрал в Teachable Machine два класса: «синица» – 180 фото и «снегирь» – 20 фото. Модель на всех фото отвечает «синица».
а) Какой будет точность такой модели в процентах, если проверять её на фото с тем же соотношением птиц? б) Сколько фото снегирей надо добавить, чтобы классы стали поровну? Ответ запиши двумя числами через точку с запятой.
Дано: синиц 180, снегирей 20; модель всегда отвечает «синица».
Найти: точность, %; сколько добавить снегирей.
Шаг 1. Сколько всего фото. .
Шаг 2. Сколько раз модель права. Она всегда говорит «синица» и права ровно тогда, когда на фото синица: 180 раз из 200.
Шаг 3. Точность. %.
Шаг 4. Сколько добавить. Чтобы снегирей стало столько же, сколько синиц: фото.
Проверка кодом.
sinicy, snegiri = 180, 20
print(sinicy / (sinicy + snegiri) * 100)   # 90.0
print(sinicy - snegiri)                    # 160
Вот где подвох. 90 % звучит хорошо, а ни одного снегиря модель не узнала. Виновата тут не сеть, а данные: классы сильно разные по размеру.
Типичная ошибка. Поверить цифре 90 % и решить, что модель хорошая. Когда классы сильно неравные, смотри на редкий: сколько снегирей нашла модель? Ноль. А в пункте б) часто пишут 180 – но спрашивали, сколько добавить, а не сколько должно стать.
Ответ: 90; 160.
Своя задача по программе сферы, модуль 9
Реши сам
7.10. В проекте Teachable Machine три класса: «кошка» – 150 фото, «собака» – 90, «хомяк» – 60. а) Сколько фото всего нужно добавить в меньшие классы, чтобы во всех трёх стало по 150? б) Модель на любое фото отвечает «кошка». Какой будет её точность в процентах на этих 300 фото? Ответ – два числа через точку с запятой.
ответ7.11. Настя обучила модель отличать лис от собак. Все фото лис она нашла зимние, на снегу, а все фото собак – летние, на траве. На проверочных фото, выбранных так же, точность 97 %, а на фото собаки в сугробе модель уверенно отвечает «лиса». Какая причина вероятнее всего? А) мало эпох; Б) модель научилась отличать снег от травы, а не лису от собаки; В) слишком маленькая скорость обучения; Г) слишком много классов. Ответ – одна буква.
ответ7.12. Расставь шаги работы в Teachable Machine по порядку: А) проверить модель на новых снимках, которых не было в примерах; Б) создать классы и назвать их; В) нажать «Train Model» и дождаться конца обучения; Г) снять или загрузить примеры для каждого класса; Д) выгрузить готовую модель, чтобы вставить её в свою программу. Ответ – пять букв подряд.
ответЗадача 7.6* Модель для школьного автобуса
Модель предсказывает, сколько минут школьный автобус едет по маршруту: , где – длина маршрута в километрах, – вес. Обучающие примеры: 2 км – 6 мин, 4 км – 12 мин. Начальный вес , скорость обучения . После каждого примера вес поправляют по правилу , где – ошибка (верное время минус ответ модели). В каждой эпохе примеры идут по порядку: сначала 2 км, потом 4 км. Каким станет вес после двух эпох? Округли до сотых. Калькулятор можно.
Дано: примеры и ; ; ; 2 эпохи.
Найти: после 2 эпох.
Шаг 1. Сколько поправок. Эпоха – проход по всем примерам, их два. За две эпохи – поправки. Знаков после запятой будет много, поэтому считай в столбик или на калькуляторе и после каждой поправки записывай строчку: ответ, ошибка, поправка, новый вес. Одна описка в середине – и все следующие строчки поедут.
Шаг 2. Эпоха 1, пример 2 км. Ответ модели мин. Ошибка . Поправка . Новый вес .
Шаг 3. Эпоха 1, пример 4 км. Берём уже новый вес 1,4. Ответ мин. Ошибка . Поправка . Вес .
Шаг 4. Эпоха 2, пример 2 км. Ответ . Ошибка . Поправка . Вес .
Шаг 5. Эпоха 2, пример 4 км. Ответ . Ошибка . Поправка . Вес .
Проверка кодом.
w, eta = 1, 0.05
primery = [(2, 6), (4, 12)]      # (км, минуты)

for epoha in range(1, 3):
    for s, t in primery:
        E = t - w * s
        w = w + eta * E * s
        print(epoha, s, round(w, 4))
print(round(w, 2))
# 1 2 1.4
# 1 4 2.68
# 2 2 2.744
# 2 4 2.9488
# 2.95
Вес подобрался почти к 3 – и правильно: в обоих примерах автобус тратит 3 минуты на километр. Это 20 км/ч, для школьного автобуса с остановками обычное дело.
А если взять скорость обучения побольше, ? Уже первый пример даёт вес , а второй – . Вес проскочил 3 и дальше будет качаться вокруг него. Так на числах выглядит слишком большой шаг.
Главная ловушка. Считать оба примера одной эпохи со старым весом 1: поправки 0,4 и 1,6, после первой эпохи вес 3, и ответ 3,00 – красивый, но неверный. Вес меняется после каждого примера, и следующий пример считают уже с новым весом. А кто-то делает всего две поправки: «две эпохи – два шага».
Ответ: 2,95.
Своя задача по программе сферы, модуль 5
Реши сам
7.13. В обучающей выборке 300 примеров. Сеть обучали 20 эпох и поправляла веса после каждого примера. Сколько раз она поправляла веса?
ответ7.14. Модель , вес , скорость обучения . Обучающий пример: , верный ответ . Сделай одну поправку по правилу . Каким станет вес?
ответ7.15.* Модель учат на двух примерах: , и , – в каждой эпохе по порядку. Начальный вес , скорость обучения , вес поправляют после каждого примера по правилу . Каким станет вес после двух эпох? Будь внимателен: во второй эпохе ошибка может оказаться отрицательной.
ответЗадача 7.7* Два выключателя в коридоре
В длинном коридоре лампу можно включать и выключать двумя выключателями – у одного конца и у другого. Лампой управляет маленькая нейросеть. Входы и : 1 – выключатель поднят, 0 – опущен. В скрытом слое два нейрона-ступеньки, у выхода тоже ступенька. Все нейроны отвечают 1, если сумма не меньше порога , иначе 0.
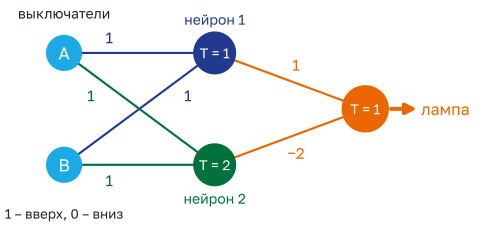
- Нейрон 1: веса от и от равны 1, порог .
- Нейрон 2: веса от и от равны 1, порог .
- Выход: вес от нейрона 1 равен 1, вес от нейрона 2 равен −2, порог . Выход 1 – лампа горит.
Горит ли лампа при положениях выключателей = (0; 0), (0; 1), (1; 0), (1; 1)? Ответ запиши четырьмя цифрами подряд в этом порядке.
Дано: сеть 2–2–1, ступеньки с порогами 1, 2 и 1; веса на рисунке.
Найти: ответ сети для четырёх наборов входов.
Шаг 1. Что делает нейрон 1. Сумма , порог 1. Он отвечает 1, если поднят хотя бы один выключатель.
Шаг 2. Что делает нейрон 2. Та же сумма , порог 2. Он отвечает 1, только если подняты оба.
Шаг 3. Считаем все четыре случая. Выход складывает и сравнивает с порогом 1.
| Сумма выхода | Лампа | ||||
|---|---|---|---|---|---|
| (0; 0) | 0 | 0 | 0 | 0 | |
| (0; 1) | 1 | 1 | 0 | 1 | |
| (1; 0) | 1 | 1 | 0 | 1 | |
| (1; 1) | 2 | 1 | 1 | 0 |
Шаг 4. Что получилось. Лампа горит, когда выключатели стоят по-разному. Щёлкнул любым – положение меняется, и лампа переключается. Так устроены выключатели в любом длинном коридоре или на лестнице.
Проверка кодом.
def stupenka(s, T):
    return 1 if s >= T else 0

for A, B in [(0, 0), (0, 1), (1, 0), (1, 1)]:
    h1 = stupenka(A + B, 1)
    h2 = stupenka(A + B, 2)
    lampa = stupenka(1 * h1 + (-2) * h2, 1)
    print(A, B, lampa)
# 0 0 0
# 0 1 1
# 1 0 1
# 1 1 0
Почему так вышло. Выход «сердится» на нейрон 2 (вес −2): когда подняты оба выключателя, он гасит лампу, хотя нейрон 1 за то, чтобы гореть. Так сеть из трёх нейронов собирает правило «ровно один из двух».
Типичная ошибка. Подать на выход исходные и вместо ответов нейронов 1 и 2. А кто потеряет минус у веса −2, получит при (1; 1) сумму , горящую лампу и ответ 0111.
Ответ: 0110.
Своя задача по программе сферы, модули 1 и 5
Для любопытных. Одному нейрону-ступеньке такое правило не под силу – вот почему нужен скрытый слой. Пусть веса , и порог . При (0; 0) лампа не горит – значит, . При (1; 0) горит – ; при (0; 1) – . Сложим: , а раз больше нуля, то , и при (1; 1) сумма тоже не меньше порога – лампа загорится. А должна погаснуть. Противоречие: ни одного подходящего набора весов нет.
Реши сам
7.16. Сеть 2–2–1 из нейронов-ступенек (ответ 1, если сумма не меньше порога , иначе 0). Нейрон 1: вес от равен 2, от равен −1, порог . Нейрон 2: вес от равен −1, от равен 2, порог . Выход: веса от нейронов 1 и 2 равны 1, порог . Что ответит сеть на входы = (0; 0), (0; 1), (1; 0), (1; 1)? Ответ – четыре цифры подряд в этом порядке.
ответ7.17.* Игрушечным светофором управляют две кнопки и (1 – нажата, 0 – нет), зелёный горит, когда сеть отвечает 1. Сеть 2–2–1 из ступенек (ответ 1, если сумма не меньше порога ). Нейрон 1: веса от и равны 1, порог . Нейрон 2: веса от и равны 1, порог . Выход: вес от нейрона 1 равен −1, от нейрона 2 равен 2, порог . Что ответит сеть на входы = (0; 0), (0; 1), (1; 0), (1; 1)? Ответ – четыре цифры подряд в этом порядке.
ответPython, диалоги и промпты
Эта глава – про разговор с компьютером. Сначала на языке Python: переменные, условия, циклы, списки и строки. Типичная олимпиадная задача по программированию – короткий код и вопрос «что он напечатает?» или «где здесь ошибка?». Потом посмотрим, как устроен разговор чат-бота: его рисуют схемой из реплик и стрелок и считают по ней ветки. А в конце научимся просить нейросеть так, чтобы она поняла с первого раза, и проверять код, который она за нас написала.
8.1. Первая программа: переменные, ввод и вывод
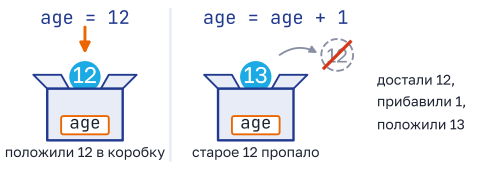
Знак = кладёт значение в коробку. Положили новое – старое пропало, в коробке всегда лежит что-то одно.
Программа – список команд для компьютера. Python выполняет их по очереди: сверху вниз, строчку за строчкой. Писать и запускать код можно в любом онлайн-интерпретаторе Python 3 (набери в поиске «Python онлайн») или в Google Colab. Интерпретатор – программа, которая читает твой код и сразу его выполняет. Ставить ничего не нужно.
Вот первая программа. Набери её сам – так запоминается лучше, чем глазами.
name = input("Как тебя зовут? ")
print("Привет,", name)
age = int(input("Сколько тебе лет? "))
print("Через 5 лет тебе будет", age + 5)
Запускаем, отвечаем на вопросы «Аня» и «12» – на экране получится разговор:
Как тебя зовут? Аня
Привет, Аня
Сколько тебе лет? 12
Через 5 лет тебе будет 17
Разберём каждую строку.
- Строка 1. Команда
input("Как тебя зовут? ")показывает вопрос и ждёт, пока человек напечатает ответ и нажмёт Enter. Напечатанное попадает в переменнуюname– ячейку памяти с именем. Знак=читается «положи в»: положи ответ в коробкуname. Это не равенство из математики, а команда. - Строка 2.
printвыводит на экран то, что стоит в скобках. Через запятую можно перечислить несколько вещей – Python поставит между ними пробел. Текст в кавычках печатается как есть. Аnameбез кавычек – имя коробки, и печатается то, что в ней лежит: Аня. - Строка 3. Здесь две команды одна в другой.
inputвсегда отдаёт текст, даже если набрали цифры: «12» для него – две буквы-цифры, а не число.int(...)превращает текст «12» в число 12. Скобки выполняются изнутри наружу: сначалаinput, потомint, потом результат кладём вage. - Строка 4. Python сначала считает
age + 5, то есть , и только потом печатает.
Имя переменной пишут латинскими буквами, цифрами и знаком _, без пробелов, и начинать его с цифры нельзя. Большие и маленькие буквы различаются: Age и age – две разные коробки. В этой книге имена – русские слова латиницей: sneg (снег), dni (дни). Так сразу видно, что в коробке.
У каждого значения есть тип – какого оно рода. Главных типов четыре:
| Тип | Что это | Как записать | Пример |
|---|---|---|---|
int |
целое число | без кавычек | 12, -30 |
float |
дробное число | через точку | 2.5, -0.7 |
str |
строка, то есть текст | в кавычках | "Аня", "12" |
bool |
«да» или «нет» | True или False |
результат сравнения 5 > 3 – это True |
От типа зависит, что делает знак +. Числа он складывает: 12 + 5 даёт 17. Строки он склеивает: "12" + "5" даёт "125". Строку можно умножить на число – она повторится: "ха" * 3 даёт "хахаха". А вот сложить строку с числом нельзя: на "5" + 3 Python остановится с ошибкой TypeError («ошибка типа»). Превратить одно в другое помогают int("5") – в целое число, float("2.5") – в дробное, str(5) – в строку.
Арифметика в Python почти школьная, только знаки другие:
| Запись | Что делает | Пример | Результат |
|---|---|---|---|
+ - * |
плюс, минус, умножить | 4 * 3 |
12 |
/ |
деление (дробное) | 7 / 2 |
3.5 |
// |
сколько раз помещается | 17 // 5 |
3 |
% |
остаток | 17 % 5 |
2 |
** |
степень | 2 ** 5 |
32 |
Обычное деление / всегда даёт дробное число, даже когда делится нацело: 6 / 2 – это 3.0. А // отвечает на вопрос, сколько раз делитель целиком помещается в числе.
Пример из жизни: 17 конфет раскладываем в пакеты по 5. Полных пакетов 17 // 5 = 3, в руке остаётся 17 % 5 = 2 конфеты. Дробную часть Python всегда пишет через точку: 3.5, а не 3,5.
В задачах «что напечатает программа» всё решает одно умение – проследить, что лежит в каждой коробке после каждой строки. Такая запись по шагам называется трассировкой. Возьмём программу:
a = 5
b = a * 2
a = a + b
print(a, b)| Строка | Код | Считаем | a |
b |
|---|---|---|---|---|
| 1 | a = 5 |
– | 5 | – |
| 2 | b = a * 2 |
5 | 10 | |
| 3 | a = a + b |
15 | 10 | |
| 4 | print(a, b) |
печать | 15 | 10 |
На экране будет 15 10. В строке 3 справа от = стоит старое значение a (5), а в коробку ложится новое (15). Старое пять пропадает навсегда.
Запомни. = кладёт значение в переменную, новое вытесняет старое. Правая часть считается целиком, а уже потом результат кладётся в коробку слева. input всегда отдаёт текст – для чисел оборачивай его в int(...).
Совет. Трассируй на бумаге: столбец на каждую переменную, строка на каждую команду. Новое значение пиши ниже, старое зачёркивай. На задачах «что напечатает программа» этот приём спасает чаще любых других.
8.2. Условия и циклы
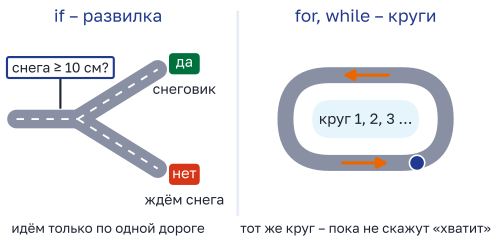
На развилке идёшь по одной дороге из двух. На стадионе бежишь один и тот же круг, пока тренер не скажет «хватит».
Без условий программа всегда делает одно и то же. Условие позволяет ей выбирать: если выпало много снега – одно, если мало – другое.
sneg = int(input("Сколько снега выпало, см? "))
if sneg >= 30:
    print("Берём лыжи")
elif sneg >= 10:
    print("Лепим снеговика")
else:
    print("Ждём снега")
if значит «если». За ним – условие, которое бывает верным или неверным, и двоеточие. Команды, которые выполняются при верном условии, пишут с отступом в 4 пробела. Отступ здесь не для красоты: по нему Python понимает, какие строки «внутри» условия. elif – «иначе если»: это условие проверяется, только если все предыдущие оказались неверными. else – «иначе»: сработает, когда не подошло ничего.
Выполняется ровно одна ветка. Введём 45: условие 45 >= 30 верно – печатается «Берём лыжи», и на этом всё. То, что 45 больше и 10 тоже, уже не важно: до elif очередь не дошла. Введём 10: первое условие неверно, второе 10 >= 10 верно – «Лепим снеговика». Введём 3 – «Ждём снега».
Знаки сравнения:
| Python | Значит | Python | Значит |
|---|---|---|---|
> |
больше | < |
меньше |
>= |
больше или равно | <= |
меньше или равно |
== |
равно (два знака!) | != |
не равно |
Условия можно соединять: and – «и» (верно, когда верны оба), or – «или» (хватит одного), not – «не». Условие «снега от 10 до 29 см» записывают так: sneg >= 10 and sneg < 30.
Цикл повторяет одни и те же команды много раз. Цикл for проходит по готовому ряду значений:
for i in range(1, 6):
    print(i, "круг")
Программа напечатает пять строк: «1 круг», «2 круг» и так до «5 круг». range(1, 6) – это ряд чисел 1, 2, 3, 4, 5: последнее число в него не входит. Переменная i на каждом круге принимает следующее значение. Ещё два вида: range(5) – это 0, 1, 2, 3, 4 (с нуля, пять чисел), а range(2, 11, 2) – 2, 4, 6, 8, 10 (третье число – шаг).
Самый частый приём с циклом – копилка: заводим переменную с нулём и на каждом круге что-то в неё добавляем.
sneg = [5, 0, 12, 3, 8]      # сколько сантиметров снега выпало за 5 дней
vsego = 0
for s in sneg:
    vsego = vsego + s
print(vsego)                 # 28
Здесь for идёт прямо по списку чисел (о списках – в следующем разделе): s по очереди становится 5, 0, 12, 3, 8. Трассировка: vsego было 0, потом , , , , . Если в копилку каждый раз добавлять не число, а единицу – получится счётчик: сколько раз что-то случилось.
Когда заранее не знаешь, сколько будет кругов, берут цикл while – «пока». Он крутится, пока условие верно:
sugrob = 20
den = 0
while sugrob < 50:
    sugrob = sugrob + 8
    den = den + 1
print(den, sugrob)           # 4 52
Сугроб в 20 см каждый день подрастает на 8 см. Через сколько дней он станет не меньше 50 см? Перед каждым кругом Python проверяет условие: 20 < 50 – круг, сугроб 28; 28 < 50 – круг, 36; 36 < 50 – круг, 44; 44 < 50 – круг, 52. Теперь неверно – цикл закончен. Напечатано 4 52. Если условие не станет неверным никогда, цикл будет крутиться бесконечно – программу придётся остановить кнопкой.
Если ты собирал программы в Scratch (в курсе сферы блоки собирают в CodeChef, а Scratch – дополнительный материал кружка), многое уже знакомо:
| Блок Scratch | Python |
|---|---|
| «спросить … и ждать», «ответ» | input() |
| «сказать …» | print() |
| «если …, то», «иначе» | if …:, else: |
| «повторить … раз» | for i in range(…): |
| «повторять пока не …» | while …: – но условие наоборот! |
Последняя строка – ловушка. Scratch крутит «повторять пока не» до тех пор, пока условие неверно. Python крутит while, пока условие верно. Блок «повторять пока не сугроб > 49» – это while sugrob < 50.
Запомни. После if, elif, else, for, while – двоеточие, а строки внутри – с отступом. Из цепочки if – elif – else выполняется только первая подходящая ветка. range(1, 6) – это 1, 2, 3, 4, 5, без шести.
Совет. В задачах с циклом выпиши таблицу «круг – значение переменной – что в копилке». Проверь первый круг и последний: на границах (> или >=, range(1, 6) или range(1, 7)) ошибаются чаще всего.
8.3. Списки, словари и строки
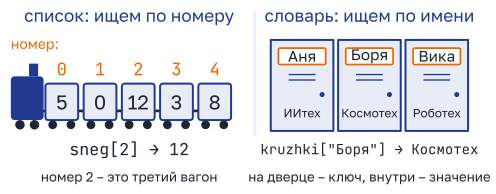
В списке ищешь по номеру вагона, и считать начинают с нуля. В словаре ищешь по подписи на дверце.
Список – много значений в одной переменной, по порядку. Его пишут в квадратных скобках через запятую. У каждого элемента есть номер (индекс) – и начинается он с нуля.
sneg = [5, 0, 12, 3, 8]
print(sneg[0])        # 5 – первый элемент
print(sneg[2])        # 12 – третий, а не второй!
print(sneg[-1])       # 8 – последний
print(len(sneg))      # 5 – сколько элементов
sneg.append(7)        # добавить 7 в конец
print(sneg)           # [5, 0, 12, 3, 8, 7]
print(sum(sneg), max(sneg), min(sneg))   # 35 12 0
print(12 in sneg)     # True – есть ли в списке 12
Почему с нуля? Номер показывает, сколько элементов надо пропустить от начала. Чтобы взять первый, пропускать не нужно ничего – номер 0. Отрицательные номера считают с конца: -1 – последний, -2 – предпоследний.
Иногда нужен сам номер, а не только значение: например, чтобы сравнить два списка элемент за элементом. Тогда цикл идёт по номерам: for i in range(len(sneg)): – i пробежит 0, 1, 2, … до последнего номера. Длина списка 6, а номера – от 0 до 5, и range(6) выдаёт как раз их.
Строка в Python похожа на список букв: у неё есть длина, номера букв (тоже с нуля) и кусочки.
gorod = "Новосибирск"
print(len(gorod))          # 11 – букв в слове
print(gorod[0], gorod[-1]) # Н к – первая и последняя
print(gorod[:4])           # Ново – первые 4 буквы
print(gorod.lower())       # новосибирск – все буквы маленькие
print(gorod.count("и"))    # 2 – сколько раз встречается «и»
print("сиб" in gorod)      # True – есть ли такой кусочек
fraza = "Снег идёт весь день"
print(fraza.split())       # ['Снег', 'идёт', 'весь', 'день']
split() режет строку по пробелам и отдаёт список слов – так программа начинает «читать» текст. По строке, как по списку, можно пройти циклом – буква за буквой. Посчитаем гласные:
slovo = "Кванториум"
glasnye = "аеёиоуыэюя"
k = 0
for bukva in slovo.lower():
    if bukva in glasnye:
        k = k + 1
print(k)                   # 4
Гласные в слове – а, о, и, у, их 4. Для «Кванториума» lower() ничего не меняет. А возьми слово «Обь»: без lower() программа не узнала бы большую «О» – в строке glasnye только маленькие буквы – и насчитала бы 0.
Словарь хранит пары «ключ – значение». Ключ – подпись на дверце шкафчика, значение – то, что внутри. Пишут в фигурных скобках: ключ, двоеточие, значение.
kruzhki = {"Аня": "ИИтех", "Боря": "Космотех"}
print(kruzhki["Аня"])            # ИИтех – достаём по ключу
kruzhki["Вика"] = "Роботех"      # новая пара
kruzhki["Боря"] = "ИИтех"        # у Бори значение заменилось
print(kruzhki)       # {'Аня': 'ИИтех', 'Боря': 'ИИтех', 'Вика': 'Роботех'}
print("Гоша" in kruzhki)         # False – in проверяет ключи
print(kruzhki.get("Гоша", "нет такого"))   # нет такого
Ключи в словаре не повторяются: если положить значение по ключу, который уже есть, старое заменится. Обращение kruzhki["Гоша"] к несуществующему ключу остановит программу с ошибкой KeyError. Безопасный способ – get: вторым значением в скобках пишут, что выдать, если ключа нет.
Со словарём удобно считать, какое слово сколько раз встретилось. Этим пользуются чат-боты и нейросети, которые работают с текстом.
tekst = "снег снег лыжи горка снег лыжи"
schet = {}
for slovo in tekst.split():
    if slovo in schet:
        schet[slovo] = schet[slovo] + 1    # слово уже было – прибавляем 1
    else:
        schet[slovo] = 1                    # встретили впервые
print(schet)               # {'снег': 3, 'лыжи': 2, 'горка': 1}
Запомни. Номера в списке и в строке начинаются с 0, последний элемент – [-1], а номер последнего равен длине минус один. Словарь ищет по ключу, ключи не повторяются. "Снег" и "снег" для Python – разные слова.
Совет. Прежде чем считать слова, приведи текст к одному виду: lower() – все буквы маленькие, replace(".", "") – убрать точки (так же для запятых). Иначе «Робот» в начале предложения и «робот» в середине посчитаются отдельно.
8.4. Диалог – это граф
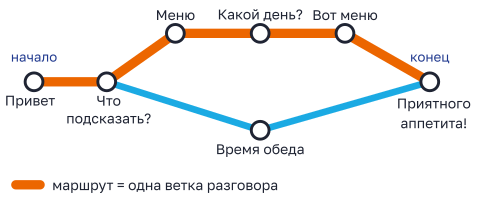
Станции – реплики бота, перегоны – переходы. Одна поездка от начала до конца – одна ветка разговора.
Чат-бот – программа, которая ведёт разговор с человеком. Перед тем как его программировать, разговор проектируют: какие реплики говорит бот и куда разговор идёт дальше после каждого ответа человека. Удобнее всего нарисовать это графом – схемой из кружков и стрелок.
- Узел (вершина) графа – одна реплика бота. Узлы нумеруют.
- Стрелка (ребро) – переход: после этой реплики разговор может пойти в эту сторону. На стрелке подписывают, что выбрал человек.
- Начало – реплика, с которой бот начинает. Конец – реплика, после которой разговор окончен.
- Ветка – путь от начала до конца по стрелкам. Одна ветка – один возможный разговор.
- Длина ветки – сколько реплик в ней. Считаем кружки, а не стрелки.
Вот бот школьной столовой. Его сценарий можно записать списком: номер реплики, что говорит бот и куда разговор идёт дальше.
- 1. «Привет! Подсказать меню или время обеда?» – «меню» → 2, «время» → 4.
- 2. «На какой день недели?» → 3.
- 3. «Вот меню на этот день.» → 5.
- 4. «Обед для 5–7 классов – в 12:15.» → 5.
- 5. «Приятного аппетита!» – конец.
А можно нарисовать – это тот же сценарий, только нагляднее:
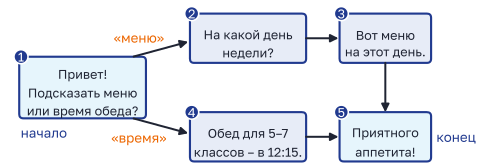
Ветки здесь две: 1 – 2 – 3 – 5 (4 реплики) и 1 – 4 – 5 (3 реплики). Обе заканчиваются одной и той же репликой 5 – ветки в графе могут сходиться. У дерева из главы 3 ветки только расходятся, а в сценарии бота они часто снова встречаются: «Приятного аппетита!» и «Пока!» говорят всем.
Как найти ветки в большом графе? Иди от начала и на каждой развилке выписывай столько цепочек, сколько стрелок выходит из узла. Каждую цепочку веди до конца. Когда ветки ещё и сходятся посередине, выписывать их долго. Есть приём быстрее: подпиши у каждого узла, сколькими путями в него можно прийти. У начала пишем 1. У любого другого узла – сумму чисел у тех узлов, из которых в него ведут стрелки. Число у конца – это и есть количество веток. Так мы решим задачу 8.6.
Как бот понимает, куда идти. Если человек нажимает кнопки, всё просто: одна кнопка – одна стрелка. Но люди пишут как хотят: «что сегодня на обед?», «покажи меню», «какой суп?». Всё это одно намерение – по-английски интент (intent): человек хочет узнать меню. Разработчик задаёт боту интенты и к каждому – десяток тренировочных фраз, а бот учится относить новую фразу к одному из интентов. Это задача классификации – та самая, из главы 1.
Ещё два слова из мира чат-ботов. Параметр – деталь, которую бот вытаскивает из фразы: в «посоветуй детектив» интент – «посоветовать книгу», а параметр «жанр» – детектив. Контекст – память бота о том, о чём сейчас разговор. Если бот только что спросил «какой жанр любишь?», то ответ из одного слова «детектив» он поймёт правильно. Без контекста слово «детектив» ему ни о чём не скажет.
В задачах НТО прошлых лет ботов собирали в сервисе Dialogflow. Там контекст – это метка-пропуск: первый интент её выдаёт («выходной контекст»), а второй срабатывает, только если метка есть («входной контекст»). И всегда нужен запасной ответ на случай, когда бот не понял ни одного интента: «Не понял, спроси по-другому». В Dialogflow для этого есть готовый интент Default Fallback Intent.
Настоящие боты учатся на примерах. А самого простого бота можно написать на Python за два десятка строк: он ищет в фразе ключевые слова.
klyuchi = {
    "меню":   ["меню", "обед", "суп", "есть"],
    "время":  ["когда", "во сколько", "время"],
    "привет": ["привет", "здравствуй"],
}
otvety = {
    "меню":   "Сегодня борщ, гречка с котлетой и компот.",
    "время":  "Обед для 5–7 классов – в 12:15.",
    "привет": "Привет! Спроси про меню или время обеда.",
}

def uznat_intent(fraza):
    fraza = fraza.lower()
    for intent, slova in klyuchi.items():   # по очереди перебираем интенты
        for slovo in slova:
            if slovo in fraza:              # нашли ключевое слово – интент готов
                return intent
    return "не понял"

for fraza in ["Привет!", "Что сегодня на обед?", "Во сколько идти в столовую?", "Какая погода?"]:
    intent = uznat_intent(fraza)
    print(fraza, "->", intent, "->", otvety.get(intent, "Не понял, спроси по-другому."))
def создаёт функцию – маленькую программу с именем, которую можно вызывать много раз. uznat_intent получает фразу и делает все буквы маленькими. Потом перебирает словарь klyuchi: items() выдаёт пары «ключ – значение», и на каждом круге в intent попадает имя интента, а в slova – его список слов. Внутренний цикл проверяет слова по одному. Как только в фразе нашёлся нужный кусочек, return сразу возвращает имя интента, и функция заканчивает работу. Не нашлось ничего – возвращается «не понял». Программа напечатает:
Привет! -> привет -> Привет! Спроси про меню или время обеда.
Что сегодня на обед? -> меню -> Сегодня борщ, гречка с котлетой и компот.
Во сколько идти в столовую? -> время -> Обед для 5–7 классов – в 12:15.
Какая погода? -> не понял -> Не понял, спроси по-другому.
Спроси этого бота «Когда будет суп?» – он ответит меню, хотя спрашивали про время. Интент «меню» проверяется первым, а слово «суп» в фразе есть. Бот видит слова, а не смысл, и порядок проверки для него важен.
Запомни. Узел – реплика, стрелка – переход, ветка – путь от начала до конца. Длина ветки – число реплик в ней. Число веток = число у конца, если подписать у каждого узла сумму чисел узлов, из которых в него входят стрелки. Интент – намерение человека, которое бот узнаёт по фразе.
Совет. Перед подсчётом прочитай, как в задаче определена длина: реплики или переходы. Переходов всегда на один меньше, чем реплик. Выписывай каждую ветку полностью, номерами через дефис, и зачёркивай на рисунке пройденные стрелки.
8.5. Промпт: как попросить нейросеть
«Купи что-нибудь» – и он принесёт чипсы. Чем точнее записка, тем меньше приходится угадывать.
Промпт – запрос к нейросети словами. Нейросетевые чаты вроде GigaChat, Алисы или DeepSeek (с ними работают в модуле 8 программы сферы) отвечают на любой вопрос. Но они не знают, кто ты, зачем спрашиваешь и какой ответ тебе нужен. Всё, что ты не написал, нейросеть додумает сама – и не обязательно так, как хотел ты.
В программе сферы хороший промпт собирают из пяти частей:
- Контекст и роль – кем нейросеть должна быть и что она должна знать о тебе и о ситуации. Пример: «Ты – учитель информатики, который объясняет шестиклассникам. Я только начал учить Python.» Роль – это «кем быть», контекст – «для кого и зачем»; в курсе их держат в одной части.
- Цель – что именно сделать. Пример: «Напиши программу на Python, которая считает, сколько всего снега выпало за эти дни и сколько в среднем за день.»
- Исходные данные и детали – с чем работать: сами данные и важные подробности о них. Пример: «Я веду дневник снега: каждый вечер записываю, сколько сантиметров выпало. Числа – в одну строку через пробел.»
- Инструменты и ограничения – чем можно пользоваться и чего нельзя. Пример: «Без дополнительных библиотек, только
input,splitиsum.» - Формат результата – в каком виде нужен ответ. Пример: «Дай только код, а под ним – по одной строке пояснения к каждой строке кода.»
Сравни с промптом «напиши код про снег». Нейросеть не знает, что считать: сумму, среднее, самый снежный день или прогноз погоды. Не знает, в каком виде у тебя числа. Может подключить библиотеку, которой у тебя нет, и объяснить словами, которых ты не знаешь. Ответ будет, но, скорее всего, не тот.
| Плохой промпт | Хороший промпт | |
|---|---|---|
| Текст | «напиши код про снег» | все пять частей из списка выше |
| Что нейросети приходится угадывать | что считать, в каком виде данные, для кого объяснение, нужен ли код целиком | почти ничего |
| Что получаем | что-то «про снег», часто длинное и не то | короткий код, который можно проверить на своих числах |
Как понять, что ответ хороший? Проверь три вещи. Учтено ли всё, что ты написал: и сумма, и среднее, и без лишних библиотек. Логичен ли ответ: нет ли в нём противоречий и слов, которые ни к чему не относятся. Работает ли он: код – запусти, числа – пересчитай, факты – найди в надёжном источнике. Если что-то не так, не начинай заново, а уточни: «в твоём коде среднее считается неверно, если в какой-то день было 0 см, исправь». Разговор с нейросетью – это тоже диалог, и она помнит, что было в нём раньше.
Нейросеть может ошибаться – и очень уверенно. Языковая модель подбирает самое правдоподобное продолжение текста (как в задаче 3.7 из главы 3), а не ищет правду в справочнике. Поэтому она может выдумать книгу, которой нет, перепутать дату или сослаться на функцию Python, которой не существует, – и всё это гладким, убедительным языком. Такую выдумку называют галлюцинацией нейросети. На тот же вопрос в другой раз она может ответить по-другому.
Правила безопасности, которые не обсуждаются:
- не пиши в чат своё полное имя, адрес, телефон, номер школы и класса, пароли, не загружай фото документов;
- важные факты (даты, цифры, медицинские и денежные советы) проверяй в надёжных источниках или у взрослых;
- пользуйся ИИ-чатами вместе со взрослым – у сервисов есть свои правила о возрасте пользователей.
Запомни. Промпт = контекст и роль + цель + исходные данные + ограничения + формат. Чего не написал – нейросеть додумает сама. Любой ответ нейросети – черновик, пока ты его не проверил.
Совет. Попробуй сам на одном вопросе: сначала короткий промпт в одну строку, потом полный из пяти частей. Сравни ответы: какой короче, понятнее, какой выполнил всё, что ты просил.
8.6. Вайбкодинг: код от нейросети и его проверка
Нейросеть пишет код быстро, но проверяешь его ты. Запускать в работу можно только то, что прошло проверку.
Вайбкодинг – способ писать программы, когда код по твоему описанию словами пишет нейросеть, а ты проверяешь и поправляешь. Порядок работы такой же, как в программе сферы: сформулировать промпт → получить ответ → проверить и исправить → и только потом запускать программу в дело.
Чтобы проверить код, мало на него посмотреть. Его надо запустить на тесте – таком примере, где ответ ты заранее знаешь сам. Для дневника снега подойдут три дня: 4, 0 и 11 см. Сумма см, среднее см. Код должен выдать то же самое. Допустим, нейросеть ответила так:
dni = input().split()
summa = 0
for d in dni:
    summa = summa + d
print(summa / len(dni))
Вводим 4 0 11 – и программа падает:
TypeError: unsupported operand type(s) for +: 'int' and 'str'Сообщение означает: «не умею складывать целое число (int) со строкой (str)». split() дал список строк ['4', '0', '11'], а строку к числу не прибавить. Исправляем строку 4: summa = summa + int(d). Запускаем снова – получаем 5.0. Это наши 5 см, тест пройден.
Ошибки в коде бывают трёх видов, от безобидных к опасным:
| Вид | Как выглядит | Пример |
|---|---|---|
| Программа не запускается | Python сразу пишет SyntaxError и строку |
забыто двоеточие после if |
| Программа падает на ходу | TypeError, NameError, KeyError |
строку сложили с числом, опечатка в имени переменной |
| Программа работает, но считает не то | ошибок нет, ответ неверный | цикл пропустил первый элемент, > вместо >= |
Третий вид самый коварный: на экране аккуратное число, и хочется ему поверить. Ловит такие ошибки только тест. Хорошие тесты – маленькие и с подвохом: пустой ввод, один день, одинаковые числа, ноль, отрицательные числа (температура зимой).
Запомни. Код от нейросети проверяют запуском на тестах, где ответ известен заранее. Падение программы – это подсказка, где искать. Самая опасная ошибка – когда программа работает и выдаёт правдоподобное неверное число.
Совет. Попроси нейросеть объяснить код построчно – и сверь объяснение с тем, что код делает на самом деле. Если в коде есть строка, которую ты не можешь объяснить, не запускай его в дело, пока не разберёшься.
8.7. Разбираем задачи
Задача 8.1 Сколько снеговиков
Программа спрашивает, сколько снеговиков слепили вчера и сколько сегодня:
vchera = input()
segodnya = input()
print(vchera + segodnya)
print(int(vchera) + int(segodnya))
vsego = int(vchera) * 2
vchera = vsego - int(segodnya)
print(vchera, vsego)
Пользователь ввёл сначала 7, потом 5. Запиши, что появится на экране: три строки.
Дано: код из 7 строк; ввод 7, затем 5.
Найти: три строки вывода.
Шаг 1. Что лежит в переменных после ввода. input отдаёт текст. В vchera лежит строка "7", в segodnya – строка "5". Не числа!
Шаг 2. Строка 3. "7" + "5" – это склейка строк: "75". Первая строка вывода – 75.
Шаг 3. Строка 4. Здесь обе строки превращены в числа: . Вторая строка вывода – 12.
Шаг 4. Строки 5–6, трассировка.
| Строка | Считаем | vchera |
segodnya |
vsego |
|---|---|---|---|---|
| 5 | "7" |
"5" |
14 | |
| 6 | 9 | "5" |
14 |
В строке 6 в vchera кладут новое значение – теперь это число 9, а строка "7" пропала.
Шаг 5. Строка 7. Печатаем vchera и vsego через пробел: 9 14.
Прикинем на глаз: 12 снеговиков за два дня – обычная работа для двора. А 75 – явно не сумма, а две цифры, приставленные друг к другу: так + обходится со строками.
Типичная ошибка. Написать в первой строке 12: не заметить, что input отдаёт текст. А в последней строке легко напечатать 7 14, забыв, что строка 6 заменила значение vchera.
Ответ: 75, 12, 9 14.
Своя задача по программе сферы, модуль 3
Реши сам
8.1. Что напечатает программа? Запиши два числа через пробел.
x = 4
y = x * 3
x = y - x
print(x, y)8.3. На экскурсию в планетарий едут 58 школьников. В один микроавтобус садится 12 человек. Что напечатает print(58 // 12, 58 % 12)? Сколько микроавтобусов нужно заказать, чтобы поехали все?
Задача 8.2 Снежные дни
Метеостанция в Академгородке 8 дней подряд записывала, сколько сантиметров снега выпало за день. Программа ищет снежные дни:
sneg = [3, 0, 12, 7, 0, 15, 5, 9]
dni = 0
vsego = 0
for s in sneg:
    if s > 5:
        dni = dni + 1
        vsego = vsego + s
print(dni, vsego)
Что напечатает программа? Запиши два числа через пробел.
Дано: список из 8 чисел; условие s > 5.
Найти: значения dni и vsego в конце.
Шаг 1. Что делает программа. Цикл по очереди берёт каждое число списка. Если оно больше 5, программа прибавляет 1 к счётчику dni и само число – к копилке vsego. Обе строки внутри if имеют одинаковый отступ, значит, выполняются вместе и только при верном условии.
Шаг 2. Трассировка.
| Круг | s |
s > 5? |
dni |
vsego |
|---|---|---|---|---|
| 1 | 3 | нет | 0 | 0 |
| 2 | 0 | нет | 0 | 0 |
| 3 | 12 | да | 1 | 12 |
| 4 | 7 | да | 2 | 19 |
| 5 | 0 | нет | 2 | 19 |
| 6 | 15 | да | 3 | 34 |
| 7 | 5 | нет | 3 | 34 |
| 8 | 9 | да | 4 | 43 |
Шаг 3. Вывод. После цикла dni = 4, vsego = 43. Печать через пробел: 4 43.
Без таблицы то же видно сразу: больше 5 см выпало в четыре дня – 12, 7, 15 и 9 см, вместе . Почти полметра снега за четыре дня – для обычной недели многовато, но в сильный снегопад так и бывает.
Чаще всего день с 5 см тоже записывают в снежные и получают 5 48. Условие s > 5 строгое: 5 не больше 5. Было бы s >= 5 – тогда да.
Ответ: 4 43.
Своя задача по программе сферы, модуль 3
Реши сам
8.4. В школьной игре «Снежный квест» за баллы дают значки. Что напечатает программа, если ввести 73?
bally = int(input())
if bally >= 85:
    print("золотой значок")
elif bally >= 70:
    print("серебряный значок")
elif bally >= 50:
    print("бронзовый значок")
else:
print("значок участника")8.5. Что напечатает программа? Запиши одно число.
k = 0
for i in range(1, 6):
    k = k + i * 2
print(k)8.6. В копилке 150 рублей. Каждую неделю туда кладут 40 рублей. Что напечатает программа? Запиши два числа через пробел.
kopilka = 150
nedeli = 0
while kopilka < 400:
    kopilka = kopilka + 40
    nedeli = nedeli + 1
print(nedeli, kopilka)Задача 8.3 Отзыв о роботе
Программа разбирает отзыв о школьном роботе-пылесосе:
otzyv = "Робот быстрый. Робот умный, но робот шумный"
slova = otzyv.lower().replace(".", "").replace(",", "").split()
schet = {}
for w in slova:
    if w in schet:
        schet[w] = schet[w] + 1
    else:
        schet[w] = 1
print(len(slova), len(schet), schet["робот"])
Что она напечатает? Запиши три числа через пробел.
Дано: строка отзыва; цепочка lower, replace, split; словарь-счётчик.
Найти: длину списка slova, число ключей в schet, значение schet["робот"].
Шаг 1. Строка 2 по шагам, слева направо. lower() делает все буквы маленькими: «робот быстрый. робот умный, но робот шумный». Первый replace убирает точку, второй – запятую: «робот быстрый робот умный но робот шумный». split() режет по пробелам:
['робот', 'быстрый', 'робот', 'умный', 'но', 'робот', 'шумный']
В списке 7 слов: len(slova) = 7.
Шаг 2. Словарь-счётчик. Идём по словам. «робот» – впервые, ставим 1. «быстрый» – 1. «робот» – уже есть, стало 2. «умный» – 1. «но» – 1. «робот» – 3. «шумный» – 1. Получилось: {'робот': 3, 'быстрый': 1, 'умный': 1, 'но': 1, 'шумный': 1}.
Шаг 3. Ответ по частям. Разных слов (ключей) – 5. «робот» встретилось 3 раза. Печать: 7 5 3.
Сложи все значения словаря: – столько же, сколько слов в списке. Каждое слово попало в счётчик один раз, ни одно не потерялось.
Типичная ошибка. Забыть про lower() и решить, что «Робот» и «робот» – разные слова. Тогда выйдет 7 6 1: в словаре отдельно «Робот» (2 раза) и «робот» (1 раз). Тот же 7 6 1 напечатает и сама программа, если убрать из неё lower(). Красной надписи не будет – просто неверные числа.
Ответ: 7 5 3.
Своя задача по программе сферы, модули 3 и 8
Реши сам
8.7. Что напечатает программа? Две строки.
a = [10, 20, 30, 40, 50]
print(a[1], a[-1], len(a))
a.append(60)
print(sum(a))8.8. Что напечатает программа? Запиши четыре значения через пробел.
s = "Академгородок"
print(len(s), s[0], s[-2], s.count("о"))8.9. Возьми бота столовой из раздела 8.4 (функция uznat_intent со словарём klyuchi). Человек пишет: «Во вторник автобус в шесть?» Какой интент выберет бот: «меню», «время», «привет» или «не понял»? Почему?
Задача 8.4 Бот-огородник
Для дачников сделали чат-бота с советами, что посадить. Сценарий разговора нарисовали графом: узлы – реплики бота, стрелки – переходы. Разговор всегда начинается с реплики 1 и заканчивается репликой 18.
Сколько веток у диалога? Какая длина у самой длинной и у самой короткой ветки? Длина ветки – число реплик в ней, включая первую и последнюю. Запиши три числа через пробел.
Дано: граф из 18 узлов; начало – 1, конец – 18.
Найти: число веток; наибольшую и наименьшую длину ветки.
Шаг 1. Идём от начала. Из 1 одна стрелка – в 2. Из 2 выходят три: «овощи» (3), «ягоды» (10), «цветы» (15). Значит, разговор делится минимум на три части. Больше всего развилок у «овощей», с них и начнём.
Шаг 2. Ветка «овощи». Из 3 две стрелки: «теплица» (4) и «грядка» (8). Из 4 ещё две: «томаты» (5) и «огурцы» (7). Получаем три цепочки: через 5, через 7 и через 8.
Шаг 3. Выписываем все ветки до конца и считаем в каждой реплики:
- 1-2-3-4-5-6-17-18 – 8 реплик;
- 1-2-3-4-7-17-18 – 7 реплик;
- 1-2-3-8-9-17-18 – 7 реплик;
- 1-2-10-11-12-13-14-17-18 – 9 реплик;
- 1-2-15-16-17-18 – 6 реплик.
Шаг 4. Считаем. Веток 5. Самая длинная – ветка «ягоды», 9 реплик. Самая короткая – «цветы», 6 реплик.
Пересчитаем по развилкам. «Теплица» делится на томаты и огурцы – 2 ветки, «грядка» – 1, значит, у «овощей» ветки. У «ягод» и «цветов» по одной. Всего , как и в списке. Реплики 17 и 18 есть в каждой ветке: прощается бот со всеми одинаково.
Типичная ошибка. Считать не реплики, а стрелки: тогда выйдет «5 8 5» – на единицу меньше. А кто не заметил развилку в узле 4, насчитает 4 ветки.
Ответ: 5 9 6.
По мотивам задачи отборочного этапа НТО Junior 2023/24 «Диалоги»
Реши сам
8.10. Сценарий бота-библиотекаря задан стрелками: 1 → 2, 1 → 3; 2 → 4, 2 → 5; 3 → 6; 4 → 7; 5 → 8; 6 → 9; 7 → 10; 8 → 9; 9 → 10. Начало – реплика 1, конец – реплика 10. Сколько веток у диалога, какая длина самой длинной и самой короткой ветки (длина – число реплик)? Запиши три числа через пробел.
ответ8.11. Сценарий бота «Кинозал» задан стрелками: 1 → 2, 1 → 3; 2 → 4, 2 → 5, 2 → 6; 3 → 7; 4 → 8; 5 → 8; 6 → 10; 7 → 9; 8 → 9; 9 → 10. Начало – реплика 1, конец – реплика 10. В этой задаче длина ветки – число переходов (стрелок), а не реплик. Сколько веток у диалога, какая длина самой длинной и самой короткой ветки? Запиши три числа через пробел.
ответЗадача 8.5 Собери промпт
Шестиклассник Миша хочет, чтобы нейросеть объяснила ему цикл. Он написал пять кусочков промпта:
- А. «Вот мой список оценок: 5, 4, 5, 3, 5. Нужно посчитать, сколько в нём пятёрок.»
- Б. «Ответ – не длиннее 15 строк, в конце дай 2 задачи для проверки с ответами.»
- В. «Ты – терпеливый учитель информатики. Я учусь в 6 классе и только начал учить Python.»
- Г. «Объясни, как работает цикл for в Python.»
- Д. «Пользуйся только циклом for и обычными переменными, без готовых функций вроде count.»
а) Сопоставь кусочки с пятью частями промпта: контекст и роль, цель, исходные данные и детали, инструменты и ограничения, формат результата.
б) Миша отправил все пять кусочков. Нейросеть ответила на три экрана, но хорошо и понятно. Какой кусочек она не выполнила? Запиши букву.
в) Кусочек, который отвечает на вопрос «что сделать», – какой? Без какого кусочка промпт вообще нельзя отправлять?
Дано: 5 кусочков промпта; 5 частей структуры.
Найти: соответствие; невыполненный кусочек; обязательный кусочек.
Шаг 1. Ищем контекст и роль. Кусочек В начинается с «Ты – …» (это роль) и рассказывает, кто спрашивает и что уже знает (это контекст). Обе половинки – одна часть.
Шаг 2. Ищем цель. Цель – «что сделать», в ней обычно есть глагол-просьба: «объясни», «напиши», «посчитай». Это кусочек Г.
Шаг 3. Ищем исходные данные. Данные – то, с чем нейросеть будет работать: конкретный список оценок. Это кусочек А.
Шаг 4. Ищем ограничения. Ограничения говорят, чем можно пользоваться, а чем нет: «только цикл for, без count». Это кусочек Д.
Шаг 5. Формат. Остался Б: он отвечает на вопрос «в каком виде ответ» – длина и что добавить в конце.
Шаг 6. Что не выполнено. Три экрана – это явно больше 15 строк. Нарушен формат, кусочек Б.
Шаг 7. Без чего нельзя. Без остальных частей ответ будет хуже, но будет. Без цели нейросеть просто не узнает, что от неё хотят. Обязательный кусочек – Г.
Легко принять А за цель: там тоже есть «нужно посчитать». Но цель – что сделать нейросети (объяснить цикл), а в А Миша даёт материал, с которым она будет работать. Это исходные данные.
Ответ: а) А – исходные данные и детали, Б – формат результата, В – контекст и роль, Г – цель, Д – инструменты и ограничения; б) Б; в) Г.
Своя задача по программе сферы, модуль 8
Реши сам
8.12. Дима написал промпт: «Ты – опытный тренер по лыжам. Составь мне план тренировок на неделю. Сделай таблицу: день, что делать, сколько минут». Нейросеть предложила по две тренировки в день по 90 минут – а Диме 11 лет, и он встал на лыжи месяц назад. Какой части промпта не хватило: контекста и роли, цели, исходных данных и деталей, инструментов и ограничений или формата результата?
ответ8.13. Шестиклассница Оля просит нейросеть помочь с каникулами и пишет пять кусочков промпта:
- А. «Сделай список из 5 пунктов, в каждом – не больше одной строки.»
- Б. «Придумай, чем заняться на зимних каникулах дома.»
- В. «Ты – вожатый в детском лагере. Мне 12 лет, на каникулах я буду дома с младшей сестрой, ей 6 лет.»
- Г. «Дома есть конструктор, краски и три настольные игры.»
- Д. «Ничего не покупать и не выходить из дома.»
а) Сопоставь кусочки с частями промпта: контекст и роль, цель, исходные данные и детали, инструменты и ограничения, формат результата.
б) Нейросеть ответила длинным рассказом на целую страницу. Какой кусочек она не выполнила? Запиши букву.
Задача 8.6* Бот «Выходной»
Бот помогает спланировать субботу. Его сценарий – граф из 10 реплик, начало – реплика 1, конец – реплика 10. Ветки здесь не только расходятся, но и сходятся посередине: например, в реплику 6 можно прийти и из 2, и из 3.
а) Сколько разных разговоров (веток от 1 до 10) может получиться? б) Сколько из них проходят через реплику 6? Запиши два числа через пробел.
Дано: стрелки: 1 → 2, 3, 4; 2 → 5, 6; 3 → 6, 7; 4 → 7; 5 → 8; 6 → 8, 9; 7 → 9, 10; 8 → 10; 9 → 10.
Найти: число веток от 1 до 10; число веток через 6.
Шаг 1. Почему не перемножить. Из разных узлов выходит разное число стрелок, и ветки сливаются. Правило умножения из главы 3 здесь не работает. Выписывать все ветки подряд можно, но легко одну потерять или посчитать дважды.
Шаг 2. Подписываем узлы. У начала пишем 1. Дальше идём слева направо: у каждого узла – сумма чисел у узлов, из которых в него ведут стрелки. Смотрим, откуда стрелки входят в узел, а не куда выходят.
| Узел | Откуда входят стрелки | Число путей |
|---|---|---|
| 1 | – (начало) | 1 |
| 2 | 1 | 1 |
| 3 | 1 | 1 |
| 4 | 1 | 1 |
| 5 | 2 | 1 |
| 6 | 2, 3 | |
| 7 | 3, 4 | |
| 8 | 5, 6 | |
| 9 | 6, 7 | |
| 10 | 7, 8, 9 |
Всего веток – число у конца: 9.
Шаг 3. Ветки через 6. Каждая такая ветка состоит из двух кусков: от 1 до 6 и от 6 до 10. До 6 можно дойти 2 путями (это число у узла 6). От 6 до 10 – тоже 2 пути: 6-8-10 и 6-9-10. Любой первый кусок подходит к любому второму, поэтому перемножаем: .
Шаг 4. Проверяем программой. Сценарий запишем словарём: ключ – номер реплики, значение – список, куда из неё ведут стрелки. Номера узлов идут так, что стрелки ведут только от меньшего к большему, поэтому можно пройти узлы по порядку и «раздать» каждое число вперёд по стрелкам.
perehody = {1: [2, 3, 4], 2: [5, 6], 3: [6, 7], 4: [7], 5: [8],
            6: [8, 9], 7: [9, 10], 8: [10], 9: [10], 10: []}
puti = {}
for u in range(1, 11):
    puti[u] = 0
puti[1] = 1                      # в начало – один путь
for u in range(1, 11):           # узлы по порядку, слева направо
    for v in perehody[u]:        # по каждой стрелке из u
        puti[v] = puti[v] + puti[u]
print(puti)
print("всего веток:", puti[10])  # всего веток: 9
Программа печатает те же числа, что в таблице: {1: 1, 2: 1, 3: 1, 4: 1, 5: 1, 6: 2, 7: 2, 8: 3, 9: 4, 10: 9}.
Для недоверчивых – все ветки подряд: 1-2-5-8-10, 1-2-6-8-10, 1-2-6-9-10, 1-3-6-8-10, 1-3-6-9-10, 1-3-7-9-10, 1-3-7-10, 1-4-7-9-10, 1-4-7-10. Их девять, и через 6 идут четыре, со второй по пятую.
Типичная ошибка. Сложить стрелки, выходящие из узлов, или перемножить развилки: Ещё одна частая ошибка – при подписи узла брать числа у узлов, куда ведут стрелки, а не откуда. В пункте б) ошибаются, складывая – здесь случайно вышло то же число, но правильное действие – умножение: первый кусок и второй кусок.
Ответ: 9 4.
Своя задача по программе сферы, модуль 10
Реши сам
8.14.* Сценарий бота «Экскурсия» задан стрелками: 1 → 2, 1 → 3; 2 → 4, 2 → 5; 3 → 5, 3 → 6; 4 → 7; 5 → 7, 5 → 8; 6 → 8; 7 → 9; 8 → 9. Начало – 1, конец – 9. Сколько разных веток от 1 до 9? Сколько из них проходят через реплику 5? Запиши два числа через пробел.
ответ8.15.* Сценарий бота «Кружки» задан стрелками: 1 → 2, 1 → 3, 1 → 4; 2 → 5; 3 → 5, 3 → 6; 4 → 6; 5 → 7, 5 → 8; 6 → 7; 7 → 8. Начало – реплика 1, конец – реплика 8. а) Сколько разных веток от 1 до 8? б) Сколько из них не проходят через реплику 7? Запиши два числа через пробел.
ответЗадача 8.7* Нейросеть проверяет нейросеть
Нейросеть разметила 12 отзывов о школьной столовой: «+» – отзыв хороший, «−» – плохой. Учитель разметил те же отзывы сам. Чтобы узнать точность нейросети, Катя попросила другую нейросеть: «Ты – программист на Python. У меня два списка одинаковой длины: правильные метки и метки нейросети. Напиши программу, которая печатает точность в процентах». Ответ:
uchitel = ["+", "-", "+", "+", "-", "+", "-", "-", "+", "+", "-", "+"]
model   = ["+", "-", "+", "-", "-", "+", "-", "+", "+", "+", "-", "-"]
sovpalo = 0
for i in range(1, len(uchitel)):
    if uchitel[i] == model[i]:
        sovpalo = sovpalo + 1
print(sovpalo / len(uchitel) * 100)
а) Какое число напечатает программа? б) Какова настоящая точность нейросети? Округли до целого процента. в) Какую строку и как нужно исправить?
Дано: 12 пар меток; код из 7 строк.
Найти: вывод программы; настоящую точность, %; исправление.
Шаг 1. Настоящая точность – сначала руками. Сравниваем списки по парам, номера с 0. Выпишем их друг под другом:
номер:      0   1   2   3   4   5   6   7   8   9   10  11
учитель:    +   −   +   +   −   +   −   −   +   +   −   +
нейросеть:  +   −   +   −   −   +   −   +   +   +   −   −
совпало?    да  да  да  нет да  да  да  нет да  да  да  нет
Не совпали номера 3, 7 и 11 – три пары. Совпало . Точность – доля верных ответов: .
Шаг 2. Что делает код. Цикл идёт по range(1, len(uchitel)), то есть range(1, 12): номера 1, 2, …, 11. Номер 0 пропущен! Пара номер 0 совпадает («+» и «+»), но программа её не видит и насчитает sovpalo = 8. Делит она при этом на все 12: Python напечатает 66.66666666666666.
Шаг 3. Исправление. В строке 4 цикл должен начинаться с нуля: for i in range(len(uchitel)): (или range(0, len(uchitel))). После исправления программа печатает 75.0 – как у нас руками.
Похоже ли на правду? 75 % – это ошибка в каждом четвёртом отзыве: 3 из 12. Для коротких отзывов, где бывает ирония, вполне. А 66,7 % с ручным подсчётом не совпало – на этом программа и попалась.
Самое опасное здесь – поверить программе: она не упала, число аккуратное. Это третий, самый коварный вид ошибок из раздела 8.6. Заметь: если бы пара номер 0 не совпадала, программа выдала бы правильный ответ, и ошибка спряталась бы. Поэтому тест хорошо составлять так, чтобы первый и последний элементы что-то меняли в ответе.
Ответ: а) 66.66666666666666 (то есть 66,7 %); б) 75 %; в) строка 4: for i in range(len(uchitel)): – цикл должен начинаться с 0.
Своя задача по программе сферы, модуль 8
Реши сам
8.16. Нейросеть разложила 25 вопросов читателей по трём интентам. Проверка показала: в 4 случаях она выбрала не тот интент. Какова точность нейросети в процентах?
ответ8.17.* Нейросеть написала программу, которая ищет самую высокую температуру за неделю:
temp = [-12, -7, -15, -9, -21, -8, -10]
maks = 0
for t in temp:
    if t > maks:
        maks = t
print(maks)
а) Что напечатает программа? б) Какой ответ правильный? в) Какую строку нужно исправить и как, чтобы программа работала для любого списка?
ответОтветы и решения
Сначала реши задачу сам и только потом сверяйся. Не сошлось – найди в решении шаг, на котором твой путь разошёлся с нашим.
К главе 1. Что такое искусственный интеллект
1.1. Ответ: 2132.
Подсказка: в пункте г) число людей – величина, а не номер класса.
1.2. Ответ: 246.
Подсказка: про каждое устройство спроси: оно выполняет правило, которое записал человек, или научилось на примерах?
1.3. Ответ: удалить «Фамилия», «Номер в журнале», «Прошёл в финал»; тип – классификация.
к условию1.4. Ответ: ГБДАВ.
к условию1.5. Ответ: а) 70 %; б) 2 раза.
Подсказка: здесь спрашивают про ложные тревоги, а не про пропуски: день, когда снег был, а модель его не обещала, в пункт б) не входит.
1.6. Ответ: а) 97 %; б) 12.
Подсказка: «ленивая» модель права про каждый неопасный астероид и ошибается про каждый опасный.
1.7. Ответ: у модели А средняя ошибка 1,8 °C, у модели Б – 1,2 °C; лучше модель Б.
Подсказка: ошибки складывай без знака минус, иначе промах вверх и промах вниз дадут ноль.
1.8. Ответ: 100.
Подсказка: мороз −30 °C сильнее, чем −25 °C, так что во второй день вход «мороз» равен 1.
1.9. Ответ: , выход 1.
Подсказка: входы здесь не 0 и 1, а дробные числа; сумма вышла ровно на пороге – по условию это выход 1.
1.10. Ответ: 300.
к условию1.11. Ответ: 36.
Подсказка: спрашивают число ошибок, а не верных ответов: доля ошибок %.
1.12. Ответ: 86 %.
к условию1.13. Ответ: ВННВН.
Подсказка: в утверждении 5 вспомни, зачем нужна проверочная выборка.
1.14. Ответ: 4 значения, от 20 до 23.
к условию1.15. Ответ: ; на входы выход 1.
Подсказка: здесь неизвестен вес, а не порог: из каждого примера получи неравенство для .
К главе 2. Множества и логика
2.1. Ответ: 5 учеников.
Подсказка: задача «наоборот»: сначала найди, сколько учеников любят хотя бы один предмет, а потом – пересечение.
2.2. Ответ: 7; 17.
Подсказка: общая часть не больше меньшей группы, а хотя бы в одну секцию ходят не больше 30 человек – весь класс.
2.3. Ответ: 10.
к условию2.4. Ответ: , .
Подсказка: общие – числа, которые делятся и на 2, и на 3.
2.5. Ответ: 3 мультфильма.
к условию2.6. Ответ: 10.
Подсказка: сначала найди общую часть, потом вычти её из .
2.7. Ответ: 2700 страниц.
Подсказка: неизвестно одно из множеств, а пересечение дано – вырази из формулы; пересечение здесь прибавляют.
2.8. Ответ: БАГВ.
к условию2.9. Ответ: 1345.
к условию2.10. Ответ: 0.
к условию2.11. Ответ: 2 школьника.
к условию2.12. Ответ: 22 записи.
Подсказка: из каждой пары вычти центр – записи с тремя метками входят во все три пары.
2.13. Ответ: 4.
Подсказка: раздели перебор на два случая: и .
2.14. Ответ: 3.
Подсказка: «НЕ ( чётное)» – это « нечётное».
К главе 3. Комбинаторика и вероятность
3.1. Ответ: 1000.
Подсказка: цифры на колёсиках могут повторяться – код 555 тоже годится.
3.2. Ответ: 24.
к условию3.3. Ответ: 20.
к условию3.4. Ответ: 27.
к условию3.5. Ответ: 720.
к условию3.6. Ответ: 18.
Подсказка: посчитай все порядки и вычти те, где Петя первый.
3.7. Ответ: 336.
Подсказка: считай по местам, но остановись на третьем – медалей три, а команд восемь.
3.8. Ответ: 21.
Подсказка: партия Ани с Борей и партия Бори с Аней – одна и та же.
3.9. Ответ: 33 %.
Подсказка: «больше 4» – это 5 и 6, сама четвёрка не подходит.
3.10. Ответ: 60 %.
к условию3.11. Ответ: 17 %.
к условию3.12. Ответ: 87,5 %.
Подсказка: проще через противоположное событие – «ни одного орла» бывает только одним способом.
3.13. Ответ: около 650 раз.
Подсказка: сначала найди частоту в опыте, потом умножь её на число новых бросков.
3.14. Ответ: около 30 ошибок.
Подсказка: спрашивают про ошибки, а не про верные ответы.
3.15. Ответ: лиса – 10 %, модель назовёт «кошка».
Подсказка: вероятности всех классов вместе дают 100 %.
3.16. Ответ: «вечером дома», 32 %.
к условию3.17. Ответ: 48 %.
Подсказка: «отлично» встречается в трёх фразах – найди вероятность каждой и сложи.
К главе 4. Закономерности, последовательности, уравнения
4.1. Ответ: 1.
Подсказка: ряд убывает, но разности разные – проверь отношения: каждый раз делим на 3.
4.2. Ответ: 63.
Подсказка: разности 2, 4, 8, 16 сами растут не на одно и то же, а удваиваются.
4.3. Ответ: на 8-й день.
Подсказка: это ряд с умножением на 3; выпиши просмотры по дням, начиная с 5 в первый день.
4.4. Ответ: 121 клетка.
к условию4.5. Ответ: на 15-й странице.
к условию4.6. Ответ: 41-м.
Подсказка: обратная задача – сначала число прыжков , а номер на единицу больше.
4.7. Ответ: .
к условию4.8. Ответ: 10 минут.
к условию4.9. Ответ: 1 – Б, 2 – Г, 3 – А, 4 – В.
Подсказка: «удвоенная сумма» – сначала сложить, потом удвоить, поэтому нужны скобки; проверь выражения на .
4.10. Ответ: 27.
Подсказка: сначала оба умножения, потом вычитание.
4.11. Ответ: через 10 минут.
Подсказка: здесь дано сразу – это температура в начале, 20 °C.
4.12. Ответ: 21 апреля.
Подсказка: с 1 по 6 апреля прошло 5 дней, а не 6; в ответе – число месяца, а не число дней таяния.
4.13. Ответ: а) ; б) 44 л; в) +3 л (модель занизила).
к условию4.14. Ответ: а) ; б) на 12-й; в) −2 с (модель завысила).
Подсказка: время круга уменьшается, поэтому отрицательный; вопрос б) – это уравнение .
4.15. Ответ: 1,25 мин.
к условию4.16. Ответ: а) А – 0,5 мин, Б – 2 мин; б) модель А; в) 50 мин.
Подсказка: если сложить ошибки со знаком, у обеих моделей выйдет по 0,5 мин – знак отбрасывают до сложения.
4.17. Ответ: а) 15 деталей; б) в мастерской А, на 70 ₽.
к условию4.18. Ответ: 25 минут.
Подсказка: у тарифа Б старт бесплатный, его цена – просто .
К главе 5. Данные: собираем и наводим порядок
5.1. Ответ: 1А, 2Б, 3В, 4Г.
к условию5.2. Ответ: 1Г, 2В, 3Б, 4А.
к условию5.3. Ответ: 2 – «Температура» и «Скорость ветра».
к условию5.4. Ответ: первой окажется 03.11.2026, а самая ранняя – 15.09.2026.
Подсказка: текст сравнивается знак за знаком слева, а первым в такой дате стоит день, а не год.
5.5. Ответ: сначала Марат, потом 3.
5.6. Ответ: 30 записей, по 3 запятые.
Подсказка: первая строка файла – заголовок, а не запись.
5.7. Ответ: 14 страниц, на последней 70 записей.
к условию5.8. Ответ: а) 3 параметра; б) с 101-й по 150-ю запись.
Подсказка: страница начинается с записи и кончается записью .
5.9. Ответ: соберёт 2200, потеряет 150.
Подсказка: range(1, 12) перебирает страницы только с 1-й по 11-ю, а их нужно 12.
5.10. Ответ: на 13,7 мин.
Подсказка: найди два средних – с выбросом и без него – и вычти одно из другого.
5.11. Ответ: 32 строки.
Подсказка: копия строки с пропуском уходит вместе с остальными копиями – не вычитай её второй раз.
5.12. Ответ: 29 400 и 21 600.
Подсказка: сначала вычти удалённые строки и столбцы, потом умножай.
5.13. Ответ: в среднем 6 задач; больше 5 задач решили двое.
Подсказка: «больше 5» – значит 6 и выше, ровно 5 не подходит.
5.14. Ответ: команда Д.
Подсказка: две команды с равной высотой занимают два места подряд, а не одно.
5.15. Ответ: а) «Пирожок», 22 шт.; б) чай, 28 шт.
к условию5.16. Ответ: а) 7; б) 6А, 46 кг; в) 5В, 14,3 кг.
Подсказка: в «6 А» пробел стоит посередине, и strip его не уберёт – пробелы надо убрать все. Лидер по сумме и лидер по среднему здесь разные.
К главе 6. Графики и анализ данных
6.1. Ответ: а) 3 месяца; б) одинаково, в обоих 10 °C.
Подсказка: март (−8) и ноябрь (−7) не подходят: они теплее −10.
6.2. Ответ: 10; 130.
к условию6.3. Ответ: 1 – Б, 2 – В, 3 – Г, 4 – А.
к условию6.4. Ответ: круговая – для первого опроса; для второго – столбчатая.
Подсказка: сложи проценты: в первом опросе вышло 100 %, во втором 165 % – ответы пересекались.
6.5. Ответ: а) «Космос»; б) «ИИ»; в) «Космос».
к условию6.6. Ответ: 5 книг.
Подсказка: сначала найди, сколько книг прочитал каждый класс целиком. Ответ 5,5 – ловушка: классы разного размера.
6.7. Ответ: Г6.
к условию6.8. Ответ: а) 60 учеников; б) 108°.
Подсказка: угол 90° – это четверть круга (360°), а 30 % – доля от 360°.
6.9. Ответ: а) в 2 раза; б) в 1,07 раза.
к условию6.10. Ответ: а) между февралём и мартом (+600); б) на 27 %.
Подсказка: проценты считай от апреля – от того, что было до изменения.
6.11. Ответ: среднее 23 см, медиана 20 см, размах 27 см.
к условию6.12. Ответ: медиана 13,5 мин, среднее 17 мин.
Подсказка: чисел восемь – чётное количество, медиана равна среднему двух средних чисел.
6.13. Ответ: 18 баллов.
Подсказка: иди от сумм: сумма = среднее · количество, было , стало .
6.14. Ответ: А.
Подсказка: время бега уменьшается – значит, бегают быстрее.
6.15. Ответ: 2 и 4.
к условиюК главе 7. Нейросети своими руками
7.1. Ответ: 25.
к условию7.2. Ответ: 90; 103.
Подсказка: связи считай для каждой пары соседних слоёв – их тут три; смещения есть у всех нейронов, кроме входов.
7.3. Ответ: а) 14; б) 12.
Подсказка: обозначь число нейронов скрытого слоя буквой : связей ; во втором пункте не забудь связи между двумя скрытыми слоями, .
7.4. Ответ: 0; 0; 2,5.
Подсказка: ноль не отрицательный – ReLU оставляет его нулём.
7.5. Ответ: 5.
к условию7.6. Ответ: 40; 31.
к условию7.7. Ответ: ВНВВН.
Подсказка: в пункте 5 связи перемножают, а не складывают.
7.8. Ответ: 144; 5; 2980.
Подсказка: каждый пиксель – отдельный вход, поэтому входов , а не .
7.9. Ответ: ВБА.
Подсказка: картинка 8 × 8 – это 64 входа, а не 8.
7.10. Ответ: 150; 50.
Подсказка: в а) сложи, сколько не хватает каждому из двух меньших классов.
7.11. Ответ: Б.
Подсказка: найди, чем все фото лис отличаются от всех фото собак, кроме самих зверей.
7.12. Ответ: БГВАД.
Подсказка: проверять можно только обученную модель, а выгружать – только проверенную.
7.13. Ответ: 6000.
Подсказка: за одну эпоху поправок столько же, сколько примеров.
7.14. Ответ: 3,8.
к условию7.15. Ответ: 2,92.
Подсказка: во второй эпохе ответ модели уже больше верного: ошибка отрицательная, и вес уменьшается.
7.16. Ответ: 0111.
к условию7.17. Ответ: 1001.
Подсказка: порог выхода 0 – ступенька отвечает 1 уже при сумме 0.
К главе 8. Python, диалоги и промпты
8.1. Ответ: 8 12.
8.2. Ответ: 34, 7, лалала.
8.3. Ответ: программа напечатает 4 10; заказать нужно 5 микроавтобусов.
Подсказка: // – сколько автобусов заполнятся целиком, % – сколько человек осталось; их тоже надо везти, поэтому округляем вверх.
8.4. Ответ: серебряный значок.
Подсказка: из цепочки if – elif – else выполняется только первая верная ветка – дальше проверки не идут.
8.5. Ответ: 30.
8.6. Ответ: 7 430.
Подсказка: while проверяет условие перед кругом: при 390 условие ещё верно, и цикл делает ещё один круг.
8.7. Ответ: 20 50 5 и 210.
Подсказка: номера в списке начинаются с нуля, поэтому a[1] – второй элемент.
8.8. Ответ: 13 А о 3.
Подсказка: count("о") ищет только букву «о»: «А» и «а» в начале слова – другая буква.
8.9. Ответ: «меню».
Подсказка: slovo in fraza ищет кусочек, а не целое слово, – ключевое «есть» спряталось внутри «шесть».
8.10. Ответ: 3 6 5.
8.11. Ответ: 4 5 3.
Подсказка: здесь длина – переходы, их в каждой ветке на один меньше, чем реплик.
8.12. Ответ: контекста (часть «контекст и роль»).
Подсказка: роль («тренер»), цель и формат в промпте есть, а о самом Диме – ни слова: ни возраста, ни опыта. Это и есть контекст – что нейросеть должна знать о тебе. Запрет «не больше 30 минут в день» тоже помог бы, но нейросеть ошиблась потому, что вообще не знала, для кого план.
8.13. Ответ: а) А – формат результата, Б – цель, В – контекст и роль, Г – исходные данные и детали, Д – инструменты и ограничения; б) А.
к условию8.14. Ответ: 6 4.
8.15. Ответ: 6 2.
Подсказка: сначала посчитай ветки через 7 (пути до 7 умножить на пути от 7 до конца) и вычти их из всех веток.
8.16. Ответ: 84 %.
Подсказка: в условии дано число ошибок, а точность – доля верных ответов.
8.17. Ответ: а) 0; б) −7; в) строка 2: maks = temp[0].
Подсказка: все температуры ниже нуля – посмотри, с какого числа начинается maks.
Справочник
Всё, что может понадобиться под рукой во время решения: формулы и правила из глав, мини-шпаргалка по Python, словарик слов из мира ИИ и все «Запомни» из глав на нескольких страницах.
Формулы и правила
Если в условии задачи на отборе правило записано по-своему, решай по условию.
Множества и логика
– число элементов в множестве . Знак читается «или» (хотя бы в одном из множеств), знак – «и» (в обоих сразу).
Хотя бы в одном из двух (формула включений и исключений):
На робототехнику ходят 18 человек, на шахматы 15, на оба кружка 7. Хотя бы в один кружок ходят .
В обоих сразу, если известно, сколько хотя бы в одном:
Книг про космос 12, про роботов 9, хотя бы про что-то одно из двух – 17. Про то и другое сразу: .
Ни в одном: из всех вычесть тех, кто хотя бы в одном. В классе 30 человек, значит, ни в один кружок не ходят .
Хотя бы в одном из трёх:
Общую часть всех трёх сначала трижды прибавили, потом трижды вычли – поэтому в конце прибавляем её ещё раз.
Логические связки: «истина» – 1, «ложь» – 0.
| И | ИЛИ | НЕ | ||
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 1 | 1 | 1 | 0 |
«И» истинно, только когда верны оба. «ИЛИ» ложно, только когда неверны оба. В Python это and, or, not.
Комбинаторика
| Правило | Формула | Пример |
|---|---|---|
| Правило умножения: выбираем по шагам, на каждом шаге свой выбор | 3 каши, 2 напитка, 4 булочки: разных завтрака | |
| Правило сложения: выбираем что-то одно из разных групп | 5 комедий или 3 мультфильма: вариантов на вечер | |
| Перестановки: сколькими способами выстроить предметов в ряд | 4 робота в очередь на зарядку: | |
| Выбор по порядку: мест из участников | ( множителей) | 1, 2 и 3 место из 10 команд: |
| Пары, где порядок не важен | 5 человек пожали друг другу руки: рукопожатий |
Вероятность
где – число подходящих исходов, – число всех равновозможных исходов.
| Правило | Формула | Пример |
|---|---|---|
| Вероятность всегда от 0 до 1 | 0 – не бывает никогда, 1 – бывает всегда | |
| Выпадет чётное на кубике | ||
| Событие не случится | если , то «не случится» | |
| Оба независимых события сразу | две монеты, обе орлом: , то есть 25 % |
Дробь в проценты: умножь на 100. .
Последовательности, уравнения, проценты
Арифметическая прогрессия – каждый раз прибавляем одно и то же число :
Ряд 5, 8, 11, …: , десятый член .
Сумма первых членов арифметической прогрессии:
.
Геометрическая прогрессия – каждый раз умножаем на одно и то же число :
Ряд 3, 6, 12, …: , шестой член .
Линейное уравнение:
: . Проверка: .
Проценты. процентов от числа : . 15 % от 600: . Какую часть составляет от : . 12 из 48: .
Среднее, медиана и другие
| Что | Как найти |
|---|---|
| Среднее арифметическое | сложить все значения и разделить на их количество |
| Медиана | упорядочить по возрастанию и взять число посередине; если чисел чётное количество – среднее двух средних |
| Мода | значение, которое встречается чаще всех |
| Размах | наибольшее минус наименьшее |
Пример. Ряд 3, 7, 8, 12, 40. Среднее: . Медиана: 8. Размах: . Для ряда 3, 7, 8, 12 медиана .
Совет. Одно странное значение (выброс) сильно тянет среднее за собой, а медиану почти не трогает. В примере выше среднее 14 больше четырёх чисел из пяти – всё из-за числа 40. Если в данных есть выбросы, смотри на медиану.
Насколько хороша модель
Точность (accuracy) – для задач классификации, где ответ «кошка» или «собака»:
Модель верно узнала 45 картинок из 50: .
Ошибка прогноза – для регрессии, где модель предсказывает число. Для каждого примера берём разницу между прогнозом и настоящим значением без знака минус. Средняя абсолютная ошибка (MAE) – среднее этих разниц. Средний квадрат ошибки (MSE) – среднее их квадратов.
| Настоящее значение | Прогноз | Разница без знака | Квадрат разницы |
|---|---|---|---|
| 10 | 11 | 1 | 1 |
| 12 | 12 | 0 | 0 |
| 15 | 13 | 2 | 4 |
, . У точности лучше та модель, у которой число больше, у ошибки – та, у которой меньше.
Обучающая и тестовая выборки. Данные делят на две части: на одной модель учится, на другой её проверяют. Часто делят в пропорции 80 на 20: из 200 строк 160 идут на обучение, 40 – на проверку.
Как составить промпт
В программе сферы хороший запрос к нейросети состоит из пяти частей:
| Часть | Что написать | Пример |
|---|---|---|
| Контекст и роль | кем быть нейросети и что она должна знать о тебе | «Ты – учитель информатики для шестиклассников. Я готовлюсь к олимпиаде.» |
| Цель | что именно сделать | «Объясни, что такое медиана, и дай 3 задачи.» |
| Исходные данные и детали | с чем работать, важные подробности | «Вот мои числа: 4, 9, 2, 7, 5.» |
| Инструменты и ограничения | чем можно пользоваться, чего нельзя | «Без формул с буквами, только счёт по порядку.» |
| Формат результата | в каком виде нужен ответ | «Коротко, до 10 строк, ответы к задачам – в конце.» |
Мини-шпаргалка Python
Всё ниже работает в любом онлайн-интерпретаторе Python 3. После # идёт комментарий: Python его не читает.
Вывод и переменные
name = "Аня"                  # строка – в кавычках
age = 12                      # целое число
print("Привет,", name)        # Привет, Аня
print(f"{name} через год будет {age + 1}")   # Аня через год будет 13
Арифметика
print(7 / 2)     # 3.5 – обычное деление
print(7 // 2)    # 3 – целая часть от деления
print(7 % 2)     # 1 – остаток от деления
print(2 ** 10)   # 1024 – степень
print(round(3.14159, 2))   # 3.14 – округлить до сотых
Условие
t = -25
if t < -30:
    print("сиди дома")
elif t < 0:
    print("мороз, шапку!")
else:
    print("тепло")
Циклы
for i in range(1, 4):   # i = 1, 2, 3 (до 4, но не включая 4)
    print(i)

n = 1
while n < 100:          # повторяем, пока условие верно
    n = n * 2
print(n)                # 128
Списки
marks = [5, 4, 5, 3, 5]
marks.append(4)                 # добавить в конец
print(len(marks))               # 6 – сколько элементов
print(sum(marks), max(marks), min(marks))   # 26 5 3
print(sum(marks) / len(marks))  # среднее
print(sorted(marks))            # [3, 4, 4, 5, 5, 5]
print(marks[0], marks[-1])      # 5 4 – первый и последний
print(marks.count(5))           # 3 – сколько раз встречается 5
Строки
s = "Нейросеть учится на данных"
print(len(s))            # 26 – длина вместе с пробелами
print(s.lower())         # все буквы маленькие
print(s.split())         # ['Нейросеть', 'учится', 'на', 'данных']
print("данных" in s)     # True – есть ли такое слово
Словарь и функция
pets = {"кошка": 12, "собака": 9}   # ключ: значение
pets["хомяк"] = 3
for k, v in pets.items():
    print(k, v)

def accuracy(right, total):
    return right / total * 100

print(accuracy(45, 50))   # 90.0
Таблицы и графики (библиотеки pandas и matplotlib в Colab уже есть, в простом онлайн-интерпретаторе их может не быть)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.DataFrame({"месяц": ["янв", "фев", "мар"], "снег_см": [45, 60, 38]})
# или из файла: df = pd.read_csv("data.csv")
print(df.shape)                      # (3, 2) – строк и столбцов
print(df["снег_см"].mean())          # среднее по столбцу
print(df["снег_см"].median())        # медиана
print(df[df["снег_см"] > 40])        # только строки, где снега больше 40 см

plt.bar(df["месяц"], df["снег_см"])  # столбчатая диаграмма
plt.title("Высота снега")
plt.show()
Совет. Пять ошибок, на которых спотыкаются чаще всего: = кладёт значение в переменную, а == сравнивает; range(1, 10) доходит только до 9; номера в списке начинаются с 0; после if, for, while и def нужно двоеточие и отступ в 4 пробела; дробные числа пишутся через точку: 2.5.
Словарик
| Слово | Что значит |
|---|---|
| Алгоритм | точная последовательность шагов, которая приводит к результату |
| API | «окошко» сайта для программ: программа отправляет запрос по адресу и получает данные, часто в формате JSON |
| Вайбкодинг | способ писать программы, когда код по твоему описанию словами пишет нейросеть, а ты проверяешь и поправляешь |
| Вес | число при входе нейрона: насколько этот вход важен. При обучении веса подбираются сами |
| Выброс | значение, резко не похожее на остальные: рост ученика 5 метров, возраст 150 лет |
| Выборка обучающая и тестовая | на обучающей модель учится, на тестовой её проверяют. Тестовые примеры модель до проверки не видит |
| Галлюцинация нейросети | уверенный, гладкий, но выдуманный ответ. Поэтому ответы нейросети всегда проверяют |
| Гиперпараметр | настройка, которую человек выбирает до обучения: число эпох, скорость обучения, число слоёв и нейронов |
| Гипотеза | предположение, которое проверяют по данным: «зимой в библиотеке берут больше книг» |
| Дашборд | один экран, на котором собраны несколько графиков и главные числа |
| Данные категориальные | значения-названия: цвет, порода, город. Их сравнивают, но не складывают |
| Данные количественные | значения-числа: рост, цена, температура. С ними можно считать |
| Датасет (набор данных) | таблица с примерами, на которых учат и проверяют модель |
| Искусственный интеллект (ИИ) | программы, которые решают задачи, где человеку пришлось бы подумать: узнать предмет на фото, понять вопрос, сделать прогноз |
| Классификация | задача «к какому классу относится»: кошка или собака, спам или не спам |
| Кластеризация | задача «разбей на группы похожих», когда заранее неизвестно, какие будут группы |
| Малокодовая система (low-code) | инструмент, где модель или программу собирают мышкой из блоков, почти без кода |
| Машинное обучение | способ сделать ИИ: правила программе не пишут, а показывают много примеров, и она сама находит закономерность |
| Метрика | число, по которому человек оценивает модель: точность, средняя ошибка |
| Модель | то, что получилось после обучения: программа, которая по входным данным выдаёт ответ |
| Нейрон (искусственный) | маленький вычислитель: умножает каждый вход на свой вес, складывает и пропускает через функцию активации |
| Нейросеть | много нейронов, соединённых слоями: входной слой получает данные, скрытые слои их обрабатывают, выходной выдаёт ответ |
| Переобучение | модель «вызубрила» обучающие примеры и плохо работает на новых |
| Признак | то, по чему модель делает вывод; в таблице это столбец: рост, вес, цвет |
| Промпт | запрос к нейросети словами |
| Пропуск | пустая клетка в таблице: значение не записали |
| Регрессия | задача «предскажи число»: температура завтра, цена квартиры |
| Скорость обучения | гиперпараметр: насколько сильно меняются веса за один шаг обучения |
| Функция активации | правило, по которому нейрон решает, что передать дальше |
| Функция потерь | число, которое показывает, насколько модель ошибается. Обучение – это уменьшение потерь |
| Целевая переменная | то, что модель должна угадать: порода, цена, «спам или нет» |
| Чат-бот | программа, которая ведёт диалог с человеком |
| Эпоха | один проход обучения по всей обучающей выборке |
| CSV | таблица, записанная как текст: одна строка – одна запись, значения через запятую или точку с запятой |
| JSON | формат данных в фигурных скобках, пары «ключ: значение». Так отвечают многие API |
Шпаргалка: всё «Запомни» из глав
Глава 1. Что такое искусственный интеллект
Запомни. ИИ – программы для задач, где человеку нужен интеллект. Машинное обучение – та часть ИИ, которая учится на примерах, а нейросети – часть машинного обучения. Если программа только выполняет правила, записанные человеком (звонок, калькулятор, светофор по таймеру), – это не ИИ.
Запомни. Строка таблицы – объект. Столбцы, по которым угадываем, – признаки, а столбец, который надо угадать, – ответ (целевая переменная). Номера и фамилии, которые лишь называют строку, – не признаки: перед обучением их удаляют вместе с ответом.
Запомни. Готовые группы и ответы в примерах – классификация. Число – регрессия. Ответов нет, ищем группы сами – кластеризация. Первым делом смотри, что должно получиться на выходе.
Запомни. Обучающая выборка – учимся, проверочная – сдаём экзамен. Проверочные примеры модель при обучении не видит. Точность, которой можно верить, – только на проверочной выборке.
Запомни. Нейрон: умножь каждый вход на его вес, сложи, сравни сумму с порогом. – выход 1, иначе 0. Отрицательный вес работает «против». Обучение – это подбор весов.
Запомни. Точность = верных : всего · 100 %. Доля ошибок = 100 % − точность. Считаем на проверочной выборке. Для регрессии – средняя ошибка: насколько в среднем промахнулись, без учёта знака.
Глава 2. Множества и логика
Запомни. Множество – набор без повторов, порядок в нём не важен. – сколько в нём элементов. Подмножество – часть, все элементы которой есть в большом множестве.
Запомни. – «и то, и другое», – «хотя бы одно», «, но не » – круг без общей части, «не » – всё за пределами круга . Одно понятие может занимать и один кусочек картинки, и несколько.
Запомни. Хотя бы в одном = . Ни в одном = все минус хотя бы в одном. Для трёх кругов заполняй кусочки от центра наружу, а в конце проверь сумму формулой.
Запомни. И – истина, только если истинны оба. ИЛИ – ложь, только если ложны оба. НЕ – наоборот. Порядок: скобки, НЕ, И, ИЛИ. Для высказываний в таблице истинности строк: 4, 8, 16…
Запомни. & – И – пересечение: найдётся меньше. | – ИЛИ – объединение: найдётся больше. Пересечение по трём числам: .
Глава 3. Комбинаторика и вероятность
Запомни. Выбор по шагам – перемножаем, сколько вариантов на каждом шаге: . Так можно, только если число вариантов на шаге не зависит от того, что выбрали раньше.
Запомни. «И» – берём по варианту на каждом шаге – умножаем. «Или» – берём одно из нескольких групп – складываем. Если у групп есть общие элементы, общее вычитаем один раз.
Запомни. Расставляем по местам: на каждое следующее место вариантов на один меньше. Все предметов в ряд – . Пары, где порядок не важен, – .
Запомни. , и все исходы должны быть равновозможными. . «Не случится» – . У двух монет 4 исхода, у двух кубиков – 36: каждую монету и каждый кубик считай отдельно.
Запомни. Вероятность – сколько должно выходить в среднем, частота – сколько вышло в нашем опыте. На малом числе опытов они могут сильно различаться, на большом – сближаются. Ожидаемое число случаев = .
Запомни. Проценты модели – её оценка, а не факт про один снимок. Честность модели проверяют на многих ответах: из тех, где она «уверена на 80 %», верными должны оказаться около 80 из 100. Вероятность фразы из нескольких слов – произведение вероятностей вдоль её ветки дерева.
Глава 4. Закономерности, последовательности, уравнения
Запомни. Порядок поиска: разности, отношения, разности разностей, знакомые ряды, два ряда вперемешку. Правило, которое подходит к первым двум числам, но не подходит к третьему, – не правило.
Запомни. : прыжков на один меньше, чем номер. Номер по числу – это (число − первый член) : шаг, и к результату прибавить 1. Не делится нацело – такого числа в ряду нет. В геометрической прогрессии вместо прибавления – умножение: .
Запомни. Переменная – место для числа. Подставил – посчитал в порядке: скобки, умножение и деление, сложение и вычитание. «На …» – это плюс или минус, «в … раз» – умножение или деление.
Запомни. Что делаешь с одной частью уравнения, делай и с другой. Действия с x снимаем в обратном порядке. Корень всегда проверяй подстановкой.
Запомни. : – прибавка на каждую единицу (со знаком), – значение при . . Прогноз – подставить . «Когда станет…» – решить уравнение.
Запомни. Ошибка = настоящее − прогноз: плюс – модель занизила, минус – завысила. Две модели сравнивают по средней ошибке без знака – у кого она меньше, та и лучше. Одна странная точка – не повод гнуть прямую, а далеко за краем облака прямой не верь.
Глава 5. Данные: собираем и наводим порядок
Запомни. Строка – объект, столбец – признак (свойство), клетка – одно значение. Строка заголовка – не запись. Число клеток = число строк · число столбцов.
Запомни. Количественные данные можно складывать и усреднять, категориальные – только сравнивать и пересчитывать. Цифры в номере, шифре, индексе – это ярлык, а не количество. Числа из файла сначала переведи из текста в число.
Запомни. CSV: первая строка – заголовок, записей на одну меньше, чем строк; запятых в строке на одну меньше, чем столбцов. JSON: {} – карточка с ключами, [] – список, счёт в списке с нуля.
Запомни. Страниц = всего : на странице, с округлением вверх. На последней = всего − (страниц − 1) · на странице. В цикле range(1, N + 1): последнее число в range не входит.
Запомни. Четыре беды: пропуск, дубликат, опечатка, выброс. Пропуск не превращай в ноль. Для компьютера «Бердск» и «бердск» – разные слова. Сначала чистка, потом подсчёт.
Запомни. Фильтр – оставить строки по условию, сортировка – расставить по столбцу, подсчёт – свернуть в число: количество, сумма, среднее, максимум, минимум, количество уникальных. «Сумма по группе» и «среднее по группе» – разные вопросы.
Глава 6. Графики и анализ данных
Запомни. Сравнить – столбики. Время – линия. Доли одного целого – круг. Две величины у каждого объекта – точки.
Запомни. Сначала подписи, потом картинка: что по осям, в каких единицах, с какого числа начинается ось. Цена деления – разница соседних подписей, делённая на число промежутков между ними.
Запомни. Медиана – середина упорядоченного ряда; при чётном количестве – среднее двух средних. Выброс тянет среднее и почти не трогает медиану. Сумма, среднее, максимум по группам – разные вопросы и разные ответы.
Запомни. Гипотеза – конкретная догадка, которую можно проверить таблицей. Точки полосой вверх или вниз – связь есть, кашей – не видно. Связь не доказывает, что одно вызывает другое.
Запомни. Перед сравнением столбиков посмотри, с какого числа начинается ось. Сравнивай сами числа, а не высоту картинки: во сколько раз – делением, на сколько процентов – от того значения, с которым сравниваешь.
Запомни. Дашборд – главное на одном экране: плитки с числами и несколько графиков. Эссе – вопрос, данные, график, вывод с числами и оговорки. Вывод без чисел – это мнение, а не вывод.
Глава 7. Нейросети своими руками
Запомни. Связи между соседними слоями = произведение числа нейронов в них; связи сети – сумма по всем парам соседних слоёв. Смещения есть у каждого нейрона, кроме входов. Входов – сколько признаков, выходов – сколько классов, для числа – один выход.
Запомни. Порядок всегда один: сумма «вход · вес» по всем входам, плюс смещение, потом функция активации. Считаем слой за слоем: входами выходного нейрона служат ответы скрытых нейронов, а не исходные .
Запомни. Ошибка = верный ответ − ответ модели. Новый вес = вес + скорость · ошибка · вход. Эпоха – один проход по всем обучающим примерам. Большая скорость – ошибка скачет и растёт, маленькая – учимся медленно.
Запомни. Переобучение – на обучении точность растёт, а на проверке падает. Лучшая эпоха – та, где выше всего точность на проверке, а не на обучении. Низкая точность на обеих выборках – недообучение.
Запомни. Low-code: собрал примеры по классам → обучил → проверил на новых примерах. Классы – сопоставимо, без сильного перекоса, примеры – разные. Ответ сети – класс с наибольшей уверенностью.
Глава 8. Python, диалоги и промпты
Запомни. = кладёт значение в переменную, новое вытесняет старое. Правая часть считается целиком, а уже потом результат кладётся в коробку слева. input всегда отдаёт текст – для чисел оборачивай его в int(...).
Запомни. После if, elif, else, for, while – двоеточие, а строки внутри – с отступом. Из цепочки if – elif – else выполняется только первая подходящая ветка. range(1, 6) – это 1, 2, 3, 4, 5, без шести.
Запомни. Номера в списке и в строке начинаются с 0, последний элемент – [-1], а номер последнего равен длине минус один. Словарь ищет по ключу, ключи не повторяются. "Снег" и "снег" для Python – разные слова.
Запомни. Узел – реплика, стрелка – переход, ветка – путь от начала до конца. Длина ветки – число реплик в ней. Число веток = число у конца, если подписать у каждого узла сумму чисел узлов, из которых в него входят стрелки. Интент – намерение человека, которое бот узнаёт по фразе.
Запомни. Промпт = контекст и роль + цель + исходные данные + ограничения + формат. Чего не написал – нейросеть додумает сама. Любой ответ нейросети – черновик, пока ты его не проверил.
Запомни. Код от нейросети проверяют запуском на тестах, где ответ известен заранее. Падение программы – это подсказка, где искать. Самая опасная ошибка – когда программа работает и выдаёт правдоподобное неверное число.
Где что найти
| Что | Где |
|---|---|
| Правила олимпиады, сферы, сроки | junior.ntcontest.ru |
| Личный кабинет участника | my.ntcontest.ru |
| Курс сферы «ИИтех» (за тест курса +5 баллов к отбору) | academy.junior.online, вход через «Талант» |
| Платформа отбора | orbita.education (заходить кнопкой из личного кабинета) |
| Памятки для Новосибирской области | nto.kvantorium54.ru |
| GraphNet – как установить | teletype.in/@yupest/graphnet |
| Датавиз-конструктор – как установить | teletype.in/@irk.digitalwave/dataviz-install |
| Python и таблицы в браузере | colab.research.google.com (запускать код – с аккаунтом Google) |
| Модель на своих картинках и звуках без кода | Teachable Machine, Machine Learning for Kids |
| CodeChef – блочная программа сбора данных (инструмент курса) | codechef.ru |
| Scratch – дополнительно, не инструмент курса | scratch.mit.edu |
| ИИ-чаты из программы сферы | GigaChat, Алиса – вместе со взрослым |
Об авторе-составителе
Артём Осиновский
Методист и разработчик детского технопарка «Кванториум» (Новосибирск). Придумывает образовательные программы и сам делает для них цифровые инструменты: платформу смены «Миссия на Луну» для фестиваля «Технопром-2026», сайт с памятками НТО Юниоры для Новосибирской области. Эту книгу собрал для школьников области, чтобы к отбору можно было подготовиться самостоятельно – даже без кружка рядом с домом.
Нашли ошибку – пишите на osinovsky.aa@kvantorium54.ru (рабочая почта): сфера, версия книги и страница. По другим вопросам и проектам – личная: artem081033@gmail.com.